如何获取 URL 参数:原生 API、工具库与路由的选型
打开详情页,要知道展示哪条记录;进入活动页,要知道用户从哪个入口过来;登录完成,还要回到之前的页面。把这些信息放进 URL,链接就能携带上下文,复制给别人、刷新页面或在新标签中打开时,目标页面仍然知道该做什么。从 URL 里读取参数,是前端开发里再普通不过的一件事。
读取这些参数,可以用浏览器原生的 URLSearchParams,也可以用 qs、query-string 或 ufo 这样的工具库。Node.js 有自己的 querystring,路由库通常也会直接提供 query 对象。只读一个 id 时,它们似乎都能解决问题;换一个稍复杂的地址,差别就出现了。
比如,同一个 id 出现两次该取哪一个??debug 和 ?debug= 是否一样?filter[status] 是普通参数名,还是嵌套对象?获取参数的代码很短,选型却取决于这些代码背后的约定。
版本相关的判断核对于 2026-10-18:qs@6.16.1、query-string@9.5.1、ufo@1.6.4、vue-router@5.4.0。行为与构建实验使用 Node.js 26.12.0;旧项目的行为应以锁定版本为准。
URL 的哪一部分才是参数
一条 URL 可以同时包含路径参数、查询参数和片段。例如:
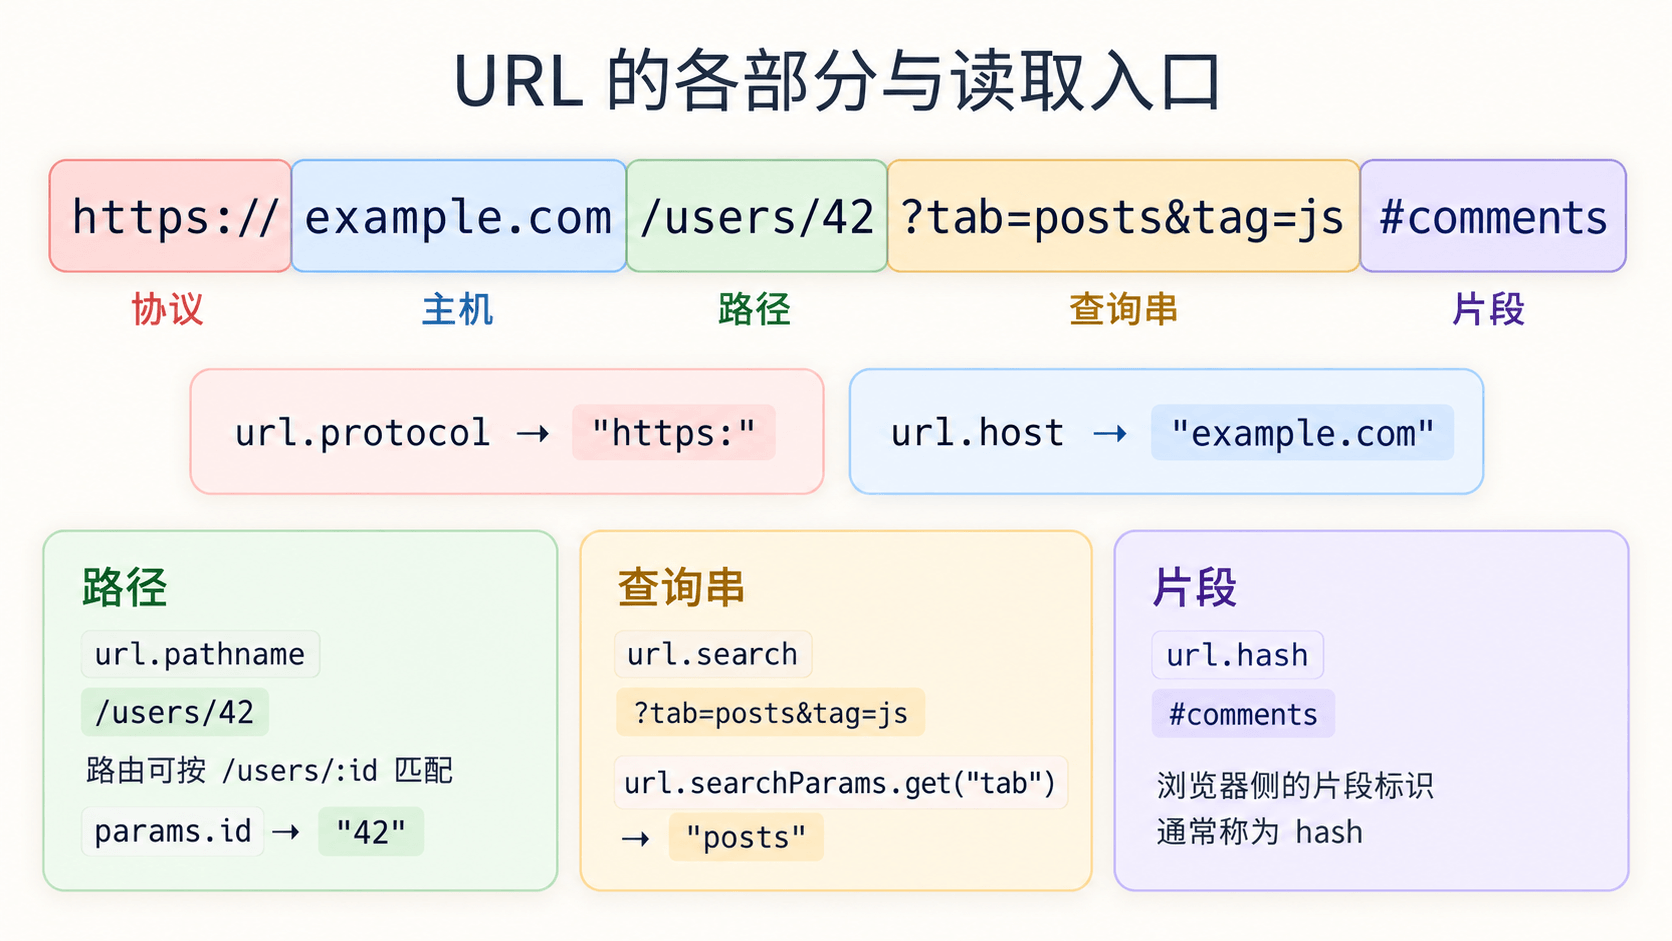
/users/42 是路径,路由库可以按 /users/:id 匹配出 params.id;?tab=posts&tag=js 是 query;#comments 是 fragment,浏览器中通常叫 hash。三者的提取规则各不相同。
URL 负责拆完整地址,URLSearchParams 负责按表单查询串规则解析 query。对完整地址和当前页面,入口分别是:
const url = new URL('https://example.com/users/42?tab=posts&tag=js#comments');
url.searchParams.get('tab'); // 'posts'

const params = new URLSearchParams(window.location.search);
params.get('tab'); // 当前页面查询串中的 tab

const relative = new URL('/search?q=vue', 'https://example.com');
relative.searchParams.get('q'); // 'vue'
相对地址需要一个 base;SSR 或服务端代码应传入请求 URL 和可信 base,不能直接读取 window。new URLSearchParams(fullUrl) 则不会先识别完整 URL,它会把传入字符串直接当查询串解析。这两个构造器的职责可以在 URL 标准的 API 定义中对照。
Query 通常按
key=value&key=value使用,但 URL 的通用表示并没有替业务定义「某个字段只能出现一次」「方括号表示对象」或「数字串应转成数字」。URLSearchParams采用的application/x-www-form-urlencoded规则,提供的是名称与值的列表。
还有一个容易读错入口的地址:
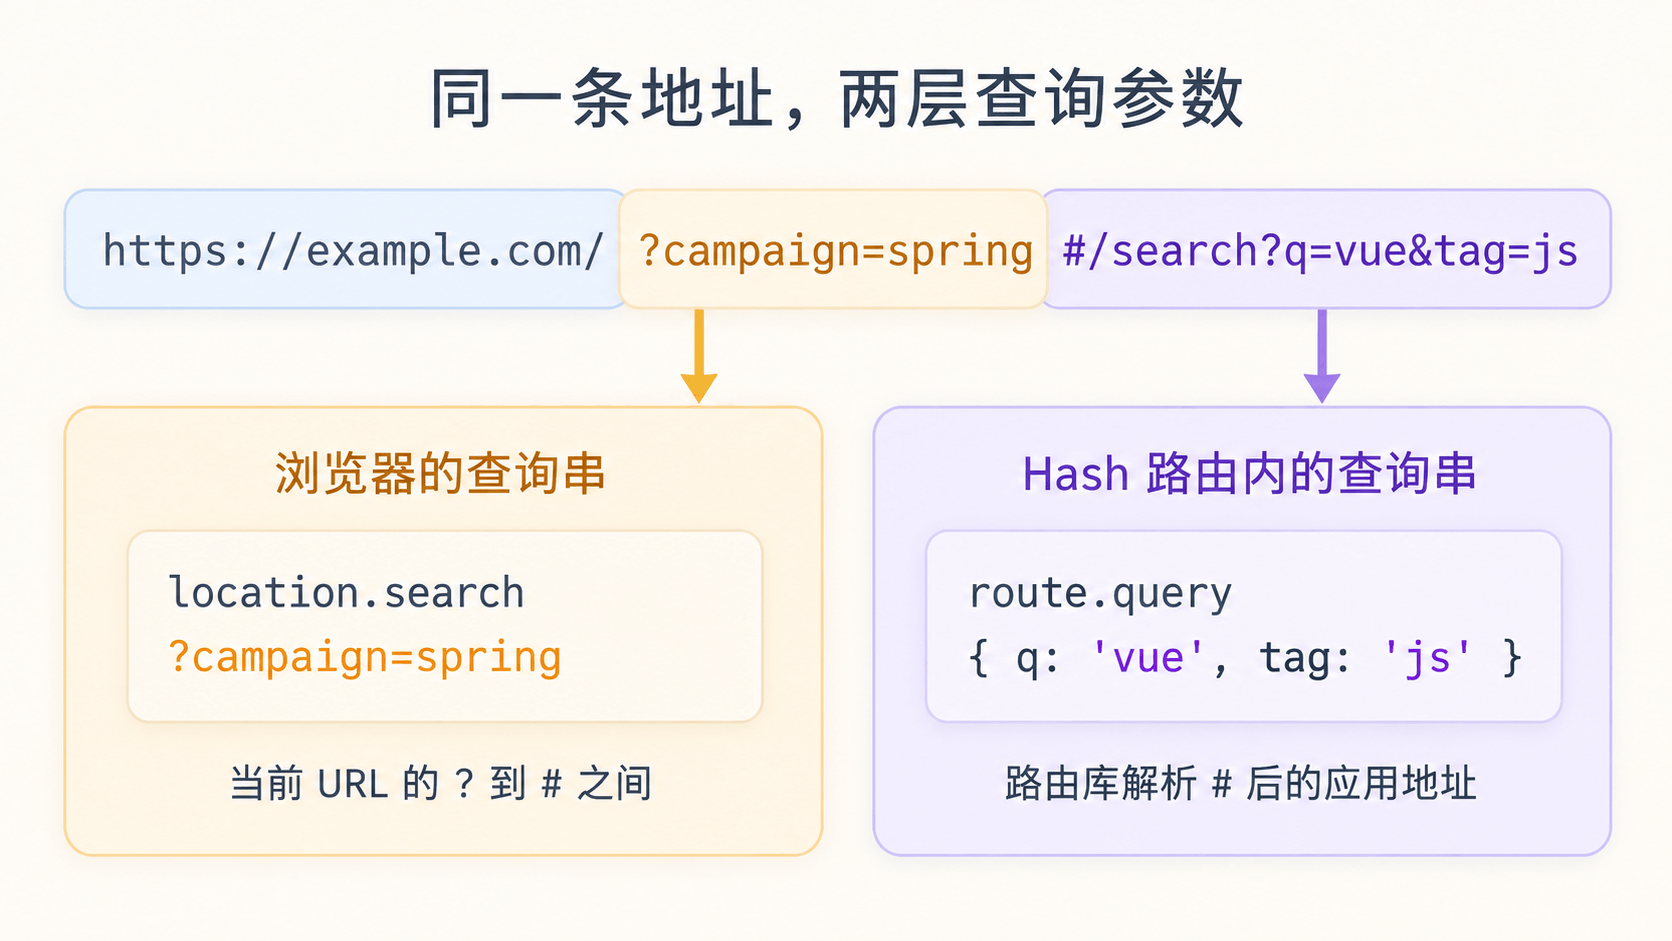
这里 location.search 只有 ?campaign=spring;q 在 fragment 中。Hash 路由会把 #/search?q=vue&tag=js 当应用路由处理,所以当前页面的业务参数应从路由对象读取。手动切 location.href 中第一个 ?,会把两个层次混在一起。Vue Router 的 history 模式说明给出了两种地址组织方式。
重复 key:解析器保留数据,业务决定含义
查询参数更接近一个有序的键值对列表。它允许同名字段出现多次,也允许不同字段交错出现:
const params = new URLSearchParams('tag=js&page=2&tag=ts');

params.get('tag'); // 'js':第一个值
params.getAll('tag'); // ['js', 'ts']:全部值,保留出现顺序
params.get('missing'); // null
params.getAll('missing'); // []

Object.fromEntries(params); // { tag: 'ts', page: '2' }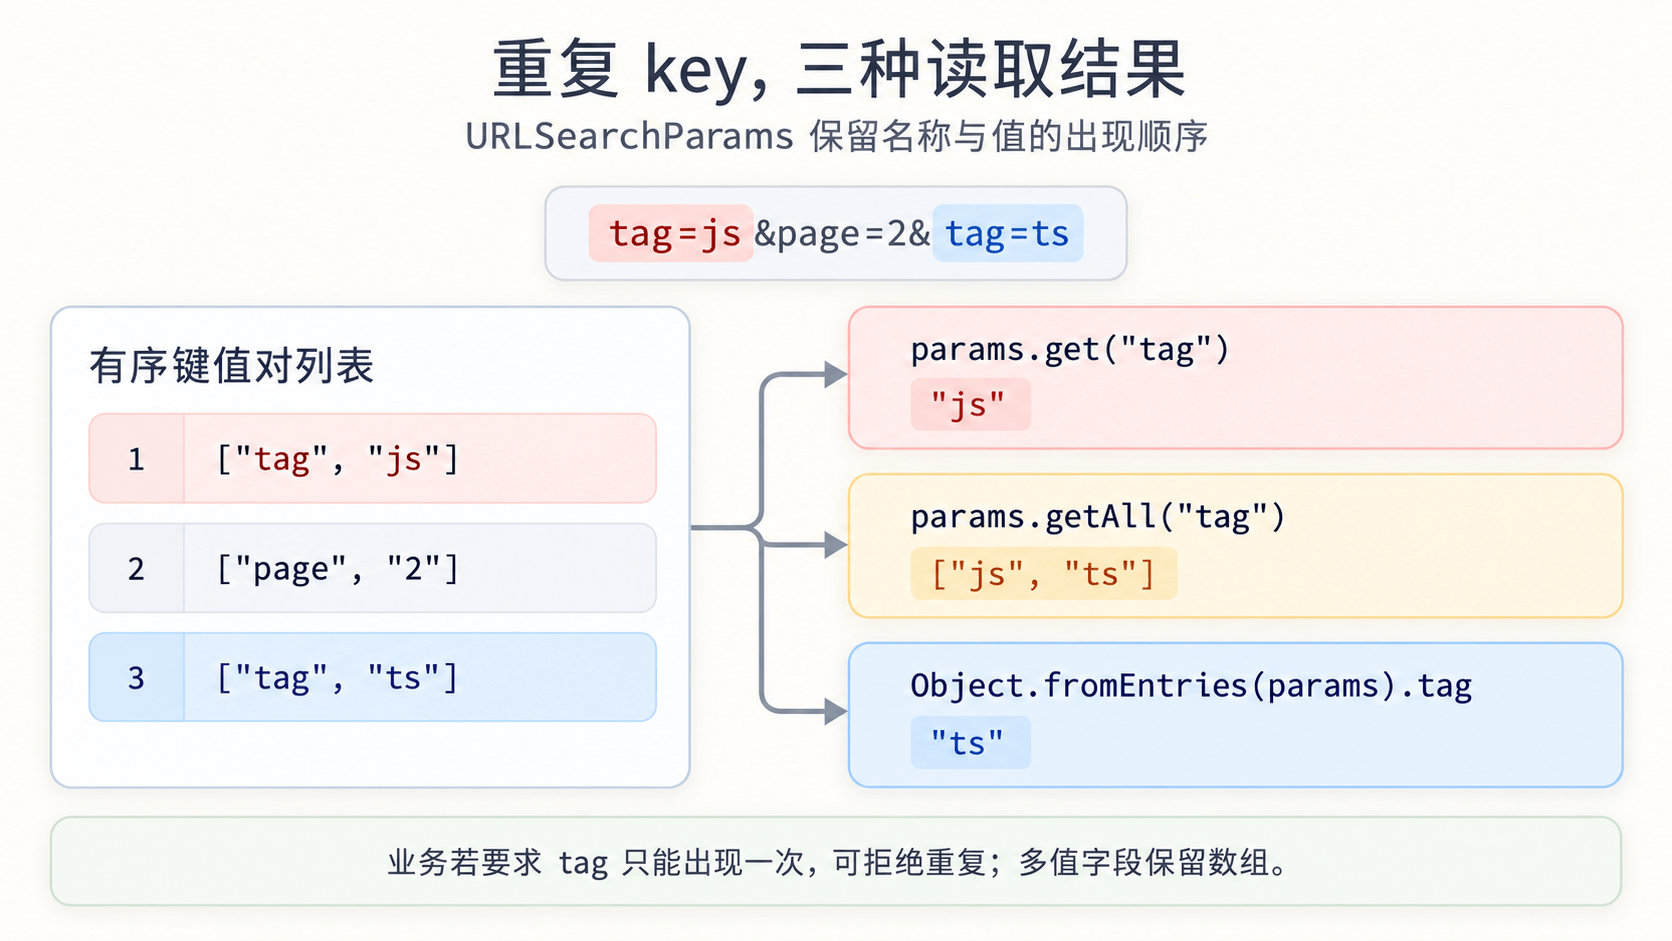
get() 返回第一个值,是标准定义的读取规则;Object.fromEntries() 遇到重名属性会被后一个值覆盖。两种写法处理的是同一份数据,却静默选择了不同结果。把 query 转成普通对象以后,也无法完整恢复不同 key 交错出现的原始顺序。get / getAll 的标准算法明确保留了这种区别。
因此,「遇到重复 key 就把 get 改成 getAll」只完成了数据保留,业务含义还没有确定。
| 参数契约 | ?key=a&key=b 的处理 |
适用条件 |
|---|---|---|
| 单值字段 | 拒绝重复 | 页码、排序方式、单个标识等只允许一个值的字段 |
| 多值字段 | 保留 ['a', 'b'] |
多选标签、多个 ID;是否去重另行约定 |
| 首值优先 | 取 'a' |
已有协议明确首个值生效 |
| 末值优先 | 取 'b' |
已有协议明确后出现的值覆盖前值 |
| 文本拼接 | 按明确协议拼接 | 消费方确实要求一段文本,而非数组 |
默认建议是单值字段拒绝重复,多值字段保留数组;首值或末值优先需要协议依据。多值也可以允许重复元素,例如排序指令的重复可能有含义,不能在通用层顺手 new Set()。
join(',') 尤其容易丢信息。?tag=a%2Cb&tag=c 表示两个值 ['a,b', 'c'],拼接以后得到 a,b,c,已经无法区分原本有几个元素。若协议真的使用逗号数组,就要同时约定元素内的逗号怎样编码和解析。
前端、服务端、代理如果对重复字段选择不同值,同一条请求就可能被解释成不同内容。校验与实际使用应遵循同一份参数契约;关键单值字段可以直接拒绝重复,避免让某个框架的默认规则替业务作决定。
编码、空值和类型转换
读到了一个值之后,还要区分它在 URL 中怎样表示,以及业务接受什么值。解析器通常只负责前一部分。
加号、百分号与重复解码
表单查询串中,原始 + 表示空格,%2B 才表示字面的加号。下面的原生结果,也与本次核对的各库默认结果一致:
const params = new URLSearchParams('q=a+b&plus=a%2Bb&escaped=%2526');
params.get('q'); // 'a b'
params.get('plus'); // 'a+b'
params.get('escaped'); // '%26'
escaped 已经完成一层解码。如果再调用 decodeURIComponent(),会把原本的文本 %26 变成 &。route.query 和各库 parse() 的值同样通常已经解码,不应再统一解码一次。标准的处理顺序见表单查询串解析算法。
构造 query 时也应交给序列化器编码原始值。例如 Base64 文本可能含 +,直接拼成 ?token=${value} 会被当成空格;params.set('token', value) 会把字面加号编码为 %2B。已经编码好的 %2B 再传给 set(),则会变成 %252B。
手写 split('&').map(x => x.split('=')) 还会碰到 value=a=b、空字段、编码后的分隔符和非法转义。为了取一两个字段维护自己的通用解析器,通常没有收益。
缺失、无等号和空字符串
这些输入并不具有同样的形态:
| 输入 | URLSearchParams |
qs 默认 |
query-string 默认 |
ufo 默认 |
Vue Router 普通路由默认 |
|---|---|---|---|---|---|
没有 flag |
get() 为 null |
对象中缺失 | 对象中缺失 | 对象中缺失 | 对象中缺失 |
?flag |
'' |
'' |
null |
'' |
null |
?flag= |
'' |
'' |
'' |
'' |
'' |
?flag=null |
'null' |
'null' |
'null' |
'null' |
'null' |
原生 API 会把无等号和空字符串折叠成同一个值。如果业务必须区分 ?flag 与 ?flag=,这一步的信息已经丢失,应选择保留该区别的解析器或调整协议。qs 可以通过 strictNullHandling: true 保留无等号形式;读写两端都要使用一致选项。
字符串不等于业务类型
?page=2&enabled=false&code=00123 默认解析出来的仍是字符串。Boolean('false') 为 true,Number('') 为 0,parseInt('2abc', 10) 为 2,都不能替代业务校验。
页码可以约定为十进制正整数,并设置范围;订单号即使全由数字组成,也可能必须保留前导零。布尔值则明确接受 'true' / 'false'、'1' / '0',还是只看字段是否出现。query-string 提供 parseNumbers、parseBooleans 等便利选项,但全局转换不知道哪些字段是编码、哪些是数量,使用前仍需核对字段语义。
非法编码的容错也有差异
同一个不完整 UTF-8 输入,解析器可能替换无效字节,也可能保留原始文本。本次实测的一个最小例子是:
输入:q=%E0%A4%A
URLSearchParams / node:querystring:q 为 "�%A"
qs / query-string / ufo / Vue Router:q 为 "%E0%A4%A"
这些结果来自对应版本的默认配置,Vue Router 开发态还给出了解码诊断。对外协议若要求拒绝非法编码,就需要额外明确校验规则;解析器能容错返回值,不代表输入已经合规。完整输入与原始结果放在行为实验数据中。
几个名字相近的工具,分别解决什么问题
qs、query-string 和 ufo 是不同项目,node:querystring 是 Node.js 内置模块。它们都提供解析与序列化,但没有一套彼此兼容的默认对象协议,也不是原生 API 的不同包装名称。
URLSearchParams:普通平面 query 的默认选择
原生 API 的优点是无需新增依赖,浏览器和 Node.js 可以使用同一种模型。重复 key 用 append() 写入,替换单值用 set();后者会移除这个 key 的其他值。
const url = new URL('/search', 'https://example.com');
url.searchParams.set('q', 'vue router');
url.searchParams.append('tag', 'js');
url.searchParams.append('tag', 'ts');
url.searchParams.set('page', '2');
// https://example.com/search?q=vue+router&tag=js&tag=ts&page=2
不要把任意业务对象直接交给构造器,期待它理解数组与空值:
new URLSearchParams({ tag: ['js', 'ts'], flag: null, missing: undefined }).toString();
// 'tag=js%2Cts&flag=null&missing=undefined'对象形式会对值做字符串转换,数组成为逗号文本,null / undefined 成为字面文本。需要重复 key 时,使用多组 [key, value] 或多次 append();需要省略字段时,在写入前明确跳过它。
原生 API 的「零依赖」以终端支持为前提。面向旧 WebView 时仍需检查 URL、URLSearchParams 及用到的方法;Babel 把 const 改成 var,不会凭空提供这些 API。
qs:把方括号协议解析成对象
如果后端已经约定下面这种参数形态,qs 才有明确价值:
import qs from 'qs';

qs.parse('filter[status]=open&tag[]=js&tag[]=ts');
// { filter: { status: 'open' }, tag: ['js', 'ts'] }

qs.stringify({ tag: ['js', 'ts'] }, { arrayFormat: 'repeat' });
// 'tag=js&tag=ts'
URLSearchParams 会把 filter[status] 和 tag[] 当完整的参数名。qs 为方括号赋予额外结构含义,并支持索引数组、重复字段等约定;默认 stringify() 使用索引数组,不能假设它默认输出重复 key。它也支持 duplicates: 'combine' | 'first' | 'last',但这个选项依然需要服从业务协议。qs 的解析与序列化文档列出了这些选项。
复杂结构也增加了资源与对象边界。当前默认嵌套深度为 5、参数数量上限为 1000;超出限制的默认行为不都等同于抛错。处理不可信输入时,可以按实际接口缩小 depth、parameterLimit、arrayLimit,并结合 strictDepth、throwOnLimitExceeded 明确拒绝越界输入。具体默认值和检查分支见 parse.js。请求长度仍应在入口限制,解析后的对象也要按字段白名单使用。
为了读取 ?page=2 引入这一整套对象协议,通常不划算;需要和既有嵌套协议对接时,它又比自己拼方括号可靠得多。
query-string:平面 query 的丰富读写选项
query-string 默认把重复 key 合并为数组,也支持 arrayFormat: 'bracket'、'index'、'comma' 等数组格式。它默认按 key 排序,保留无等号参数的 null,并提供 parseUrl()、stringifyUrl()、pick()、exclude() 等功能。当前 API 文档给出了各格式的对应结果。
它的主要对象模型仍是平面的。queryString.parse('filter[status]=open') 默认得到 { 'filter[status]': 'open' };选择 bracket 数组格式也不等于获得 qs 的任意嵌套对象协议。
如果项目确实需要这些格式和辅助操作,可以考虑它;只读几个字段则仍优先原生。9.x 的模块、语法与运行时要求还需要单独验收,后面会用一个构建实验说明。
ufo:UnJS 的 URL 工具集合
ufo 除了 parseQuery() / stringifyQuery(),还提供 withQuery()、joinURL() 等 URL 组合工具。对于已经使用 UnJS 的项目,一组一致的 URL helper 往往比零散手写更方便。项目文档和查询串源码可以对照其具体规则。
parseQuery() 默认把重复 key 合并为数组,不解析嵌套对象;?flag 和 ?flag= 都得到空字符串。stringifyQuery({ empty: '' }) 输出 empty,因此不能靠它往返保留「空字符串是否带等号」的区别。1.6.4 发布了 ESM 与 CommonJS 两种入口,没有运行时依赖。
它与原生 API 的选择也不必覆盖整个项目。路径拼接可以使用 ufo,需要验证跳转目标的协议、origin、hostname 时,则用标准 URL 解析后判断。URL helper 提供便利,并不自动完成开放重定向等业务安全校验。
querystring:先分清 Node 内置模块与 npm 包
Node.js 中建议用 node:querystring 明确指向内置模块。它默认把重复 key 合并为数组,支持自定义字段分隔符、键值分隔符和解码器;parse() 产生无原型对象,默认最多处理 1000 个 key。Node.js 文档仍将它标为 Stable,不能把它写成已经废弃的 API。
它不解析方括号嵌套,也不是浏览器标准。npm 上另有名为 querystring 的包,浏览器项目安装那个包,得到的是一份 JavaScript 实现。webpack 5 也不会自动补齐 Node.js 核心模块,不能因 Node 中可以 import 就假设前端能使用;这一变化见 webpack 5 的 Node polyfill 说明。新写跨端代码时,通常没有必要专门走这条兼容路径。
query-string 9.x 的兼容成本在哪里
query-string 的功能与兼容成本需要一起评估。Pure ESM、现代语法和运行时 API 属于不同层次,任何一层通过,都不能代替其余层的验证。
Pure ESM:检查消费方式与工具链
这个包从 8.0.0 开始切换为 Pure ESM。9.5.1 的 package.json包含以下字段,省略了依赖与开发配置:
{
  "type": "module",
  "exports": {
    "types": "./index.d.ts",
    "default": "./index.js"
  },
  "engines": { "node": ">=18" }
}
它没有独立的 CommonJS 构建,常规使用方式是 import queryString from 'query-string'。旧版 Node.js 的同步 require()、旧测试环境和旧 bundler 可能因此需要迁移。较新 Node.js 已支持在限定条件下用 require() 加载同步 ESM,因此也不能一概写成所有 Node 版本都报 ERR_REQUIRE_ESM;细则见 Node 的 require(ESM) 说明。
webpack 本身支持 ES modules。本次用 webpack 5.112.0 打包 query-string@9.5.1 的 ESM import,构建成功。因此「Pure ESM 导致 webpack 都加载不了」范围过大。旧 webpack 链路仍可能在包入口、新语法、loader 或互操作环节失败,需要看具体错误,不能只根据包的 type 字段归因。
构建成功,不代表低版本浏览器能执行
9.5.1 直接发布 index.js 和 base.js 等源码,没有额外的 ES5 发布版本。其中的 base.js直接使用箭头函数、模板字符串与 String.prototype.replaceAll()。这是消费方必须处理的终端要求。
不少 webpack 项目为缩短构建时间,在 babel-loader 中配置了 exclude: /node_modules/。依赖包虽然被解析和打包,却没有经过 Babel 的语法降级。即使写了 target: ['web', 'es5'],也只是在约束 webpack 生成的运行时代码,webpack 不会因此自动转换依赖源码。webpack target 文档直接说明了这个边界。
本次最小实验使用以下关键配置,入口只 import 该库并把 parse 暴露到全局;没有 loader,关闭压缩便于检查:
{
  mode: 'production',
  target: ['web', 'es5'],
  optimization: { minimize: false }
}
结果是构建没有错误,但 bundle 中仍然存在 => 和 .replaceAll()。在隔离执行上下文中移除 String.prototype.replaceAll 后,再解析 q=a+b,实际得到:
TypeError: parameter.replaceAll is not a function这是缺少运行时 API 的复现,并非旧浏览器完整兼容测试。箭头函数等语法需要转译,replaceAll 等 API 则需要相应 polyfill 或替代实现;只转语法仍然可能运行失败。对比之下,原生 URLSearchParams 也可能需要 polyfill,但要补的能力与依赖库不同。
保留该库时,可以按目标浏览器配置转译白名单,覆盖它及实际需要处理的传递依赖,再配置运行时补齐并验证最终 bundle。babel-loader 的兼容性说明给出了允许特定依赖进入转译的方式。不能只改本项目的 TypeScript target,就认为 node_modules 的 JavaScript 一起降级了。
对于维护旧 WebView 的项目,我的默认建议是先评估原生 API 加必要 polyfill;已有复杂 query 协议则使用能满足协议、并经当前构建验收的库。只有确实需要 query-string 的功能,才承担这套额外验收成本。长期固定旧版本也需要持续核对维护与安全状态,不能当作永久兼容方案。
体积要比较实际导入产物
「体积比较大」需要说明比较对象。npm tarball 大小包含类型、文档等文件;浏览器实际下载量取决于入口、tree shaking、压缩与项目已有共享依赖。
本次固定 esbuild 0.28.2、platform: 'browser'、format: 'iife'、target: 'es2020',开启 minify / tree shaking,关闭法律注释。每个入口只把解析函数暴露给 globalThis.parse,没有加入 polyfill,得到下面的独立 bundle:
| 解析入口 | minify 后字节数 | gzip 后字节数 |
|---|---|---|
原生包装 x => new URLSearchParams(x) |
55 | 75 |
qs.parse |
45,887 | 14,563 |
queryString.parse |
8,522 | 2,981 |
ufo 具名导入 parseQuery |
533 | 358 |
原生那一行只有调用包装代码,浏览器实现不进入 bundle;极短文本的 gzip 结果可能比原文大。几个入口的功能并不相等,qs 还承担复杂对象协议;这个实验衡量的是当前导入方式的打包成本,不是解析速度,也不是所有项目都能复现的最终增量。
在这组条件下,query-string 确实比原生和 ufo.parseQuery 重,但远小于 qs.parse。为了读取单个字段多付这些成本很难解释;如果真正需要多个数组协议与辅助函数,判断则可能改变。原始结果、实验入口和固定依赖配置可用于重新测量。
Vue Router 的 this.$route.query 从哪里来
Vue Router 把地址解析结果放进路由状态,组件读取这份状态。它还负责导航、响应式更新、history / hash 等路由层行为,业务页面通常不需要再解析一次 location.search。
默认解析器与路由状态
Vue Router 3.6.5 的 src/util/query.js已经有自己的 query 解析器,会处理加号、百分号、无等号参数和重复 key,并允许通过配置替换。它没有在这里调用 qs 或 query-string。
Vue Router 4.x,以及当前 5.4.0 的普通 createRouter() 路径,也使用自己的解析与序列化函数。5.4.0 的 router.ts中,选择函数的关键两行是:
// packages/router/src/router.ts:156
const parseQuery = options.parseQuery || originalParseQuery
const stringifyQuery = options.stringifyQuery || originalStringifyQuery
字符串地址经 parseURL()分离 path、query、hash,query 再交给这个解析函数。默认 query.ts用下面的表达式区分无等号和空字符串:
// packages/router/src/query.ts:65
const value = eqPos < 0 ? null : decode(searchParam.slice(eqPos + 1))
同一个 key 第一次出现时保存单值,再出现时转成数组并继续追加。对 /search?tag=js&tag=ts&flag&empty=,普通路由的结果是:
route.query.tag; // ['js', 'ts']
route.query.flag; // null
route.query.empty; // ''
route.query.missing; // undefined
导航确认后,解析出的目标路由写入 currentRoute。安装到 Vue 应用时,$route 的 getter 返回 unref(currentRoute);Composition API 的 useRoute() 则读取注入的响应式路由对象。因此 this.$route.query 是当前路由状态的一部分,并不是每次访问属性时都重新拆地址。
读取单值时要处理数组和空值,不能用 as string 消除类型提示后就认为数据可靠。路由参数变化时也应重新校验,例如在 computed() 中派生当前页码,或 watch 对应字段。修改 URL 使用 router.push() / router.replace(),让路由状态与导航保持一致;直接修改 route.query 不能替代导航。
Vue Router 5.4.0 另有实验路由 API,它让出现的 query 字段统一使用数组,单值也会成为
['vue'],无等号参数成为[null]。这与普通createRouter()的模型不同;升级或阅读新文档时,要同时确认版本和所使用的入口。
替换 parseQuery 会改变项目协议
路由配置允许自定义 parseQuery 和 stringifyQuery,这适合已有特殊数组或嵌套协议的项目。但直接把 qs.parse 填进去,会让 filter[status] 从平面字符串 key 变成对象,超出普通 LocationQuery 的值域;只加类型断言会掩盖这种变化。
若确实要支持嵌套 query,需要同时设计解析、序列化、类型和业务归一化,而不是让不同页面自己猜对象形态。只替换一端,还会让「复制 URL 后刷新」与「对象形式的 router.push」表现不同。Vue Router 3 的 stringifyQuery 返回值包含前导 ?,4 / 5 普通路由的函数则不包含;跨版本移植自定义函数时也要核对这个接口区别。
页面只是需要多选标签时,默认重复 key 已经够用:
router.replace({
  query: { ...route.query, tag: ['js', 'ts'], page: '1' },
});
这里使用普通路由模型。是否保留其他字段由页面决定;切换筛选项时是否重置页码,也属于页面协议。
参数还需要持续同步时,还有哪些选择
读取一个 id 后发起请求,通常只需要解析。可如果页面的标签、筛选条件或视图模式会不断变化,还希望这些状态体现在 URL 中,就要同时处理读写、浏览器前进后退、类型转换和默认值。这个需求催生了一类 URL 状态工具,它们在解析器之上增加了框架集成。
VueUse:响应式 URLSearchParams
Vue 项目中的 useUrlSearchParams 会返回响应式参数对象,修改属性时可以写回 URL。它区分 history、hash 和 hash-params 三种模式,分别适配浏览器查询串、Hash 路由内的查询串和直接存参数的 hash。
它的实现以 URLSearchParams 读写参数,并增加响应式状态和 history 更新。因此,适合已有 VueUse、又需要轻量同步页面状态的场景。已经由 Vue Router 管理的参数,默认继续使用路由状态和导航 API,让同一份 URL 状态有一个明确的管理入口。
nuqs:React 中的 URL 状态
nuqs 提供类似 React useState 的 useQueryState() 和 useQueryStates(),把状态保存在 query 中,并通过 parser 定义字符串、整数、布尔值等转换与默认值。它通过框架适配器接入 Next.js、React Router 等环境。
当 React 页面需要长期维护多组 URL 状态时,这类工具可以减少重复的同步代码。仅仅读取外部链接中的一个参数,仍然可以直接用 URLSearchParams。parser 能把字符串转成整数,也不等于自动满足页码范围、重复值策略等业务约束,字段契约仍需明确。
TanStack Router:路由自带结构化 search 参数
TanStack Router 的 search 参数机制采用 JSON-first 的结构化解析,支持把数组、对象等 JSON 可序列化数据写入 query,并通过路由的 validateSearch 定义消费前的校验和类型。
它生成的数组值可以是 JSON 文本,而 qs 常用方括号或重复 key,两者属于不同的 URL 协议。项目已经使用 TanStack Router 时,优先沿用这套能力;与第三方接口交换参数时,仍应遵循接口协议。单纯为了获取 query 而更换路由体系,成本通常过高。
把单值与多值约定写进代码
解析层保留数据以后,在页面或接口入口把它转成业务参数。对搜索页,可以明确 page 为不带前导零的十进制正整数、范围 1 到 10000、缺失时为 1;q 为可空的单值文本;tag 为最多 10 个非空值,保留顺序与重复元素。page 和 q 只要出现多次就报错,即使两个值一样也不例外。
配套示例用 URLSearchParams 解析,在 readSingle() 中统一拒绝单值字段重复,具体字段校验留在 parseSearchQuery()。这两个职责分开以后,迁移到路由库时也能保留同一份业务规则,不需要把所有 query 先转换成一个会丢信息的对象。
下面的 prompt 可交给 Coding Agent 迁移。源码工作区中可以直接修改 ?page=2&page=3、?q=、?tag=a%2Cb&tag=c,观察原始键值对、get() / getAll() 与业务校验的不同结果。
工具包根路径:https://shengsheng.fun/files/query-parameters-parser-selection/kits/query-contract/
先读 README.md、AGENT_PROMPT.md、MANIFEST.json、FILES.json,再按 FILES.json 读取源码。
迁移 copy/src/read-single.js,参考 examples/search-query.js 定义项目的单值、多值与范围规则。
合并 copy/tests 的契约用例;路由页面直接适配 route.query,不要先压平重复字段。工作区的入口是 examples/index.js,只有原生 API 和本地模块,不需要安装 query 库。这个示例选择原生容错解码,不能区分 ?flag 与 ?flag=,也没有实现不可信请求的长度限制;这些约束如果进入业务协议,需要在相应入口补齐。
重新序列化、签名与协议迁移
解析后的业务值一样,不代表原始 URL 字节一样。修改 searchParams 可能重写空格、~ 等字符的编码形式:
const url = new URL('https://example.com/?q=a%20b&x=~');
url.searchParams.sort();
url.href; // 'https://example.com/?q=a+b&x=%7E'
库也可能排序 key、改变数组格式、折叠无等号与空字符串。签名 URL、缓存 key、第三方回调等若依赖原始字符串,应保留原始地址,或严格按双方约定的 canonicalization 规则处理,不能随便 parse 后 stringify。这里的 canonicalization 指把参数排序、编码等细节统一成双方认可的唯一表示。
替换解析库时,至少拿实际协议中的重复字段、缺失字段、空值、加号、编码后的分隔符、数组与嵌套条件做回归;再检查默认排序、非法编码、参数上限和对象原型边界。先确认值是否一致,再确认生成 URL 是否仍被服务端接受。qs 能表示的嵌套对象,迁到 URLSearchParams 时需要设计新的平面协议,不存在一个完全等价的通用替换。
日常开发的选择
选型可以先从项目当前的数据入口和参数协议判断,再决定是否需要额外的状态同步能力。
| 开发场景 | 默认选择 | 需要改变选择的条件 |
|---|---|---|
| 浏览器、Node.js 中读取或修改普通平面 query | URL + URLSearchParams |
终端缺少原生 API,或已有特殊编码协议 |
| Vue Router 页面读取当前路由参数 | route.query / this.$route.query |
读取的是另一条 URL,而非当前路由 |
| 后端明确使用嵌套对象、方括号数组 | qs,显式配置解析和序列化选项 |
协议可以改成平面字段与重复 key,则重新评估原生方案 |
| 平面 query 需要多种数组格式、排序、类型转换或 URL 筛选工具 | query-string |
构建链路或旧终端的兼容成本超过这些功能的收益 |
| 项目已经使用 UnJS,需要组合路径、查询参数等 URL 操作 | ufo |
涉及标准 URL 的 origin / hostname 判断,仍用 URL |
| 维护 Node.js 既有代码或特定分隔符协议 | node:querystring |
新增跨浏览器与服务端共用代码,优先原生标准 API |
| Vue 页面需要参数与响应式状态同步,已有 VueUse | useUrlSearchParams |
参数已由 Vue Router 管理时,优先路由状态与导航 API |
| React 页面需要带类型转换的 URL 状态 | nuqs 配合当前框架的 adapter |
只读取一次参数时,原生 API 往往已经够用 |
| 项目已经使用 TanStack Router | 内置 search 解析、序列化与 validateSearch |
对接外部接口时,按接口要求使用相应 query 协议 |
这些选择都应落实到字段契约:单值是否拒绝重复,多值是否保留顺序,空值与缺失如何处理,谁负责类型和范围校验,序列化是否需要保持原始字节。确定这些以后,获取 URL 参数才有了可重复执行的答案。