浏览器如何识别网页、图片和下载:MIME、Content-Type 与内容嗅探
DNS 之前的 Chrome Omnibox解决了地址栏输入到实际 URL 的问题。浏览器选定目的地,经过必要的网络步骤取得响应以后,又遇到了一个分岔口。
浏览器是通过什么识别网页、图片、文本等资源的?
同样是在地址栏打开一个地址,结果可能是网页、铺在窗口里的图片、媒体播放器,也可能是一次下载。URL 有时以 .html、.png 结尾,有时只有 /article/42 或 /download?id=42。浏览器凭什么决定下一步?
HTTP 响应里的 Content-Type 是主要依据。它用 MIME 类型声明返回内容的格式和预期处理方式;部分情况下,浏览器还会检查内容的字节特征,进行 MIME 嗅探。实际动作还受到加载场景、下载响应头、浏览器支持能力和安全规则的影响。
这里有两个需要分别回答的问题:浏览器怎样确定资源类型,以及确定以后允许怎样使用它。把文件认作 JavaScript,与允许它作为页面脚本执行,是相邻但不同的判断。
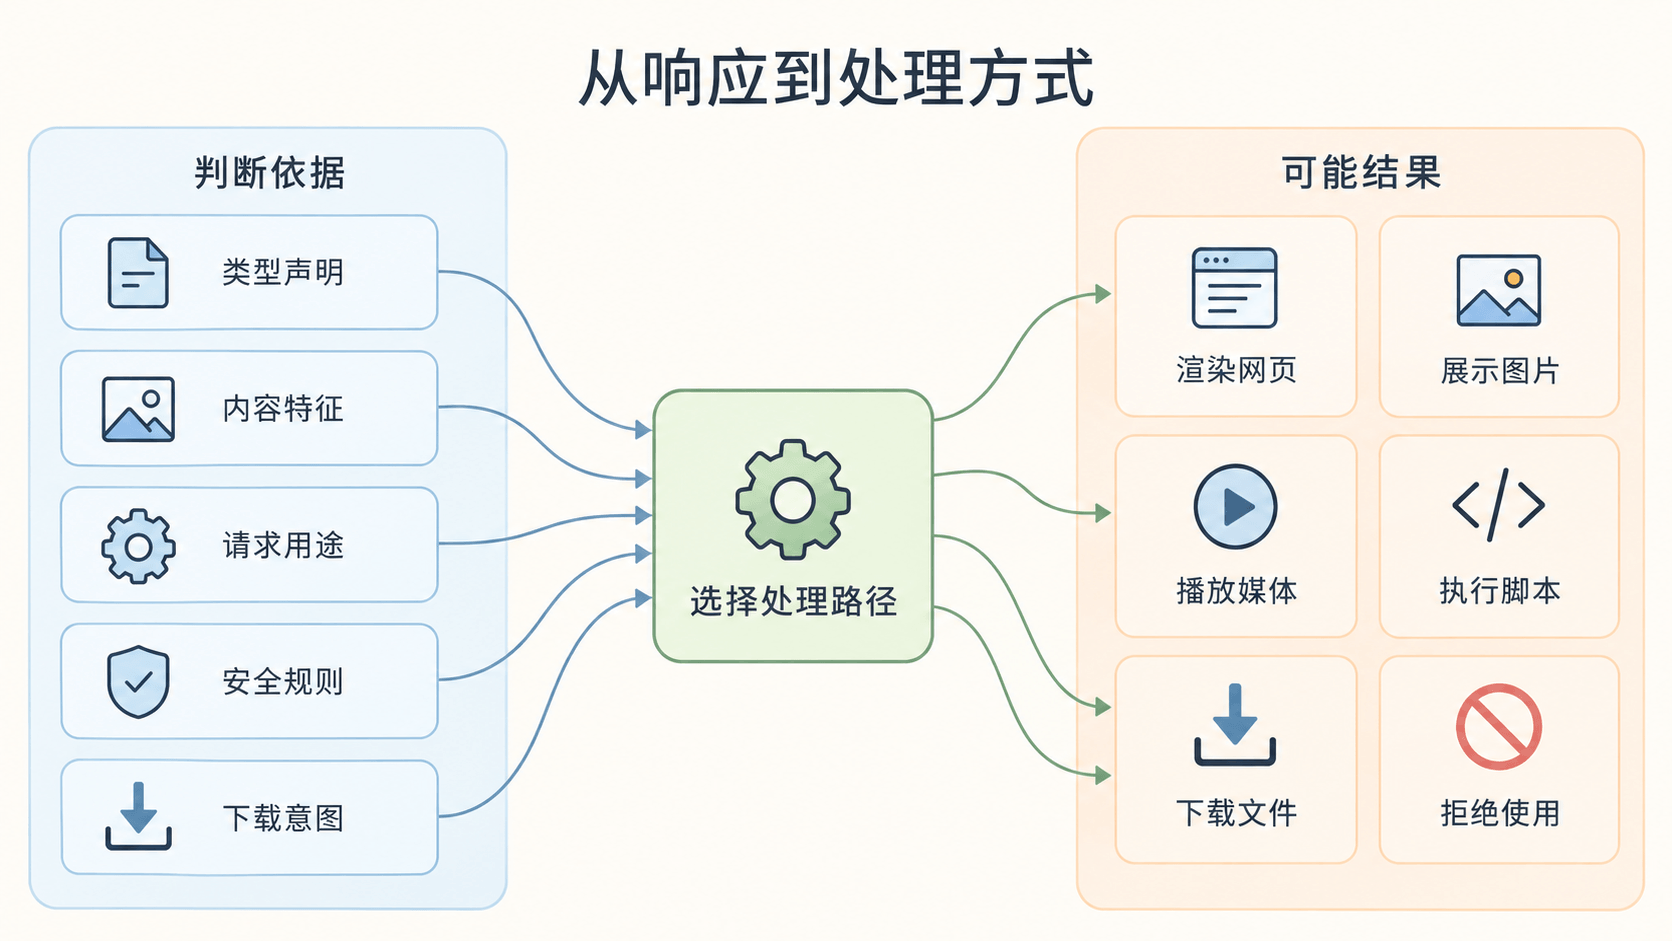
图中归纳的是影响处理方式的信息和可能的去向。实际加载时,部分检查发生在网络层,部分发生在文档、脚本或解码器中,不能把它当成所有请求都严格经过同一个判断框的实现流程。
URL 指向资源,响应说明这次返回什么
在本地文件系统里,双击 photo.png,操作系统常常根据扩展名选择打开程序。这种经验很容易被带到 Web 上,但 HTTP URL 的路径可以由服务器任意路由,和磁盘文件名没有固定对应关系。
例如,假设服务器收到这样的请求:
GET /asset/42 HTTP/1.1
Host: example.com
它既可以查询数据库返回一段 HTML,也可以读取图片,还可以动态生成 PDF。浏览器收到的响应才包含本次内容的说明。下面是一个省略了长度、缓存等字段的响应示意:
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8

<!doctype html><h1>Hello</h1>
Content-Type: text/html 告诉接收方,这份内容要按 HTML 解释;charset=utf-8 补充文本的字符编码。同一段 HTML 如果被明确作为 text/plain 返回,浏览器可以把标签直接显示成文字,而不创建这些标签对应的页面结构。
这也是无扩展名的文章地址能够正常工作的原因。服务端知道自己生成了 HTML,就可以直接声明 text/html。HTTP 对 Content-Type 的定义包含数据格式和预期处理方式,并没有要求 URL 必须带对应后缀。
扩展名仍然会影响服务端和下载文件
静态服务器经常先用扩展名查映射表,再生成响应头。例如,Nginx 的 types 指令就负责文件扩展名到 MIME 类型的映射。
于是,静态图片的常见链路是服务器看到 .png,设置 Content-Type: image/png,浏览器再根据响应信息处理内容。扩展名在服务端参与了判断,和浏览器直接用 URL 后缀决定渲染方式,是两件不同的事。
文件下载到本机后,扩展名还会影响系统关联、图标和打开方式。直接访问 file: 地址时,类型信息的来源也与 HTTP 不同,不能把网络响应的规则原封不动套过去。
对 HTTP 页面排障来说,改名并不一定能解决问题。app.js 如果实际返回了 HTML 登录页,或者 photo.png 返回的是 JSON 错误信息,浏览器仍然面对一份内容与预期不符的响应。
MIME 从邮件走到了 Web
MIME 是 Multipurpose Internet Mail Extensions,通常译作「多用途互联网邮件扩展」。它最初用于扩展邮件的内容表达能力,让消息能够描述不同字符集的文本、图片、音频以及多个组成部分。MIME 的媒体类型规范 RFC 2046建立了这套内容分类体系,HTTP 后来沿用了媒体类型的表示方式。
因此,MIME 类型虽然名字里有 Mail,却早已是 Web 的日常基础设施。网页、接口响应、上传文件和内存中的 Blob,都可能带着这样的类型标签。
类型、子类型和参数
一个常见声明长这样:
Content-Type: text/html; charset=utf-8其中 text 是主类型,html 是子类型,斜杠把两者连接起来;分号后面可以携带参数。完整写法由具体类型决定,参数并非对所有类型都适用。
主类型提供大致分类,子类型给出更具体的格式。以下是 Web 开发里常见的几组,完整名称可以查询 MDN 的常见 MIME 类型表。
| 用途 | 常见 MIME 类型 | 阅读时需要区分的内容 |
|---|---|---|
| 网页与文本 | text/html、text/plain、text/css、text/csv |
HTML、普通文本、样式和表格数据有不同处理规则 |
| JavaScript | text/javascript |
当前推荐的 JavaScript 类型 |
| 结构化数据 | application/json、application/xml |
application 分类也可以承载文本格式 |
| 图片 | image/png、image/jpeg、image/webp、image/svg+xml |
SVG 是 XML 形式的矢量图 |
| 音频与视频 | audio/mpeg、audio/ogg、video/mp4、video/webm |
容器类型之外还可能需要知道内部编解码格式 |
| 字体 | font/woff2、font/ttf |
字体加载与解码仍有自己的规则 |
| 文档与归档 | application/pdf、application/zip |
能否内联展示取决于浏览器支持能力 |
| 通用二进制 | application/octet-stream |
通常用于未细分类型的二进制内容 |
| 多部分消息 | multipart/form-data、multipart/byteranges |
一个消息体中包含多个独立部分 |
application 不能直接翻译成「可执行程序」,也不代表内容必然是二进制。JSON 通常是文本,PDF 也有专门的文档结构;MIME 分类描述的是格式及处理约定。
类型名和子类型名不区分 ASCII 大小写,惯例是写成小写;参数值是否区分大小写,要看参数本身的定义。charset 是编码参数,不能写成 text/utf-8 代替内容类型。MIME 类型结构说明可以作为这部分的查阅入口。
+json、+xml 与 vnd. 分别表示什么
image/svg+xml 表达了 SVG 的专用含义和它采用 XML 语法的特点。application/problem+json 中的 +json 则表示这个专用类型建立在 JSON 语法之上。
这种结尾叫作结构化语法后缀,由 RFC 6839等规范定义。通用工具可以据此识别基础语法,具体字段和业务含义仍由完整类型决定。认识 JSON 语法,不等于知道某个响应里的字段应当怎么处理。
vnd. 则属于媒体类型的注册命名体系,例如办公文档中常见的长类型名。它与 +json 承担不同职责,一个标识注册树,一个说明基础语法。RFC 6838 的注册树规则还包含标准树、prs. 等类别。普通项目优先采用已经存在的标准类型,不必为了某个 JSON 接口自行发明一套名称。
旧文章经常推荐
application/javascript。2022 年的 RFC 9239把text/javascript确立为当前推荐类型;浏览器为兼容已有网站,仍识别若干旧名称。新配置采用text/javascript,阅读历史响应时则要区分「仍被浏览器接受」和「当前推荐」。
声明、识别和解码是不同的步骤
Content-Type 是发送方的声明。浏览器需要读取它,但声明不会改变响应体的真实字节,也不能保证内容正确。
例如,服务器把一段 HTML 标成 image/png,不会让它变成 PNG。浏览器可能选择图片处理路径,随后解码失败;把损坏的 JPEG 正确标成 image/jpeg,也不能修复文件本身。
WHATWG 的 MIME Sniffing Standard区分了 supplied MIME type 和 computed MIME type:前者是从外部信息得到的类型,后者是经过相应规则确定的类型。在 HTTP 场景里,响应头通常提供前者。
一次资源加载涉及几个不同判断:
- 发送方声明的类型是什么?
- 浏览器按当前规则把它当成什么?
- 对应的解析器或解码器能否处理这些字节?
- 当前加载场景是否允许使用它?
图片已经被分配给图片解码器,但数据损坏;脚本内容完全合法,却被 MIME 检查挡住。这两种失败发生在不同位置,修复方向也不同。
同一份 HTML,只改响应头
下面这段内容用于本地隔离实验。服务器始终返回相同的 143 字节正文,只改变响应头,路径统一使用 /resource.html,通过查询参数选择实验条件。
<!doctype html><meta charset="utf-8"><title>MIME probe</title><h1 id="probe">MIME probe</h1><script>globalThis.mimeProbe = "executed";</script>实验于 2026 年 10 月 18 日在 Windows 上进行,浏览器是 Chrome 155.0.8059.80,使用独立无登录态的无头浏览器环境、本地 HTTP 服务和 Cache-Control: no-store。观察的既有可见内容,也有实际 DOM、脚本执行标记和下载事件。
同一份正文的两种处理结果,可以在本地对照页面里直接看到:
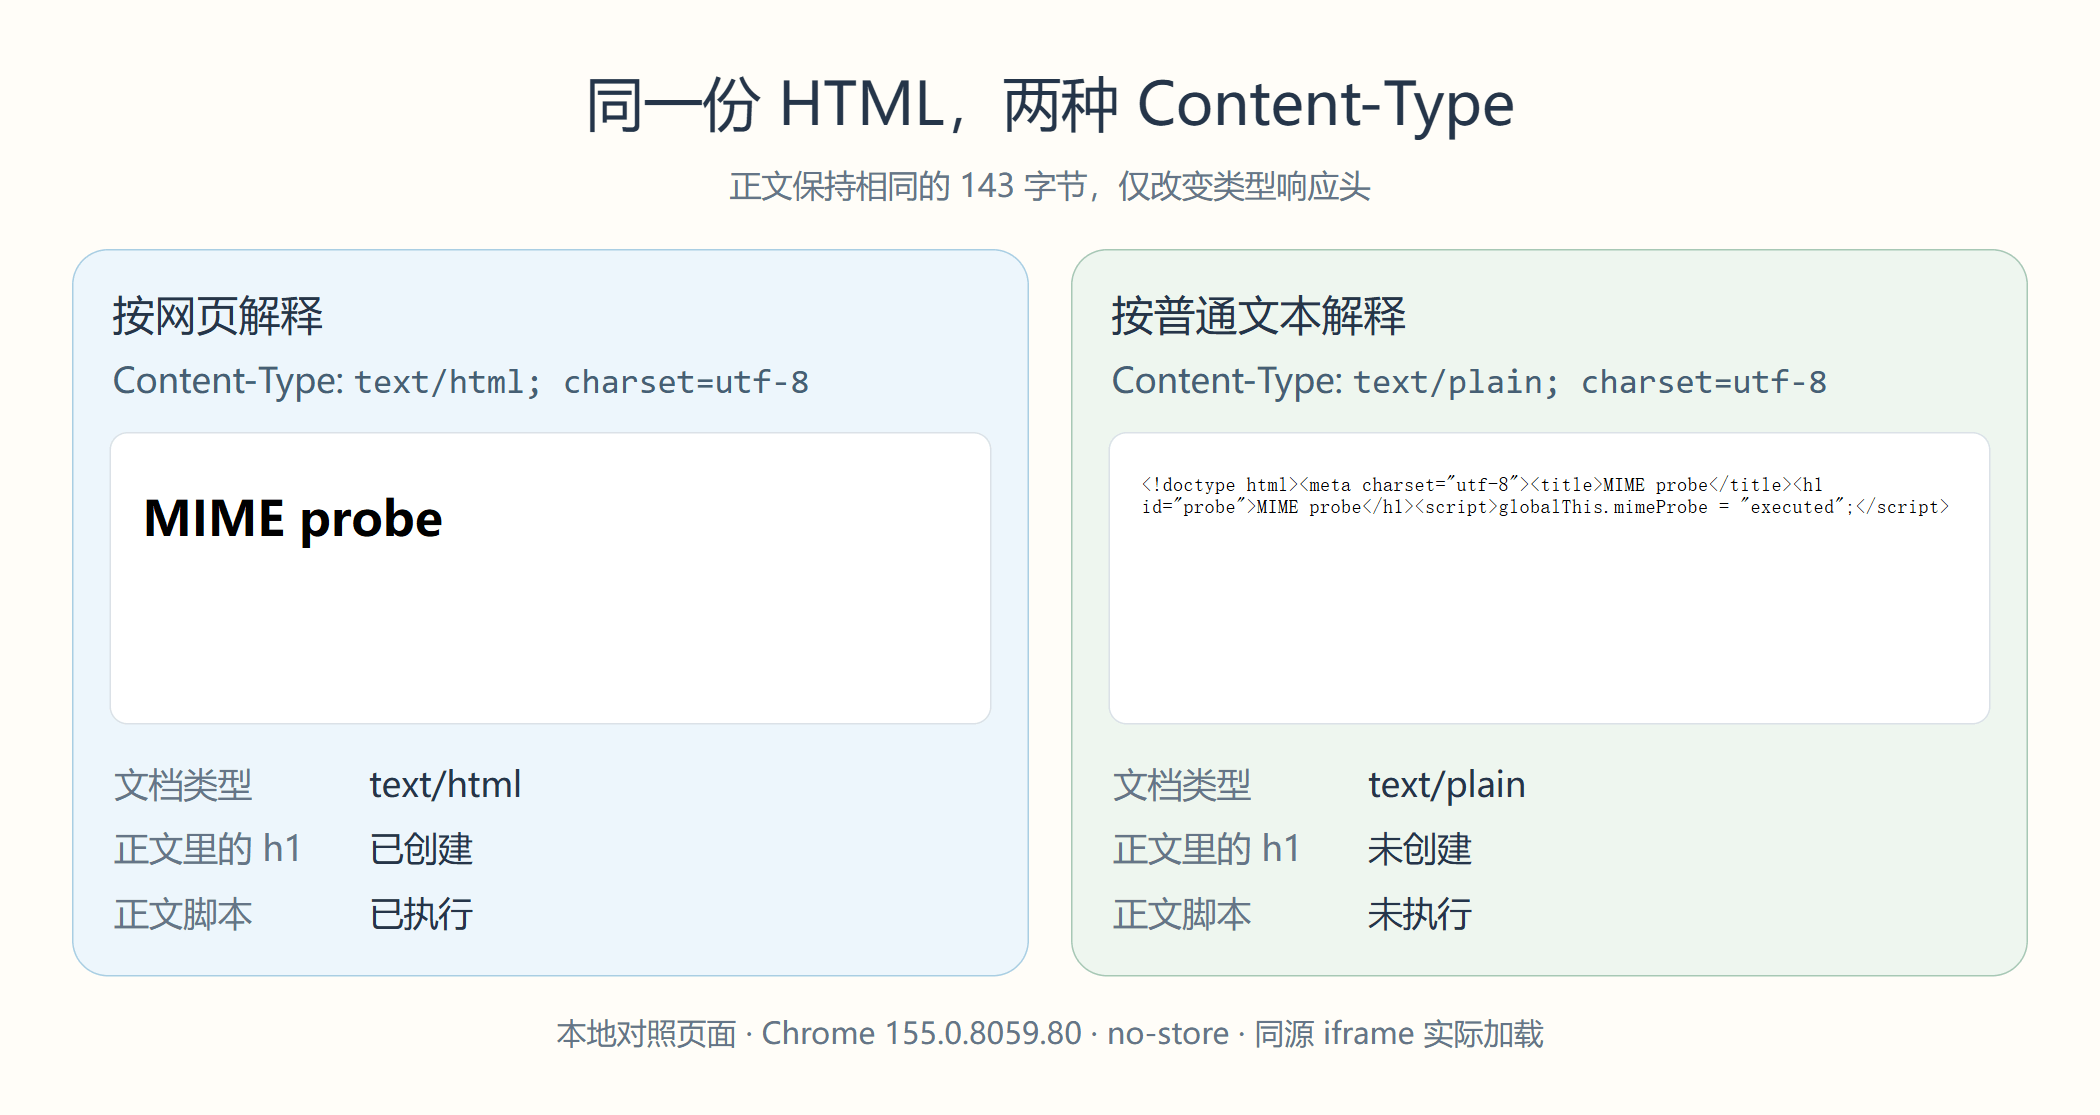
左右两块是同源 iframe 中的真实加载画面。上方类型值读取自对应响应头,下方结果读取自各自文档的 contentType、h1 节点和脚本执行标记。对照页面只负责并排展示;地址栏导航以及其他响应条件的结果见下表。
| 响应条件 | 本次实验的结果 | 当前文档的 contentType |
|---|---|---|
text/html; charset=utf-8 |
创建 h1,执行正文中的脚本 |
text/html |
text/plain; charset=utf-8 |
显示标签源码,没有创建正文里的 h1,脚本未执行 |
text/plain |
没有 Content-Type |
识别为 HTML,创建 h1 并执行脚本 |
text/html |
没有 Content-Type,有 nosniff |
显示为普通文本,脚本未执行 | text/plain |
text/plain,有 nosniff |
显示为普通文本,脚本未执行 | text/plain |
text/html,另有 Content-Disposition: attachment |
触发下载,文件建议名为 probe.html |
本次导航没有创建对应内容文档 |
application/octet-stream |
触发下载 | 本次导航没有创建对应内容文档 |
image/png,正文仍是这段 HTML |
进入图片文档路径,内容未成功显示为图片,脚本未执行 | image/png |
URL 始终带着 .html,结果却随响应信息改变。第三行说明 Chrome 在这个条件下进行了内容识别;第二行说明它不会因为内容里出现 HTML 标签,就把明确声明的普通文本一律升级成 HTML。
这些结果验证的是指定浏览器和输入条件,不能拿某一行代替所有浏览器的通用算法。原始请求路径、响应头和观察结果保存在浏览器实验数据中,后面的脚本、样式和图片实验也包含在内。
MIME 嗅探为什么存在
现实中的服务器可能漏发类型,也可能因为静态文件映射不完整,把图片返回成普通文本。如果浏览器遇到这些内容就完全放弃处理,已有网站的可用性会受到影响。MIME 嗅探提供了一些兼容性判断,根据有限的字节特征尝试识别内容。
HTTP 语义规范允许接收方在缺少 Content-Type 时,将内容视为 application/octet-stream,或者检查数据判断类型。缺少声明时的具体走向,要看内容、加载场景和浏览器规则。
嗅探检查的是字节特征
不少文件格式在开头有比较稳定的签名,也常被称为魔数。以下是 Chromium MIME 嗅探实现中几种签名的例子:
| 格式 | 开头的典型字节或 ASCII 特征 |
|---|---|
| PNG | 十六进制 89 50 4E 47 0D 0A 1A 0A |
| JPEG | 十六进制 FF D8 FF |
| GIF | ASCII GIF87a 或 GIF89a |
ASCII %PDF- |
图中高亮的是 PNG 的八字节签名,其余内容只用省略号表示。匹配这个前缀可以提供类型线索,后续图片解码仍须检查文件结构;单独拼出八个签名字节,并不能生成一张可正常显示的 PNG。
HTML 没有像 PNG 那样唯一固定的二进制文件头。识别规则会检查一些有代表性的起始标记,涉及空白、大小写和标记边界。看到字节里包含 <html 这样的片段,也不能脱离位置和规则就认定整个响应应当作为 HTML。
字节特征只能提供有限信息。ZIP 容器可以用于很多专用格式;一份内容还可能同时满足不同解释方式的部分语法。识别到签名也不等于完成文件校验,真正的解析或解码仍可能失败。
嗅探的读取范围
类型识别通常只需要内容开头的一段字节。浏览器会限制读取量和等待时间,让处理路径的选择先于整个大文件下载完成;后续的解析和解码仍会继续检查文件内容。
WHATWG 的读取规则规定,读取会在以下任一条件出现时结束:文件已经读完、已取得至少 1445 字节,或已达到浏览器认为合理的等待时间。这里的 resource header 指资源正文开头的字节片段,和 HTTP 响应头是不同对象。
Chromium 的具体实现又有自己的边界。在本次核对的 155.0.8059.85 版本里,网络 MIME 嗅探例程使用的最大字节数常量是:
// chromium/net/base/mime_sniffer.h:36
const int kMaxBytesToSniff = 1024;
这个常量描述该实现中相应例程的缓冲边界,不能外推成图片解码器、媒体解复用器和所有浏览器的统一读取上限。标准模型与具体实现也不能混为一个数字。
类型存在时,也可能有兼容性处理
Chrome 的 ShouldSniffMimeType()会结合协议、响应信息和类型决定是否进入相应嗅探路径,某些已提供的类型也可能触发兼容处理。缺少 Content-Type 只是需要考虑嗅探的一种情况。
浏览器需要在站点兼容性和安全性之间限制可接受的类型变化。只要正文像 HTML 就执行 HTML,会扩大服务端原本给内容划定的能力。
nosniff 限制哪些处理
内容类型会影响解析器,也会影响安全能力。把本来准备作为普通文字展示的用户上传内容,当作 HTML 执行,其中的脚本就可能获得网站页面的能力。这是 MIME 混淆带来的风险之一。
服务端可以通过响应头表达限制:
Content-Type: text/plain; charset=utf-8
X-Content-Type-Options: nosniff这里声明的是普通文本,同时要求浏览器遵守相应的禁止嗅探规则。X-Content-Type-Options 的说明涵盖了导航中的类型处理,以及脚本和样式的类型检查。
在 Fetch 的 nosniff 阻断规则里,脚本类请求的响应必须具有 JavaScript MIME 类型,样式请求的响应必须是 text/css,否则会被阻断。把服务端类型配置错了,再添加 nosniff,可能会让原本依靠宽松兼容勉强运行的网站直接报错。
nosniff 约束相关类型判断,图片解码器仍要读取文件结构才能产生像素,媒体解码器仍要识别容器和编码信息。它也不负责校验上传文件是否安全,更不能修复一份虚假的 Content-Type 声明。
本地实验里,一个真实的 1×1 PNG 即使以 text/plain 加 nosniff 返回,在同源页面的 <img> 中仍成功加载,naturalWidth 为 1。同样的响应头用于普通外部脚本时,脚本却被拒绝执行。这个差异要求我们继续看请求的用途。
资源怎样加载,会改变可用的处理方式
地址栏导航、<img>、<script>、样式链接和 fetch(),都能发出请求,但它们的目标不同。浏览器在收到响应前,就已经知道这次请求由什么用途触发,不能等识别完类型后,再随意变成另一种页面操作。
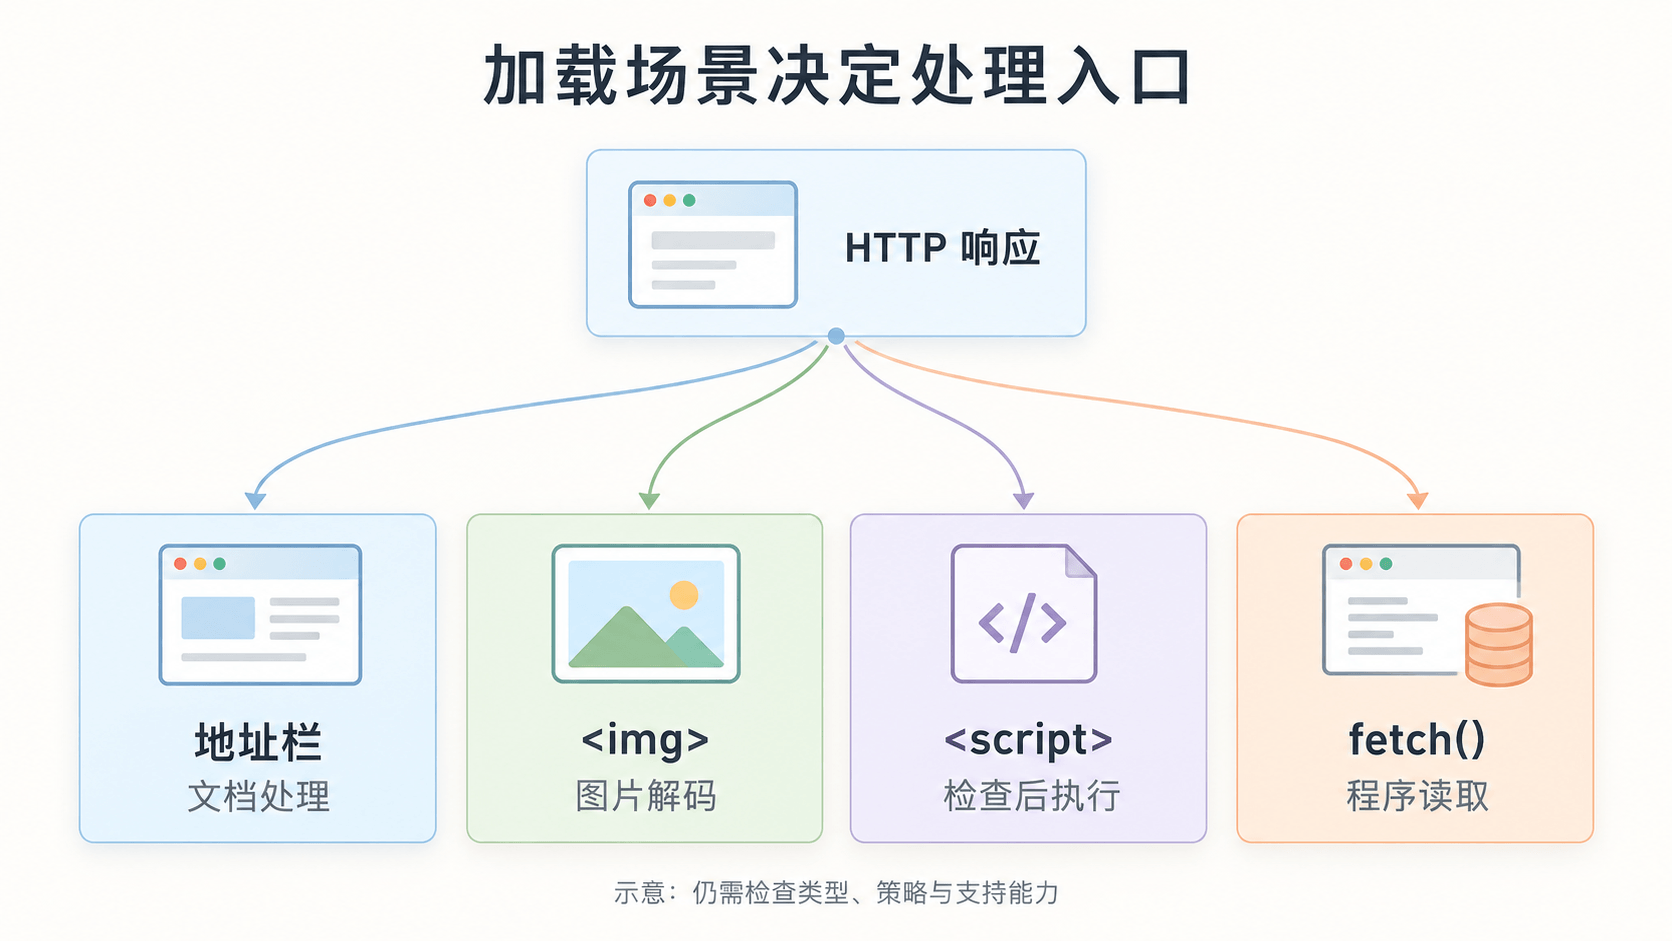
四个分支是不同请求用途的示意,彼此没有先后关系。进入脚本入口仍可能被拒绝,导航也可能转为下载;加载场景提供处理入口,具体响应还要通过类型、策略和支持能力检查。
请求发出时,已经带着用途
浏览器的资源获取流程里,有一个叫 request destination(请求用途) 的信息。它在收到响应前,就说明这份资源准备交给哪一类使用者。Fetch 标准为导航、图片、脚本、样式、字体等定义了不同的 destination。
| 请求入口 | 常见 destination | 响应通过检查后交给谁 |
|---|---|---|
| 顶层页面导航,例如地址栏打开网址 | document |
文档加载流程,可能展示网页、图片、PDF,或转为下载 |
<iframe src="…"> |
iframe |
嵌套文档的导航与加载流程 |
<img src="…"> |
image |
图片加载与解码流程 |
CSS 的 background-image: url(…) |
image |
图片加载流程,再用于背景绘制 |
<link rel="stylesheet">、CSS @import |
style |
CSS 解析与样式应用流程 |
@font-face 的 src: url(…) |
font |
字体解析与使用流程 |
普通 <script src>、JavaScript 模块 |
script |
相应的脚本或模块加载流程 |
new Worker(…) |
worker |
Worker 的普通脚本或模块加载流程 |
JavaScript fetch() |
空字符串 '' |
调用者取得 Response,选择读取和后续使用方式 |
这张表区分了两个问题:请求用途说明「准备拿它做什么」,MIME 类型说明「服务端说返回了什么」。两者还要和实际内容、使用场景的检查规则一起决定结果。script 请求收到 image/png,不会自动改成在页面里展示图片;同样,image 请求收到 HTML,也不会自动变成 HTML 文档。
浏览器发出的 Sec-Fetch-Dest 请求头,可以把这类用途告诉服务端。在本地 HTTP 实验中,CSS 背景图请求带着 Sec-Fetch-Dest: image,字体请求带着 font,普通 fetch() 带着 empty。这些值来自发起请求的上下文,和 URL 有没有后缀无关,也不是响应 MIME 类型。
这里有一个容易混淆的拼写区别:JavaScript 的 Request.destination 对普通 fetch() 请求返回空字符串,HTTP 请求头用 empty 表达它。
const request = new Request('/cover.png');
request.destination; // '',文件名没有把它变成 image 请求
const response = await fetch(request);
destination 是只读属性,Sec-Fetch-Dest 也由浏览器控制,普通网页脚本不能通过随意改这个头来冒充另一种请求入口。Fetch Metadata 请求头还受发送条件限制,主要用于 HTTPS、可信的本地回环地址等场景,不能假设所有客户端和所有 HTTP 请求都带着它。
HTML 和 CSS 的资源加载也遵循 Fetch 等标准定义的获取流程;网页里的 fetch() 则是暴露给 JavaScript 的一个调用入口。浏览器不需要先调用页面中的 fetch() 函数,才能加载一张图片或一份样式表。
CSS 的 url(),由引用位置决定用途
url()提供的是资源位置。浏览器还要看它写在哪个属性或规则中,才知道该怎样加载和使用:
@import url('./base.css');

.cover {
  background-image: url('./cover.png');
}

@font-face {
  font-family: Article;
  src: url('./article.woff2') format('woff2');
}
第一处引入另一份样式表,第二处需要一张背景图,第三处需要字体。它们分别进入 style、image、font 对应的处理流程。浏览器根据上下文确定用途,再检查得到的内容是否符合要求;仅仅把后缀写成 .woff2,不能把任意响应变成有效字体。
图中三行是并列的使用场景。每种资源都仍需通过自己的类型、策略和内容解析检查。
普通外部样式表里的直接相对引用,通常以样式表自身的 URL 为基准。例如页面位于 /pages/article.html,加载 /styles/main.css,其中的 url('./cover.png') 指向 /styles/cover.png。不能看到页面地址,就把所有相对资源都拼到页面目录下面。行内样式中的相对引用一般使用文档的基准 URL。
url() 也不保证一定新增一次 HTTP 请求。url(#mask) 可以引用当前文档中的 SVG 资源;缓存、资源是否实际被使用等因素,也会影响获取时机和网络访问。代码里出现一个 URL,与网络上发生一次传输之间,还隔着资源加载规则。
link 的用途,要看 rel 和 as
<link>用于声明当前文档与其他资源的关系。rel="stylesheet" 表示样式表,rel="icon" 表示图标,rel="preload" 则要求提前获取资源。看到 <link> 标签本身,还不能确定它会进入哪种处理流程。
<link rel="stylesheet" href="/assets/app.css">
<link rel="preload" href="/assets/app.js" as="script">
<script src="/assets/app.js" defer></script>
第一行会加载并应用样式;第二行按脚本用途提前获取资源,供第三行使用。单独的 preload 不会因为 as="script" 就执行脚本,也不会因为 as="style" 就应用样式。本地实验中,预加载请求成功完成,但脚本中的标记没有出现,预加载 CSS 定义的样式也没有生效。
as让浏览器按相应用途安排预加载,包括请求优先级、请求头和安全检查等。后续使用者的用途、CORS 模式和凭据设置等,需要与预加载匹配,才能有效复用结果;例如字体预加载通常需要正确设置 crossorigin。配置不匹配可能造成重复请求。
标签上的 type 可以提供媒体类型提示,帮助浏览器判断是否值得获取某种格式,但不能改写服务器实际返回的 Content-Type,也不能修好错误的响应正文。<link rel="stylesheet" type="text/css"> 最终收到登录页 HTML,仍然不能当作正常样式表使用。
modulepreload还有模块专用行为:浏览器可以提前获取、解析和编译模块,并放入模块映射中。它与普通 preload 的准备工作不同,但同样不代表模块已经被执行。
地址栏打开图片,与页面嵌入图片
地址栏直接访问图片时,浏览器可以创建用于展示图片的文档;页面中的 <img> 则把响应交给图片加载和解码流程,在现有页面中占据一个图像位置。
如果 <img src="/article"> 得到的是 HTML,浏览器不会把那一块图片位置自动变成网页 iframe。本次实验中,图片元素收到 HTML 正文后触发了错误,naturalWidth 为 0。
反过来,图片元素可能依靠实际图片字节成功解码,即使服务端声明不够准确。这类兼容行为不能作为服务端省略类型的理由。跨源访问、安全策略或另一种图片格式,都可能让结果变化;稳定的交付仍应提供正确类型。
SVG 作为图片使用时,脚本和外部资源加载等能力受到限制;同一份 SVG 作为文档加载时,限制条件会变化。
iframe 创建的是嵌套文档
<iframe src="…">在页面中创建一个独立的文档环境。它的导航同样需要处理响应类型:返回 HTML,可以创建 HTML 文档;返回普通文本,可以展示文字;支持的图片或 PDF,也可能交给相应的文档或查看器处理。iframe 并不意味着响应一定按 HTML 解释。
本地实验里,同一段 HTML 以 text/html 返回时,iframe 中出现 h1,脚本标记也成功设置;改成 text/plain 后,文档类型变为 text/plain,正文里的标签和脚本都作为文字展示。
SVG 更能体现图片与文档入口的差别。下面的两块区域加载同一份 SVG,响应类型都为 image/svg+xml。SVG 初始显示「脚本未执行」,内部脚本会把它改成「脚本已执行」:
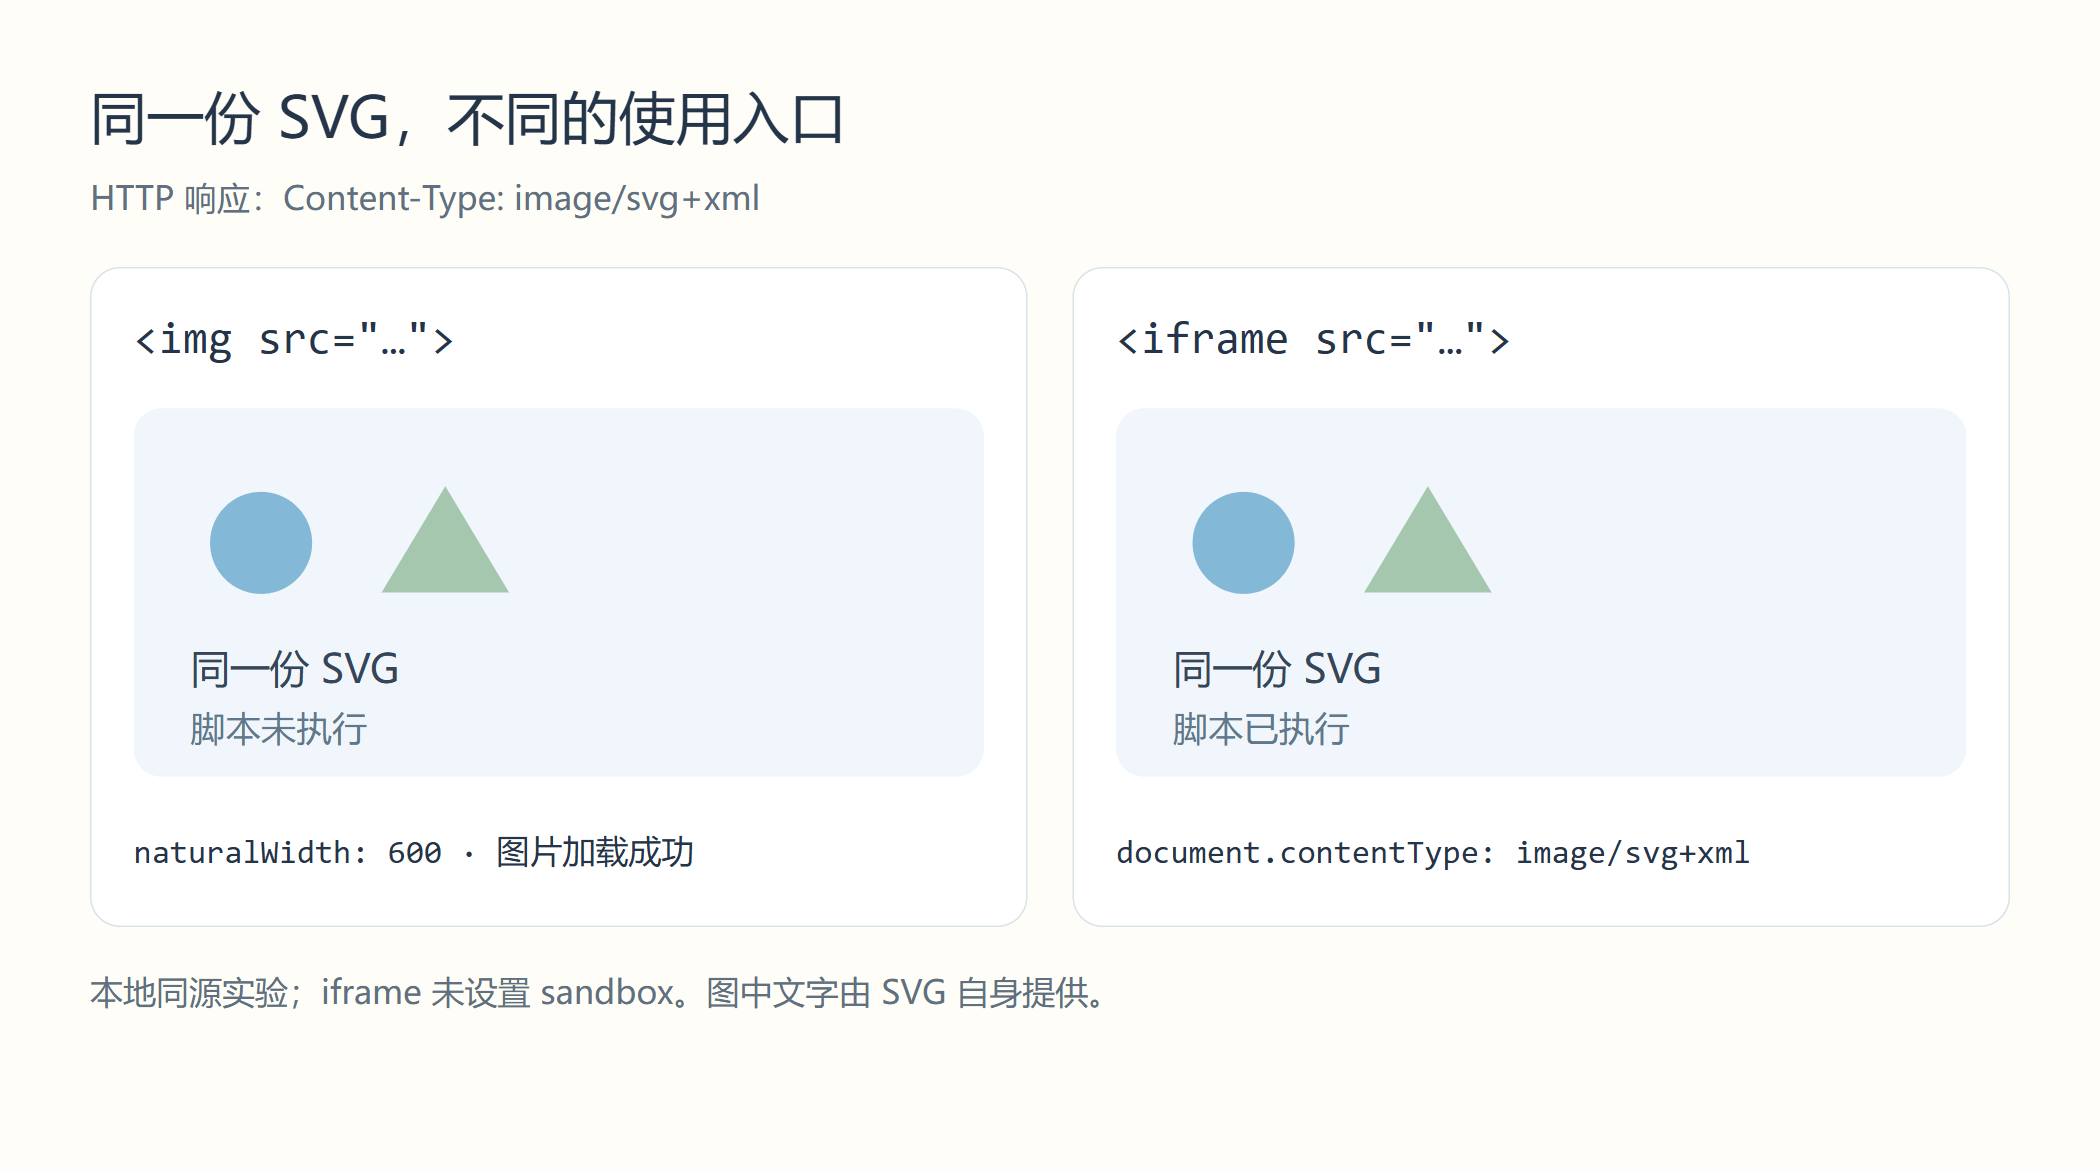
左侧 <img> 成功显示图形,但内部脚本没有运行;右侧未设置 sandbox 的同源 iframe 创建 SVG 文档,脚本运行并改变了文字。地址栏直接打开这份 SVG,也出现了脚本执行标记。图片扩展名和 image/ 主类型,都不能单独说明它在哪种使用方式下具备什么能力。
文档能力还受嵌入策略限制。在同一组实验里,iframe 设置 sandbox="allow-same-origin"、没有授予 allow-scripts 时,SVG 仍可展示,内部脚本却不再执行。正确 MIME 类型并不会替资源获得脚本权限、跨源读取权限或被其他页面嵌入的许可。
srcdoc 是另一个入口:<iframe srcdoc="<h1>Hello</h1>">直接提供 HTML,所创建文档的位置为 about:srcdoc,没有为这段初始 HTML 单独获取 HTTP 响应。类似地,行内 <style> 和普通行内 <script> 的内容由 HTML 的相关规则处理,不需要再给每个片段配一条 HTTP Content-Type。<script type="application/json">还可以承载不作为 JavaScript 执行的数据块。script 的类型规则与 HTTP 响应类型、链接上的类型提示,分别有自己的作用范围。
脚本加载与程序读取,采用不同的类型规则
脚本入口负责加载和执行代码,fetch() 则把响应交给程序。即使它们请求同一个 URL,可接受的响应条件和后续动作也可能不同。
普通脚本、JavaScript 模块和 CSS
现代 JavaScript 模块对类型有严格要求。对于普通的 JavaScript 模块加载,例如 <script type="module" src="/app.js"> 或 JavaScript import,HTTP 响应应当提供浏览器认可的 JavaScript MIME 类型;JSON 模块、CSS 模块等则有各自的导入类型和匹配规则。HTML 的模块获取算法明确区分了这些路径。
本地实验固定脚本正文为:
globalThis.externalProbe = "executed";只改变加载方式和响应头,得到以下结果:
| 加载场景 | 响应类型与其他条件 | 本次实验的结果 |
|---|---|---|
普通 <script src> |
text/plain,没有 nosniff |
脚本执行 |
普通 <script src> |
text/plain,有 nosniff |
脚本被阻断 |
<script type="module"> |
text/plain,没有 nosniff |
模块被拒绝 |
<script type="module"> |
text/javascript |
模块执行 |
<link rel="stylesheet"> |
text/plain,有 nosniff |
样式被阻断 |
<link rel="stylesheet"> |
text/css,有 nosniff |
样式成功应用 |
第一行反映普通脚本的历史兼容,不能据此给所有脚本返回 text/plain。普通脚本还有其他 MIME 阻断规则;页面能执行某次错误类型的响应,也不能证明它已经被嗅探成了正确类型。
CSS 也有自己的类型要求。在标准模式的页面里,外部样式表应返回 text/css;不能以为没有 nosniff,浏览器就一定会接受任意 MIME 类型。HTML 的样式表加载规则为 quirks mode(怪异模式)保留了特定的同源兼容条件,但正常站点不应依赖这种历史例外。
常见的部署故障是 /assets/app.js 路径没有命中文件,服务器却回退到 index.html,最终得到 200 OK 和 Content-Type: text/html。模块加载失败时,应先看响应正文是不是 HTML,再决定修正路由、登录跳转还是静态资源配置。直接把这份 HTML 的响应头改成 text/javascript,只会把问题推进到脚本解析阶段。
Worker 也要区分普通脚本和模块
new Worker()在独立的 Worker 环境中运行代码,响应仍应提供正确的 JavaScript 类型。{ type: 'module' }选择模块 Worker,默认则是普通 Worker;这里的 type 选项选择脚本模式,并不是让调用者替 HTTP 响应指定 MIME 类型。
const classicWorker = new Worker('/worker.js');
const moduleWorker = new Worker('/worker.js', { type: 'module' });
本地实验保持正文为 postMessage('worker-ok'):两种 Worker 都能使用 text/javascript;普通 Worker 在没有 nosniff 时也运行了 text/plain,加上 nosniff 后触发加载错误;模块 Worker 则在没有 nosniff 时就拒绝了 text/plain。普通脚本的历史兼容,不能外推为模块 Worker 也接受相同响应。
Worker 还受到来源和 CSP 等规则限制。一个在地址栏里可以显示源码的 URL,未必是 Worker 能运行的脚本;排查时需要检查 Worker 模式、实际响应头和正文,而不只是确认文件能下载。
Wasm 的流式编译要求 application/wasm
WebAssembly 提供了另一种按用途检查类型的例子。WebAssembly.instantiateStreaming()可以接收 fetch() 返回的响应,在获取过程中编译和实例化 Wasm;这个入口要求响应具有 application/wasm 类型。
const result = await WebAssembly.instantiateStreaming(fetch('/module.wasm'));对于同一份有效的最小 Wasm 二进制,本地实验中,application/wasm 可以成功进入流式编译,改成 application/octet-stream 则抛出 TypeError。字节没有损坏,失败发生在接口要求的响应类型检查上。
程序也可以先通过 arrayBuffer()取得字节,再调用 WebAssembly.instantiate(bytes)。后一个接口消费的是内存字节,不再读取原始 HTTP 响应头;实验里的同一份 application/octet-stream 响应因此可以沿这条路径完成编译。字节仍须是有效 Wasm,页面也仍须允许编译和执行。服务端能够修正时,应提供正确类型,让流式入口正常工作。
fetch().json() 由调用者选择解析方法
fetch() 取得响应后,不会把 HTML 自动插进当前页面,也不会因为拿到 JavaScript 就自动执行它。调用者通过 text()、json()、blob() 等方法决定怎样读取响应体。
Response.json()会读取响应体并解析 JSON。在本次实验中,同源接口虽然返回 Content-Type: text/plain,正文是合法的 {"ok":true},response.json() 仍然成功:
const response = await fetch('/data?ct=text%2Fplain');
response.headers.get('content-type'); // 'text/plain'
await response.json(); // { ok: true }
document.contentType; // 'text/html',仍然是当前页面的类型
这表明解析方法与响应声明可以不一致;解析成功没有替服务端纠正响应头。反过来,标成 application/json 的 HTML 错误页,也会在 JSON 解析时失败。
接口程序通常仍应检查 HTTP 状态、响应声明和业务结构,再决定怎样处理。JSON 类型还包含带 +json 后缀的专用类型,不能把所有合法 JSON 响应都限定为一个完全相等的字符串。
同样,fetch() 获得图片后调用 blob(),只会得到 Blob 数据,不会自动在页面上显示图片。程序可以继续创建对象 URL,交给 <img> 等入口使用;此时才进入图片消费流程。
下载也是如此。即使响应带着 Content-Disposition: attachment,普通 fetch() 也不会因此自动弹出下载窗口。本地实验中,这个响应可以通过 text() 读出正文,浏览器没有产生下载事件。需要保存文件时,程序还得显式安排下载流程;导航或普通链接访问下载地址,则由相应的浏览器导航流程处理。
Window.fetch() 中的相对 URL 使用文档的基准 URL。假设 /page/article.html 加载了 /assets/app.js,脚本里执行 fetch('./data.json'),通常请求的是 /page/data.json;脚本文件放在哪个目录,不会自动改变这里的基准。这与外部 CSS 中直接写出的相对 url() 有区别,文档中的 <base> 元素还可能改变文档基准 URL。
从响应到 Blob,再交给新的使用入口
Blob 可以保存一段字节及其关联的类型信息。response.blob()读取响应体后,生成的 Blob 类型来自响应的 Content-Type,不会额外鉴定字节的真实格式。再用 URL.createObjectURL()创建 blob: URL,就能把它交给接受 URL 的使用者。
图中的下游是不同选择:图片字节可以交给 <img>,文档内容可以交给 iframe,文件可以通过下载链接保存。各入口仍须支持相应内容,并通过自己的检查;创建对象 URL 本身不会转换文件格式。
以图片预览为例,关键步骤是:
const response = await fetch('/cover');
if (!response.ok) throw new Error(`HTTP ${response.status}`);
const blob = await response.blob();
const objectURL = URL.createObjectURL(blob);
image.src = objectURL;
这里的 image 是已有的 <img> 元素。预览不再使用、元素被移除或换图后,应对旧地址调用 URL.revokeObjectURL(objectURL)释放关联资源。不要在刚设置 src 后就立刻撤销;地址仍可能被加载、另存或其他交互使用。Blob URL 的生命周期说明包含这类清理时机。
这条链路也适用于文档。本地实验中,HTML 响应生成 type: 'text/html' 的 Blob 后,交给同源 iframe 的对象 URL 创建了 HTML 文档并执行了脚本;最初的 fetch() 只负责取得数据。把内容交给文档入口,会引入文档的解析与执行能力,必须按该入口对待。
HTTP 响应的其他信息不会全部附着在 Blob 上。比如原响应的 Content-Disposition 和建议文件名,不是 Blob 的属性;程序自己创建下载链接时,需要自行安排建议名称。原始网络请求和后续 blob: 加载之间,既有字节与类型信息的传递,也有处理上下文的变化。
能嵌入跨源资源,不等于能读取它
加载入口还会影响跨源处理。同一张其他域名下的图片,可能可以通过 <img> 展示,却不能通过默认的 fetch() 读出字节。这两种行为授予网页的能力不同:展示一张图片,不等于允许页面脚本取得它的全部数据。
普通 <img> 没有设置 crossorigin 时,通常以 no-cors 模式获取图片。在其他策略允许的情况下,它可以展示有效的跨源图片;但把这种图片画到 canvas 后,画布会受到污染,脚本再读取像素就会失败。跨源图片与 canvas 的说明解释了这道限制。设置 crossorigin="anonymous" 会改用 CORS 获取;要成功加载并保持画布可读,还需要图片服务器配合授权。
跨源 fetch() 默认使用 CORS,服务端需要提供相应的跨源许可,调用者才能读取响应。改成 mode: 'no-cors' 不会解除限制,而会得到 opaque(不透明)响应:脚本无法读取真实状态、响应头和正文。Fetch 的 CORS 说明区分了这些权限。
本地实验用不同端口构成两个源,让图片服务器不提供 CORS 授权,得到以下结果:
| 使用方式 | 本次实验的结果 |
|---|---|
<img>,不设置 crossorigin |
图片成功显示,宽度为 1 |
| 将该图片画到 canvas,再读取像素 | 抛出 SecurityError |
默认 fetch() |
因缺少 CORS 授权而失败,抛出 TypeError |
fetch() 设置 mode: 'no-cors' |
得到 type: 'opaque'、status: 0,无法读出原始图片字节 |
JavaScript 模块和 Web 字体的跨源加载也有 CORS 要求;传统脚本等入口又有各自的历史行为。排查资源加载失败时,要同时看 MIME、请求用途、CORS 模式以及 CSP 等页面策略。返回 200 OK 和正确的 Content-Type,只是满足了其中一部分条件。CSS Fonts 的字体获取规则明确规定了字体的 CORS 获取方式。
上述用途、预加载、相对路径和跨源对比,在 Windows 上的 Chrome 155.0.8059.80 中进行了本地验证。测试使用标准模式 HTML 和禁用缓存的本地 HTTP 服务;请求头与观察结果保留了每个请求的 destination、mode 和对应现象。实验用于观察这组条件下的行为,具体要求仍以各入口的标准规则为准。
媒体类型、编码与分段加载
媒体加载既要选择支持的格式,也要处理持续到达的数据。MIME 类型能描述容器与部分编码信息,播放器还需要检查轨道、实际字节和传输条件。
视频类型还没有说完内部编码
video/mp4 说明容器类型,容器内的视频轨道和音频轨道还可能采用不同编码。浏览器认识 MP4 容器,并不保证支持每一种内部编码组合。
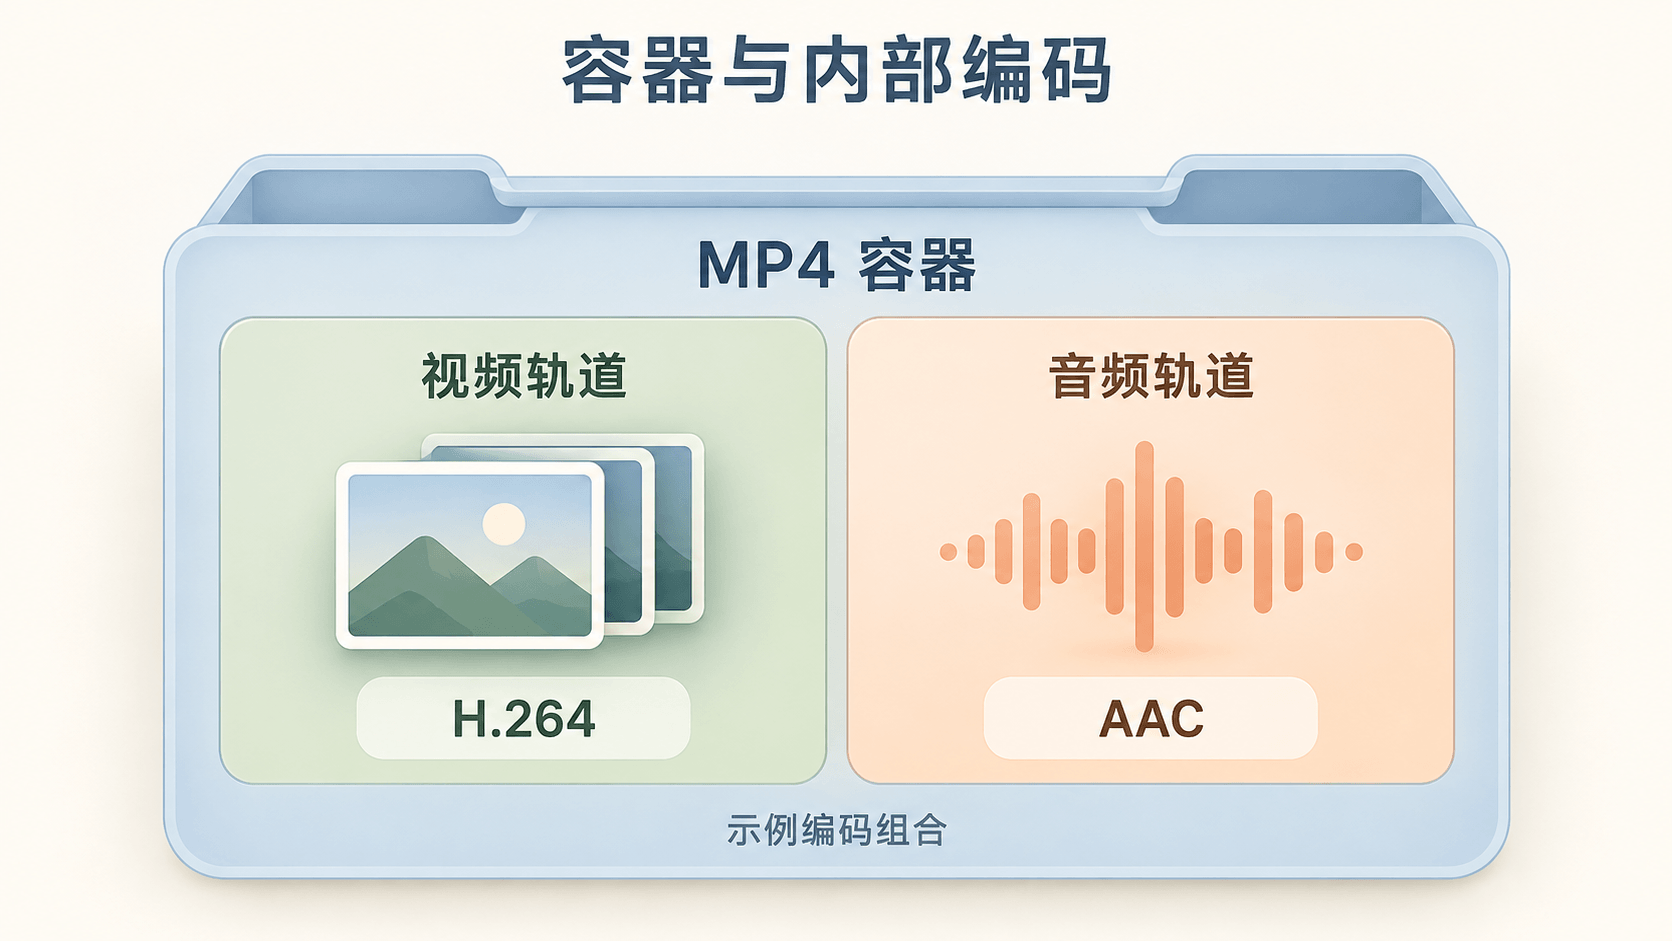
图中 H.264 与 AAC 是一种编码组合示例。轨道属于容器内部的组成部分,视频轨道与音频轨道分别解码,再按时间关系播放;换一种编码组合,容器的 MIME 类型仍可能保持为 video/mp4。
codecs 参数可以补充更具体的编码信息。比如媒体源声明中的 video/webm; codecs="vp9, opus",同时说明 WebM 容器、VP9 视频和 Opus 音频。
媒体能否播放还受到文件完整性、平台解码能力和页面策略的影响;能播放与允许自动播放也分别受不同规则控制。类型识别成功,只完成了这条链路中的一部分判断。
<video> 或 <audio> 中的 <source type="…">还可以提前提供类型与编码提示,让浏览器在选择候选资源时判断自己是否支持它。这个提示与实际响应声明分别存在,不能修复错误的 Content-Type,也不能保证完整媒体一定可解码。source 元素同时用于媒体和 <picture> 等候选资源选择场景。
206 只传输一段内容,类型仍要说明清楚
播放器拖动进度、PDF 查看器读取文件局部,以及断点续传,都可能使用 HTTP 范围请求。客户端用 Range 指定所需区间,服务器支持并满足请求时,可以返回 206 Partial Content。
单个区间响应的类型仍然描述原资源。例如下面是一个假设总长为 100000 字节的 MP4 文件片段:
HTTP/1.1 206 Partial Content
Content-Type: video/mp4
Content-Range: bytes 0-1023/100000
Content-Length: 1024video/mp4说明资源格式,Content-Range说明本次返回哪段字节,Content-Length说明这段响应体的长度。它们各自描述不同信息。片段还可能从文件中间开始,不能要求每个响应体都具有完整文件的开头签名。
一个响应包含多个区间时,外层可以使用 multipart/byteranges; boundary=…,每个部分再携带自己的 Content-Type 和 Content-Range。此时外层类型描述多部分封装,内部各段仍属于原来的资源。
浏览器实际使用的响应,从哪里来
点击一个 URL,并不保证浏览器直接使用源站刚刚生成的完整响应。重定向会改变目的地址,缓存可以复用既有内容,Service Worker 还能提供自己的响应。定位 MIME 问题时,需要找到最终供当前使用者处理的正文与类型信息。
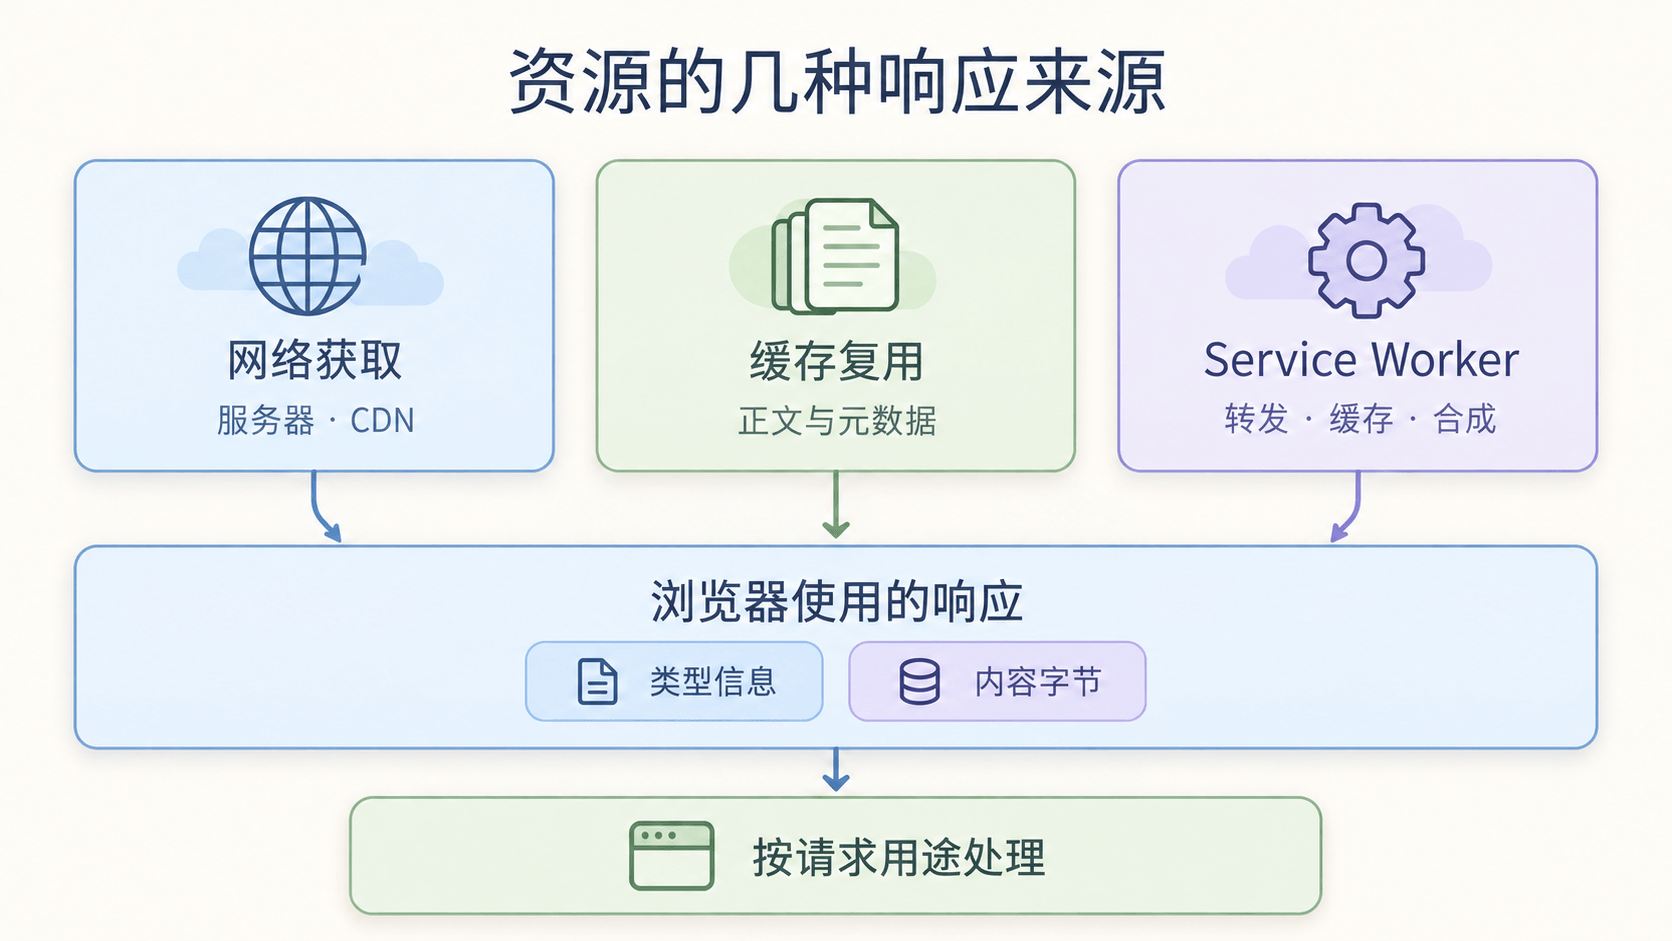
三条路径归纳的是响应来源,不表示固定执行顺序或互斥的底层流程。Service Worker 可以继续访问网络,也可以使用自己的缓存;HTTP 缓存与 Service Worker 的 Cache API 又是不同的存储机制。
重定向后,要看最终响应
302 等重定向响应可以通过 Location 让浏览器继续访问另一个地址。中间跳转自身的 Content-Type,不能代替最终资源的类型。
本地实验让 /redirect 返回 302、Content-Type: text/html 和 Location: /final.json。默认跟随跳转的 fetch() 最终取得 200、application/json,并成功解析 JSON;response.redirected为 true,response.url指向 /final.json。
静态脚本被重定向到登录页时,同样要沿请求链找到最终响应。程序还可以设置不同的重定向处理方式,安全规则也可能阻止跳转;默认跟随时的观察,不能套到所有模式。
304 复用缓存中的正文和类型信息
304 Not Modified不是重新发送一次完整资源,它确认缓存中的表示仍可使用。浏览器根据缓存规则复用正文,并用适用的新响应字段更新已保存的元数据。HTTP 缓存规范定义了这个更新过程。
例如,首次响应保存了 Content-Type: text/plain、正文和 ETag;后续请求携带 If-None-Match,服务器返回不含正文、也不含 Content-Type 的 304。在本地实验中,网络层确实记录到 304,但调用者第二次 fetch() 取得的仍是合并后的 200 响应,类型为 text/plain,正文也与首次相同。
因此,看到 304 本身没有类型字段,不等于浏览器面对一份未知类型的空文件。源站修正类型后仍有旧结果时,要核对缓存条目、校验标识与 CDN 缓存是否同步更新,不能只检查源站配置文件。
Service Worker 可以构造响应
Service Worker 的 fetch 事件可以通过 respondWith()提供缓存响应、网络响应,或自己生成的 Response。后续消费者依然需要类型信息,响应头不会因为内容由前端代码生成而失去作用。
下面是合成 HTML 响应的关键片段:
event.respondWith(new Response('<h1>Hello</h1>', {
  headers: { 'Content-Type': 'text/html; charset=utf-8' },
}));
在本地实验中,这样的响应在 iframe 中创建了 HTML 文档;如果只写 new Response('<h1>Hello</h1>'),字符串正文得到默认的 text/plain;charset=UTF-8,最终作为普通文本展示。业务代码生成了 HTML 字符,并不代表浏览器已经收到 HTML 类型的响应。
排查受 Service Worker 控制的站点时,还要看 Network 中的响应来源、当前控制页面的 Worker 及其缓存策略。源站已经修正的资源,可能尚未替换 Worker 返回的旧响应。
状态码、类型和正文有效性分别判断
状态码说明请求处理结果,MIME 类型描述内容格式,解析器再检查正文是否合法。它们可以形成几种容易混淆的组合:
| 响应情况 | 本地实验或对应规则 |
|---|---|
404,类型为 application/json,正文是合法错误 JSON |
fetch()取得响应,ok为 false,但 json()仍能解析错误信息 |
200,类型为 text/html,实际是应用回退页 |
导航可以展示 HTML,模块脚本或 JSON 调用者仍可能拒绝它 |
204,即使声明 application/json |
没有响应正文;实验中 ok为 true,json()抛出 SyntaxError |
HEAD,声明 application/json |
响应可以提供类型等元数据,但不发送正文;实验中 text()读到空字符串 |
fetch()不会仅因为 404 或 500 就自动 reject。调用者通常需要检查状态,再按接口约定处理成功数据或错误正文。204与 HEAD又各有无正文的语义;类型字段不能凭空生成 JSON 数据。
iframe、Blob、Worker、Wasm、重定向、缓存、Service Worker、状态、下载和编码案例,同样在 Windows 上的 Chrome 155.0.8059.80 中进行了本地隔离验证。补充实验数据记录了实际响应、请求用途和观察结果。媒体范围响应示意来自协议规则,未用这组实验模拟真实播放器的完整加载过程。
展示还是下载,还要看 Content-Disposition
通过地址栏或普通链接打开 PDF 时,浏览器既可以用内置阅读器展示,也可以保存到本机。内容类型描述 PDF 格式,下载意图则通常通过另一个响应头表达。
下面是服务端提供下载时的一组响应头示意:
Content-Type: application/pdf
Content-Disposition: attachment; filename="report.pdf"Content-Disposition中的 attachment 表示按附件处理,filename 提供建议文件名。如果希望采用常规的内联处理方式,可以使用 inline;但浏览器仍须具备对应格式的展示能力。
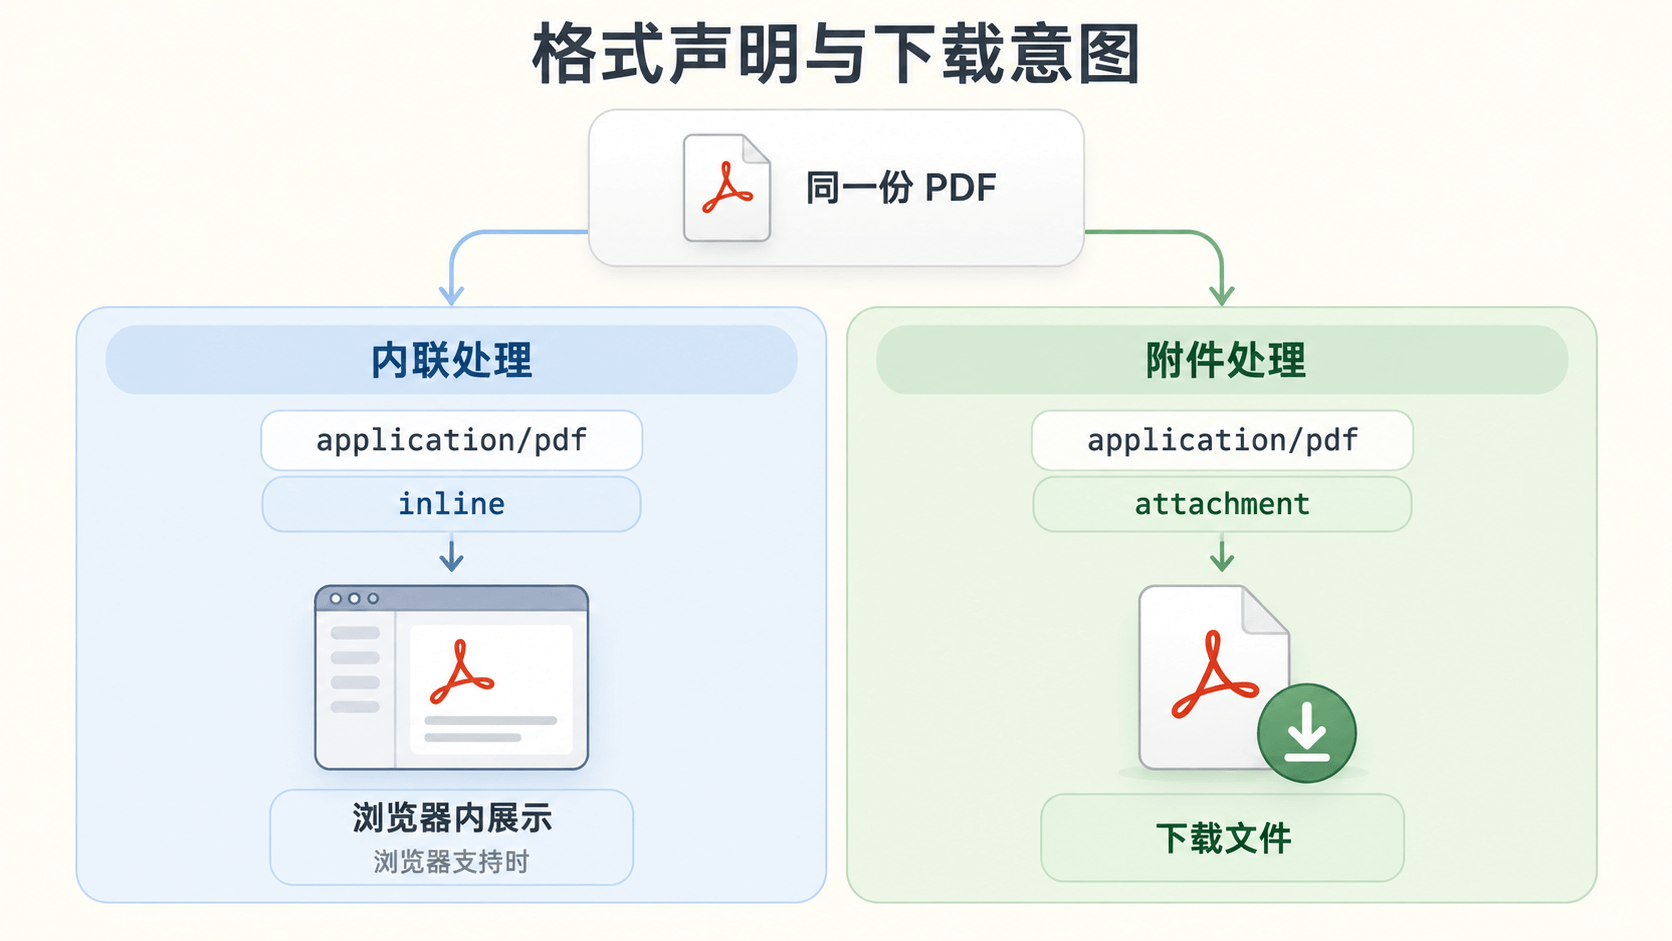
图中两侧的媒体类型都保持 application/pdf,改变的是处理意图。这也解释了实验里为什么 HTML 类型仍然能够触发下载。格式声明和下载意图可以同时成立,不用为了下载 PDF 就把正确的 application/pdf 强行改成通用类型。
application/octet-stream 常见于通用二进制下载,但它描述的是类型,不能完整替代 attachment 的作用。对于已知格式,优先返回真实类型,再明确表达下载意图。
中文文件名可以使用 filename* 的编码形式,同时保留 ASCII 回退名:
Content-Disposition: attachment; filename="report.pdf"; filename*=UTF-8''%E6%8A%A5%E5%91%8A.pdf其中编码的文件名是「报告.pdf」。RFC 6266规定了 filename 与 filename* 的处理关系,也强调文件名是建议信息,接收方不能直接把服务端提供的路径当成本机写入位置。
是否弹出「另存为」窗口,还受浏览器设置影响;有的环境会直接保存到默认下载目录。用户通过保存操作、下载链接或浏览器设置,也可以影响最终动作。inline 无法保证每个用户都会在标签页内看到内容。
<a download> 也能表达下载意图
页面可以在链接上写 download:
<a href="/report.pdf" download="monthly-report.pdf">下载报告</a>属性表达下载意图,并提供建议文件名,不会把 PDF 内容转换成另一种格式。它通常适用于同源地址、同源 Blob URL 和 data: URL;直接给任意跨源链接加 download,不能保证生效,跨源服务器仍可以通过 Content-Disposition: attachment 提供下载。
浏览器采纳 download 时,可以优先于 Content-Disposition: inline 的内联意图;但响应头中的 filename又可能优先于属性建议名。本地 Chrome 实验里,同源文本响应带着 inline 时,链接仍触发下载,建议名为属性中的 client.txt;响应头再提供 filename="server.txt" 后,建议名变为 server.txt。最终名称还可能经过浏览器和本机文件系统的调整。
程序通过跨源 fetch()获取文件、并想读取服务器建议文件名时,还需要响应头对脚本可见。Content-Disposition不是默认暴露的 CORS 安全响应头;在其他跨源许可已经满足的基础上,服务端可以通过 Access-Control-Expose-Headers: Content-Disposition允许读取它。直接导航下载与脚本读取下载响应,权限要求也不同。
document.contentType 能看到什么
浏览器已经创建文档以后,页面脚本可以读取:
document.contentType; // 例如 'text/html'
document.characterSet; // 例如 'UTF-8'
正确拼写是 contentType,其中 T 大写。JavaScript 属性名区分大小写,在普通页面里写 document.contenttype 通常得到 undefined。
document.contentType返回当前文档正在采用的 MIME 类型。DOM 标准中的属性定义对应文档自身的内容类型信息;它不是把原始 HTTP 响应头完整复制出来。
实验中,服务器发送 text/html; charset=utf-8,属性返回 text/html,编码由 document.characterSet 另行体现。服务器没有发送类型时,浏览器仍可能创建 HTML 文档,并返回 text/html。
它描述当前文档,不遍历页面资源
页面里加载十张图片、三个脚本和一个接口响应,仍然只有当前页面这个 document。读取 document.contentType,不会告诉我们某个 <img> 的 MIME 类型,也不会告诉我们刚刚下载到本机的文件是什么。
对于附件下载,本次导航没有创建该附件的内容文档,当前标签页中留下的文档也不能替代下载文件本身。PDF 阅读器、扩展页面和其他查看器还可能存在额外的文档包装,应结合具体环境判断。
因此,「能看到浏览器最终确定的 MIME 类型」适合作为当前文档范围内的简要描述。把它当成通用文件鉴定 API,就扩大了这个属性的能力。
<meta> 也不能让这个只读属性随意改变。在 HTML 里提供字符编码信息,与用 HTTP 响应头声明资源类型,是两个层次;一段被当成纯文本展示的 <meta>,不会自行把整个响应重新解释成网页。
看服务端声明,使用 Network 或响应头 API
在 Chrome DevTools 的 Network 中选中请求,查看 Response Headers 里的 Content-Type,可以知道浏览器实际收到的响应声明。再看 Response 正文,就能判断返回的是预期资源,还是登录页、错误页或应用入口 HTML。
程序里可以通过 Response.headers读取同源或允许跨源读取的响应头:
const response = await fetch('/api/items');
console.log(response.status);
console.log(response.headers.get('content-type'));
这里拿到的仍是响应声明,没有调用浏览器的通用内容鉴定服务。跨源读取还受到 CORS 等规则限制,不能通过改成 no-cors 获得任意网站的响应头和正文。
Network 列表的 Type 列主要帮助辨认请求或资源类别,不能代替原始 Content-Type 字段;同样,HTML 文档的 MIME 类型也不能代替所有子资源的响应信息。
类型、编码和协商各自负责什么
HTTP 里有几个相邻字段容易混在一起。把它们放回请求和响应的方向,作用就比较清楚。
| 信息 | 典型位置 | 作用 |
|---|---|---|
Accept |
请求头 | 表达客户端能接受的响应类型及偏好 |
Content-Type |
请求头或响应头 | 描述本条消息相关内容的媒体类型 |
charset |
Content-Type 参数 |
在适用类型中说明字符编码 |
Content-Encoding |
表示元数据 | 说明 gzip、br 等内容编码 |
Content-Disposition |
下载等响应中 | 表达内联、附件和建议文件名 |
X-Content-Type-Options |
响应头 | 约束相关类型嗅探与执行检查 |
Accept 是偏好,Content-Type 是本次声明
客户端可以用 Accept说明自己接受的类型。例如,图片请求可能接受 AVIF、WebP 和其他图片格式;服务端再选择实际返回哪一种。
因此,同一个 /cover 地址,可以根据请求条件返回不同图片格式。URL 没变,本次响应的 Content-Type 却可以变化。q 参数还能表达相对偏好,服务端是否满足、无法满足时怎样处理,则由协商规则和服务端行为决定。
采用内容协商时,还要正确处理缓存。例如根据 Accept 选择图片格式,就需要让缓存知道这个请求头参与了响应选择,常见做法是 Vary: Accept。否则缓存可能把为一种客户端生成的内容复用给另一种客户端。
压缩后的 HTML 仍然是 HTML
一个压缩传输的页面可以同时包含:
Content-Type: text/html; charset=utf-8
Content-Encoding: br
Content-Encoding: br说明内容使用 Brotli 编码;接收方解除相应内容编码后,得到的是按 UTF-8 编码的 HTML。它不应仅因为传输时经过压缩,就改标为压缩归档类型。
网页中文乱码时,优先核对实际字节编码、声明的 charset 和文档编码规则;图片破损时则要看图片数据及解码。两者都涉及字节,但问题发生在不同层次。
JSON 又有自己的约定。RFC 8259要求开放系统间交换的 JSON 使用 UTF-8,并且 application/json 的注册没有定义 charset 参数。不要从 HTML 示例推导出每一种 MIME 类型都需要附带同样的编码参数。
response.text() 固定按 UTF-8 解码
Response.text()使用 UTF-8 解码响应体,不会因为响应写着 charset=gbk,就自动切换到 GBK。这与导航创建文档时采用的字符编码处理规则不同。
本地实验让服务器返回 GBK 编码的「中文」,字节为 D6 D0 CE C4,并声明 Content-Type: text/plain; charset=gbk。地址栏导航能正确显示「中文」,fetch()后的 text()却得到四个替换字符 ����;读取字节后按 GBK 解码,才恢复原文:
const response = await fetch('/legacy-text');
const bytes = await response.arrayBuffer();
const text = new TextDecoder('gbk').decode(bytes);TextDecoder让程序显式选择受支持的文本编码。处理旧接口时,需要知道实际编码,再选择正确的读取方法;改 MIME 主类型、改文件扩展名,都不能解决解码方式不匹配造成的乱码。
请求体也需要描述类型
浏览器向服务端发送 JSON 时,请求头可以声明 Content-Type: application/json。服务端据此选择解析方式,再对字段做业务校验。请求里的类型描述发送的数据,响应里的类型描述返回的数据,两者可以不同。
上传文件常用的 multipart/form-data,会把消息分成多个部分,每部分还可以携带自己的类型。boundary 参数负责标记部分之间的边界,这也是它不能只写一个类型名就结束的原因。
使用浏览器的 FormData 发送请求时,应让浏览器生成对应的 Content-Type 和 boundary。手动只设置 Content-Type: multipart/form-data,容易让请求头缺少正文实际采用的边界信息。FormData 的使用说明专门提醒了这一点。
File.type 和 Blob.type 也只是类型信息
文件上传界面里,经常能读到 file.type === 'image/png'。它看起来像浏览器已经验证过文件,实际并不能承担这样的保证。
Blob.type返回关联的类型字符串;File 继承相关能力,浏览器通常不会为了填充这个属性,完整读取并鉴定文件内容,识别结果也可能为空。手动创建 Blob 时,调用者还可以直接指定标签:
const blob = new Blob(['这是一段文字'], { type: 'image/png' });
blob.type; // 'image/png'
这没有生成 PNG,只是给文字字节附上了一个类型字符串。因此,上传流程不能只检查客户端的 file.type、文件名或用户提交的 Content-Type。服务端仍须根据业务需要限制大小、验证实际格式并使用合适的处理方式;涉及公开展示的内容,还要考虑隔离与执行能力。
data: 与 blob: 的类型来自哪里
对于 data: URL,类型可以直接写进 URL,例如 data:text/plain,Hello;data:image/png;base64,…则在类型后标记正文采用 Base64 表达。Base64 是字节的编码方式,不能替代媒体类型,也不会把文字转换为 PNG。
data: URL 的语法规定,省略媒体类型时默认采用 text/plain;charset=US-ASCII。它没有经过 HTTP 响应头传递,接收方仍能从协议规定的位置获得类型信息;后续使用仍受 URL 协议和加载上下文的规则限制。
blob: URL 则关联浏览器保存的 Blob 对象,类型来自该对象的 type。URL 外观里通常只有源信息和不透明标识,不需要出现 .png 或 .pdf 扩展名。结合行内 HTML、srcdoc和本地 file:等场景,可以看出 MIME 类型的来源与 HTTP 的 Content-Type 响应头不能完全画等号;具体内容的处理还要回到对应协议和入口。
从 MIME 报错找到实际问题
资源已经返回却不能使用时,优先核对请求用途、实际响应头和正文,URL 后缀只能提供线索。
| 现象 | 优先检查 |
|---|---|
| JavaScript 模块报 MIME 类型错误 | 请求最终地址、重定向链、Content-Type,正文是否是登录页或 SPA 回退页 |
| Worker 加载失败 | 普通或模块模式、实际脚本响应、nosniff、来源限制和 CSP |
| Wasm 流式编译报类型错误 | 是否返回 application/wasm,正文是否为有效 Wasm |
| CSS 请求成功但样式未生效 | 是否返回真实 CSS,类型是否为 text/css,是否被 MIME 检查或其他策略阻断 |
| 图片显示失败 | 是否返回预期图片字节,是否损坏,格式与浏览器解码能力是否匹配 |
| PDF 意外下载 | Content-Disposition、实际类型、浏览器 PDF 设置和加载方式 |
| 下载后文件打不开 | 正文是否其实是错误 JSON 或 HTML,建议文件名与真实格式是否一致 |
导航显示正常,fetch().text() 却乱码 |
实际字符编码是否为 UTF-8,是否需要显式解码 |
| 修改源站类型后仍得到旧结果 | CDN、浏览器缓存、代理和 Service Worker 是否仍在提供旧响应 |
排查时先保留原始证据,再确认该修哪一层。路由返回了错误页面,要修路由;服务器漏配媒体类型,要修响应声明;文件损坏,要修生成或存储过程;安全规则挡住资源,要核对它是否符合当前使用场景。
回到开头的问题,可以给出一段更完整的回答:
HTTP 场景中,浏览器主要从
Content-Type响应头取得 MIME 类型,并在规则允许时结合内容字节进行嗅探。扩展名可能帮助服务器生成类型声明,但不能单独决定浏览器如何处理响应。最终是渲染、解码、执行、拒绝还是下载,还取决于加载场景、安全检查、浏览器能力和Content-Disposition等信息。document.contentType可以查看当前文档采用的类型,不能替代任意资源的响应头查询或文件校验。
放回「从输入 URL 到页面展示」的过程,浏览器选定 URL 后,还需要选定合适且被允许的内容处理路径。只有响应进入 HTML 文档的处理流程,才会继续展开熟悉的 HTML 解析、DOM 构建、布局和绘制;图片、媒体和下载会沿各自的路径继续。