别再用 length 统计用户文本:一次 Unicode 字符数和 ESLint 护栏复盘(4):关于 CSS 分词场景的例外
别再用 length 统计用户文本:一次 Unicode 字符数和 ESLint 护栏复盘
- 用户眼里的一个字,与 UTF-16 的一个单元
- 计数、截断与输入框必须共用边界
- 用 ESLint 发现用户文本的危险操作
- 关于 CSS 分词场景的例外(当前)
给 UnoCSS 和 Tailwind CSS 的 @apply 写 Prettier 换行插件时,ESLint 对分词函数里的 params.length 和 params.slice() 报了警告。规则来自一次用户文本字数的复盘。昵称里有个 😀,用 length 会算出两个字,用 slice() 按字数截断也可能切坏它。看起来顺手把格式化插件换成同一套 Unicode 工具就行了。
用实际的 sheng-tool 函数试过之后,带 emoji 的 @apply 反倒卡在了同一个空格上。后来又发现,有些看上去能换行的空格,其实属于 CSS 转义。两个问题都要找到正确的切口,但一个错在下标单位,另一个错在语法判断。
扫描经过 emoji,切口还在空格处
Prettier 的 CSS parser 先识别出 @apply,再把参数交给插件。params 是普通的 JavaScript 字符串。例如下面这条指令的参数是 [content:"😀"] flex。换行插件从里面找能断开的候选边界,最后才用 slice() 取出原片段。
.card {
  @apply [content:"😀"] flex;
}
CSS Syntax 的解析模型把输入描述成 Unicode 码点流。JavaScript 字符串的下标和 .length 采用 UTF-16 代码单元。输入框想统计用户看到的「一个字」时,则按 Unicode 字素簇计算。
| 原文 | 码点 | UTF-16 单元 | 字素簇 |
|---|---|---|---|
| 😀 | 1 | 2 | 1 |
| 🇨🇳 | 2 | 4 | 1 |
| 👨👩👧👦 | 7 | 11 | 1 |
e\u0301 |
2 | 2 | 1 |
扫描器用 params[index] 读源码。遇到 😀 时会走过两个 UTF-16 位置,但两次读取都处于引号和方括号里面。真正调用 slice() 的时候,切口已经落在 ] 后面的分隔空格上,两个 UTF-16 单元都被保留在同一个候选里。这里的 .length 用来确定扫描终点。printWidth 的排版由 Prettier 的文档打印器负责。
只换掉 Lint 提示的 API 会发生什么
把输入缩短成 A😀 B,UTF-16 下标 3 对应空格。按字素数,空格的下标是 2,下标 3 对应 B。这两个位置都能用,取决于切片函数接受哪个单位。
import { sliceUnicodeCharacters } from 'sheng-tool';

const text = 'A😀 B';
text[3];                          // ' '
text.slice(3);                    // ' B'
sliceUnicodeCharacters(text, 3);  // 'B'
sliceUnicodeCharacters(text, 2);  // ' B'
在 @apply 的循环里,扫描器找到空格后,会对从该位置开始的子串匹配连续空白,再把下标跳到下一段。把 params.slice(index) 换成字素切片之后,匹配收到的子串开头可能已经是字母,匹配到的空白长度就成了 0。循环体把下标减 1,for 的更新表达式又加 1,下一轮仍回到同一个空格。我用 sheng-tool 的实际实现替换过这几处调用,并在实验里加了停滞检测,带 😀 的样例停在空格下标 14。单独替换 params.length 也可能让扫描提前结束,漏掉参数末尾的闭合方括号。
如果整套扫描也改成按字素走,A😀 B 这个例子当然能切对。要确认这种做法适不适合格式化,还得看源码允许在哪里分开。
一个字素里面也可能有语法分隔符
p-2 \u0301foo 中,\u0301 表示实际的组合尖音符。前面是一个普通空格 U+0020。Unicode 的 GB9 规则会把这两个码点放在同一个字素簇里,和 e\u0301 里的重音与 e 成组是同样的道理。Chrome 的 Intl.Segmenter 和 sheng-tool 在这个输入上得到了一样的分段。
字素分段    ["p", "-", "2", " \u0301", "f", "o", "o"]
类名分词    ["p-2", "\u0301foo"]
如果先按字素分段,再去找等于普通空格的那一项,就会漏掉这里的分隔符。按 CSS 字符定义读未加引号的文本,U+0020 在这个位置会读成空白 token,U+0301 可以作为下一个标识符的首码点。这个分隔位置恰好落在前面那个字素簇内部。
用 Chrome 看词法结果,再用字体对照显示结果
Chrome 的 Blink 分词器遇到普通空格,会消费连续空白并返回 kWhitespaceToken。Chrome 157.0.8103.39 的 CSSOM 也能验证这组边界。animation-name 的一个名字可以是标识符或带引号的字符串。对下列输入做 CSS.supports(),中间那个普通空格决定了未加引号的内容能否作为一个名字读入。
CSS.supports('animation-name', 'p-2 \u0301foo');   // false,两个标识符
CSS.supports('animation-name', 'p-2\u0301foo');    // true,一个标识符
CSS.supports('animation-name', '\u0301');         // true,尖音符本身也是一个有效码点
CSS.supports('animation-name', '"p-2 \u0301foo"'); // true,一个字符串
单个 token 也能包含多个码点。🇨🇳 和 👨👩👧👦 都可以直接作为 Chrome 里的 CSS 标识符。按键 emoji 1️⃣ 则以 ASCII 数字 1 开头,分词器会进入数字分支,导致 .1️⃣ 不是有效的类选择器。实测把类名交给 CSS.escape('1️⃣') 后,拼出的选择器可以匹配原来的 HTML 类名。放进 content: "1️⃣" 的引号里,整个序列是一个字符串值。
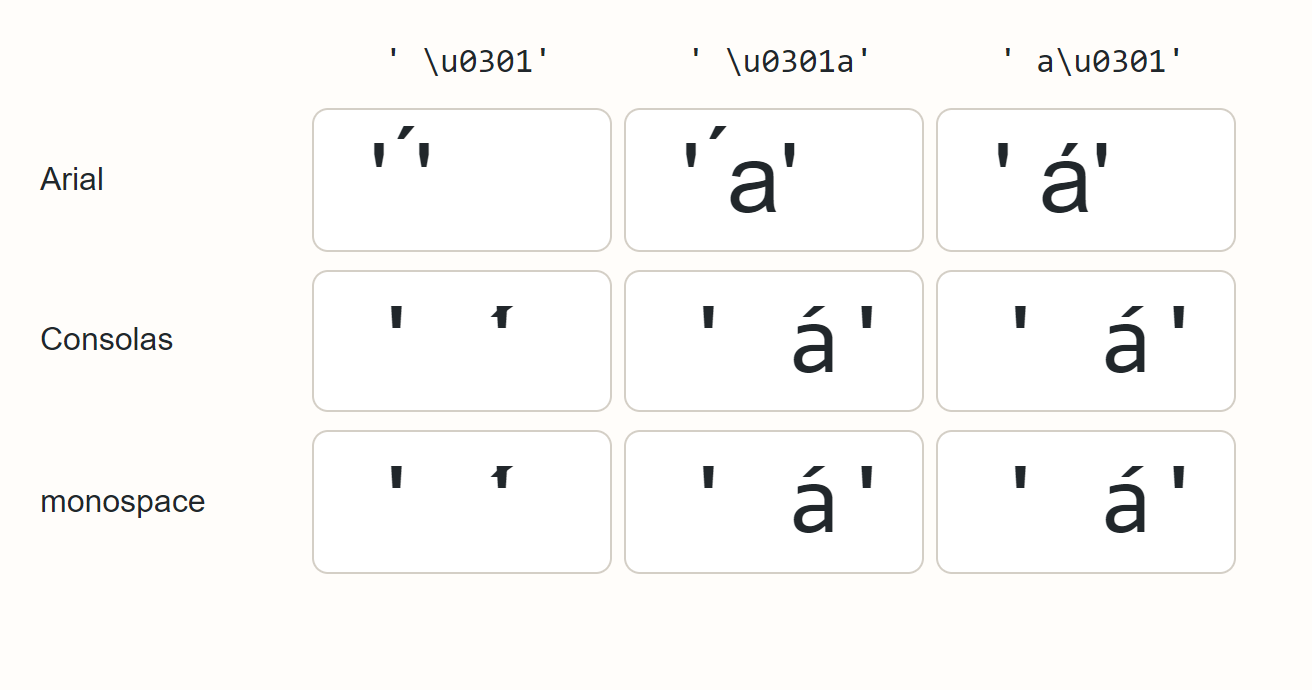
组合符号的渲染还受字体影响。在 Chrome 网页里用 Consolas 或默认等宽字体显示 ' \u0301a',尖音符可以正好画到后面的 a 上方,和 ' a\u0301' 看起来一样。换成 Arial,前者的尖音符明显在字母左边。两种输入在同一个浏览器里仍分成 [' \u0301', 'a'] 和 [' ', 'a\u0301']。看屏幕上的位置可以检查字体效果。要确认符号在字符串里的位置,直接查看码点和字素分段更可靠。
下图是 Chrome 157 的网页实拍,字号是 48 px,以 2× 像素倍率采集。从左到右分别是空格加尖音符、空格加尖音符再加 a、空格加 a 再加尖音符。
HTML 的 class 和构建工具的 @apply 各有规则
浏览器读 HTML 的 class 值时按 ASCII 空白拆类名。CSS 词法识别标识符、字符串和空白等 token。UnoCSS、Tailwind CSS 的 @apply 则由各自的编译器解释,分完候选还要查找有没有对应的工具类。三者在普通空格上经常得到相同的结果,换个分隔字符或加一层语法就可能不同。
| 输入 | 浏览器的 HTML classList |
@apply 实测 |
|---|---|---|
p-2 \u0301foo |
两个类名 | 都拆成两个候选。UnoCSS 注册第二个候选后能应用,Tailwind 单独报告未知候选 |
p-2\u00A0flex |
一个类名,中间的非断行空格保留 | 三个版本都展开 p-2 和 flex |
hover:(p-2 flex) |
按普通空格拆成两个类名 | UnoCSS 展开为 :hover 样式,两个 Tailwind 版本都报告未知候选 |
表里的 \u… 用来标出实际输入的码点。@apply 使用 UnoCSS 66.12.0 的 Wind3 与 directives transformer、Tailwind CSS 3.4.17 和 4.3.3。用这三个编译器把 [content:"…"] flex 中的 😀、🇨🇳 和 👨👩👧👦 分别在 flex 前强制折行,格式化前后的 content 与 display 声明一致。字符序列即使由多个码点构成,仍完整留在任意属性候选里。
空格进入转义后,换行会改变源码
CSS 在分词前把 CRLF、单独的 CR 和 FF 归一成换行。U+00A0 非断行空格不属于 CSS 的空白定义。Chrome 157 把 foo\u00A0bar 接受为一个标识符,但 CSS Syntax Level 3 候选推荐草案的非 ASCII 标识符范围排除了它。注释还有自己的规则。例如 foo/**/bar 会产生两个标识符 token,分词器会在读取下一个 token 前跳过注释,中间无需产生空白 token。
最容易漏掉的两个切口都在反斜杠附近。普通空格紧跟在有效的反斜杠后时,空格是标识符的内容。CSS 的十六进制转义能读取最多六个十六进制数字,还可以消耗后面的一个 CSS 空白。例如 text-\31 0,空格结束 \31,后面的 0 仍在同一个标识符内。中间写两个空格,第二个才起分隔作用。引号内的空格也会由字符串 token 保留。
十六进制转义中的空格
原分词器遇到反斜杠时只跳过紧跟的一个位置。在 text-\31 0 flex 里,它会误把 \31 后面的空格当作断点。行宽很小时,原本的一个 CSS 标识符就会变成一个标识符和一个数字 token。用 CSS tokenizer 对照过这个结果,Chrome 也能把换行前的 text-\31 0 解析成名为 text-10 的标识符。这个样例用于检验 CSS 词法,实测 Tailwind CSS 4.3.3 在格式化前就会报告未知候选 0。
现在插件会越过整个十六进制转义及其消费的空白,继续寻找下一个可断开的位置。若一个候选以转义空白结束,后面还有另一个候选,插件交回默认打印器,避免 Prettier 的自定义折行把该空白作为行尾空格清理。
分号前的转义空格
@apply foo\ ; 的空格离分号只有一步。Prettier 3.9.10 的 PostCSS 解析结果中,params 是 foo\,那个空格在 raws.between。只打印 params 再拼上分号,就得到 @apply foo\;。反斜杠会转义分号,原来的指令边界随之改变。
现在插件确认参数末尾有奇数个连续反斜杠后,从 raws.between 取回紧跟的普通空格或 Tab。两个反斜杠互相转义时,后面的普通空白仍可以归一化。窄行宽下,前面的候选照常折行,末尾被转义的空白和分号一起输出。
.card {
  @apply flex
    foo\ ;
  color: red;
}
回归测试覆盖了 CSS、SCSS、Less 和 Vue 样式块里的这条指令,也检查再次格式化能否得到相同结果。有 Sass 插值、无法安全拆分候选时,插件保留原参数的排版和末尾的转义空白。另用 Sass 编译了带插值的样例,对照格式化前后的 CSS token 一致。
总结
处理昵称、预览和输入框限长时,可以用 sheng-tool 的字素工具统一用户看到的字数。处理源码时,先看语法允许在哪里切,再确认边界位置以什么单位记录。对当前的 splitApplyTokens() 来说,params[index]、params.length 和 params.slice() 共同使用原字符串的 UTF-16 下标,所以把 ESLint 豁免限定在这个函数里,并在注释里交代偏移单位。
如果后续有多个工具确实要共享这套逻辑,适合复用的是「返回可以安全换行的源码范围」。标准 CSS 的词法交给 tokenizer,工具类分组和动态参数按对应语法处理。这类输入也属于相关 ESLint 规则允许的技术字符串例外。格式化后的内容仍要交给同一套编译器验证,确认生成的样式一致。
上一篇:用 ESLint 发现用户文本的危险操作。