从搜索动效原型到 Nuxt 应用:滚动、正文渲染和工程边界
做这个搜索工具时,我先找了一份喜欢的动效参考:The Collaboratory — Refine Search。输入框从首页移到结果页,资料旁边有相关、不相关和收藏操作,选中的资料再进入细化面板。这套交互比单纯堆一个搜索框和列表更有意思,适合做一个可以逐步整理线索的小工具。
演示数据很容易把效果撑起来。真正接上搜索接口,问题才陆续出现:一篇长摘要让整个弹窗开始滚动,标题和关闭按钮一起消失;上游文本里有 #,页面却把它当普通字符;1920px 屏幕两侧空得明显,换成系统深色主题又仍是一片白。
静态 Nuxt 前端与 ESA 服务端
项目选择了 Nuxt,但部署前端时使用 ssr: false 和 nuxt generate,输出静态单页应用。搜索 API 另外打包给 ESA 边缘函数,两边通过同源 /api/* 通信。
这里容易误会的一点是:源码里有 server/api,不代表静态生成以后这套服务端路由也会继续运行。Nuxt 的静态部署说明区分了静态产物和服务器部署;只有静态文件的托管环境不会替应用运行 Nitro API。
因此,搜索、密码会话、输入校验和上游错误转换都放在 server/search。本地 Nuxt 路由与 ESA 的 fetch 入口分别做平台适配,然后调用这份共享实现。这样本地开发和边缘部署不会各自长出一套搜索逻辑。
构建的两个输出也分开维护:.output/public 只放公开静态资源,.edge/worker.js 放服务端入口。这个项目里 Nuxt 会把 dist 链接到静态目录,如果把服务端 bundle 顺手放进 dist,就可能进入公开资源目录。构建末尾因此增加了产物边界检查。
API Key 留在服务端。浏览器提交搜索词,收到规范化后的结果,不需要知道调用 DeepSeek 的凭据。
先决定谁滚动,再选择滚动条库
阅读弹窗的旧结构把整个 dialog 当成滚动容器。内容短时看不出问题,长正文一出现,标题栏、关闭按钮和来源入口就会离开视口。
弹窗应该先分成 Header、Body 和 Footer。Header 放标题与关闭入口,Footer 放来源入口或主要操作,只有 Body 滚动。实现里的关键约束很少:
// 布局节选:正文可以收缩,标题与操作区保持可见。
.common-dialog__frame
  display flex
  flex-direction column
  max-height calc(var(--dialog-max-height) - 2px)

.common-dialog__header
.common-dialog__footer
  flex none

.common-dialog__body
  flex 1 1 auto
  min-height 0
  overflow auto
min-height: 0 很重要。Flex 子项默认的最小尺寸可能受内容撑开,结果会变成外壳超过视口,正文仍然没有进入预期的滚动区域。最大高度还要扣掉外壳边框,避免 Footer 最下面被裁掉。
滚动条增强交给 OverlayScrollbars。页面、阅读正文、收藏列表和反馈列表使用统一主题,滚动条覆盖在内容上,不挤占原有布局宽度。局部容器用 object 初始化,把 target 和 elements.viewport 都指向原元素,保留原有的 scrollTop 与滚动事件语义。
页面级初始化与局部容器有一个差异:传入 document.body 后,库在当前浏览器使用的是根元素 viewport。只检查 body 有没有属性,会误以为滚动条没有接入。背景滚动锁同样要对准真正滚动的元素。
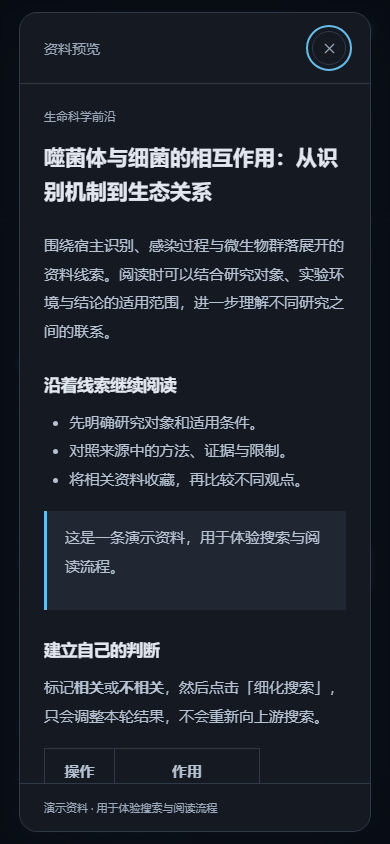
这类问题不能靠一张弹窗截图验收。我用长 Markdown 样本让正文产生足够的溢出,分别记录滚动前后的 Header、Body 和 Footer 的位置。正文的 scrollTop 必须增加,Header 和 Footer 的位置应保持不变;还要在弹窗外滚轮,确认背景页面没有跟着滚。
摘要字符串、Markdown 和网页全文是三件事
原来的预览只是把上游字符串放进一个 <p>:即使文本包含 Markdown 标记,也只会按普通文本显示。问题不在接口丢了格式,而在界面没有解析文本结构。
不过,也不能因此认定所有搜索结果都是 Markdown。DeepSeek Search 的 schema把 snippet 和 summary 定义为字符串:前者用于短摘要展示,后者提供更长的查询相关摘要。Fetch 接口才明确承诺返回 Markdown 正文。
项目使用 markdown-it 展示预览,普通文本自然落成段落,带 Markdown 的文本可以生成标题、列表、引用、代码和表格。当前预览依然是搜索摘要,完整阅读通过来源链接完成,还没有调用 Fetch。
不可信网页内容进入 v-html 前,也需要确定允许什么。当前解析器设置 html: false,原始 HTML 作为文本展示;链接继续接受解析器的协议检查,外链补上 noopener noreferrer。对应测试会检查 <script>、带事件的图片标签和 javascript: 链接,而不是只测正常的标题渲染。markdown-it 的安全说明也应随着插件和配置变更重新核对;将来如果允许原始 HTML,还需要重新设计清洗边界。
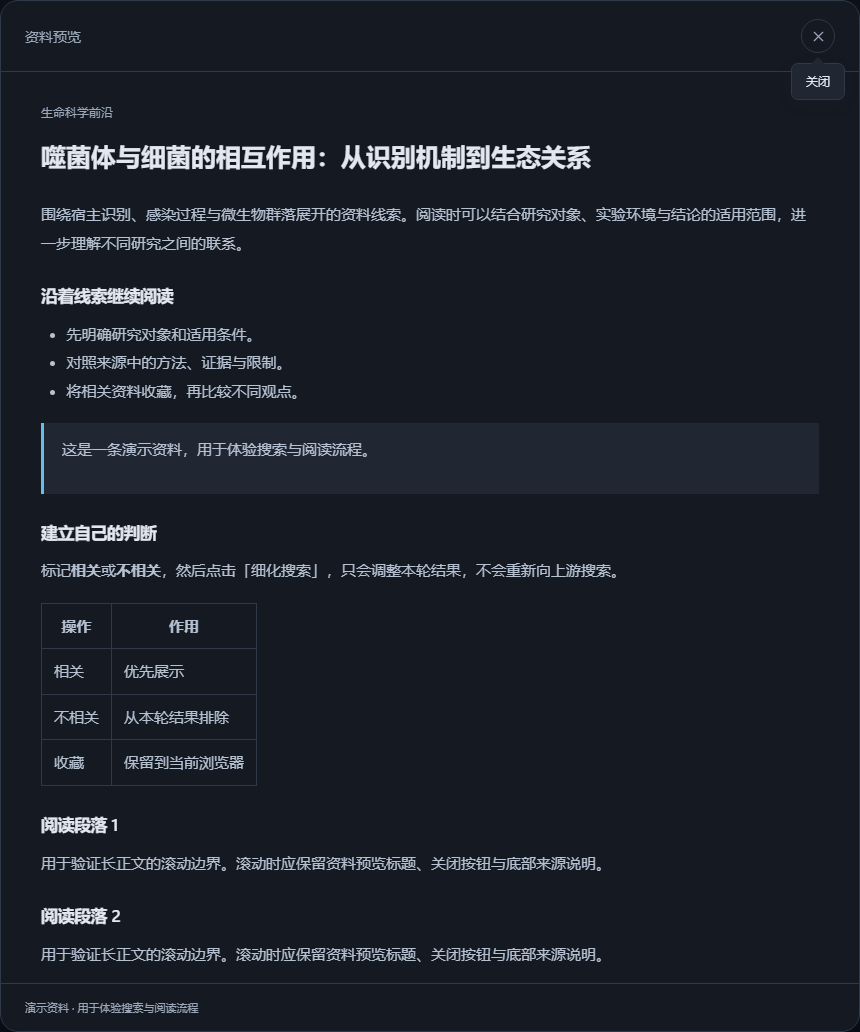
演示数据也要走同一条渲染链路。演示里单独写一套富文本 HTML,真实结果却只用 <p>,很容易让原型展示出实际应用并不具备的能力。
宽屏布局、深色主题与提示层级
原来的布局同时限制了主列宽度和内容区起点。窗口越来越宽,结果列没有相应增长,左侧起点却继续向中间移动,因此 1920px 下会留下很多空白。
调整后,内容区在 1920px 下最大为 1540px,主列随可用空间增长,侧栏保留固定宽度;手机断点继续使用单列。这里改的是阅读空间的分配,没有把所有控件跟着等比放大。
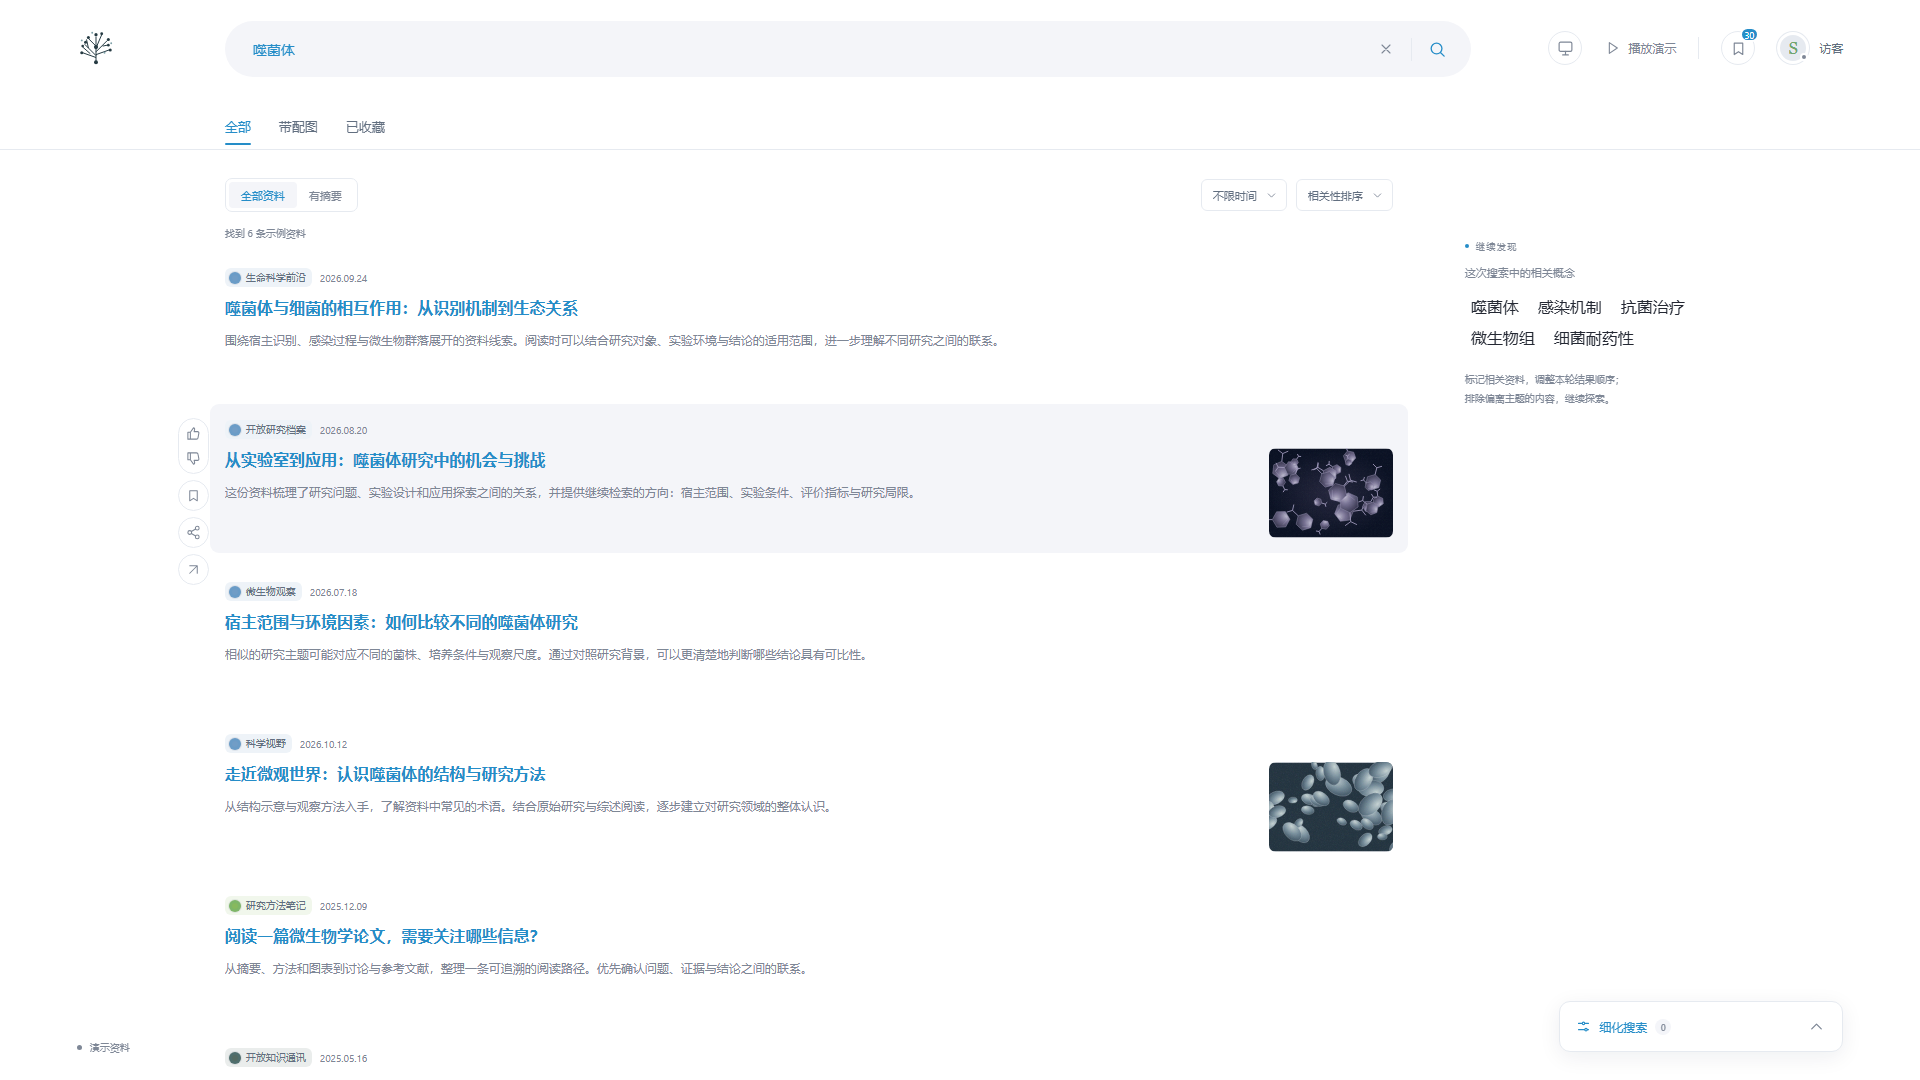
深色模式通过根节点的 data-theme 切换颜色变量。页面、卡片、表单、对话框、Tooltip 和滚动条都读取同一套背景、文字、边框和状态色。主题入口提供跟随系统、深色和浅色三种状态,并在浏览器保存选择。
图标按钮的说明则从原生 title 换成 Tippy。延迟、主题和触屏触发方式可以统一,键盘 focus 也能触发提示。按钮仍然保留 aria-label,可访问名称不依赖悬停。
这里还有一个层级问题:原生 dialog 进入浏览器的 top layer,挂在 body 下的 Tooltip 可能被盖住。因此提示优先追加到最近的 dialog 内,再检查定位和裁剪;只调一个很大的 z-index 不能解决所有 top layer 问题。Tippy 的属性文档提供了 appendTo、触发方式和定位配置。
私有逻辑放回页面,样式放回组件
最初几个 composable 都放在全局 app/composables,实际上只有搜索页面使用。页面同时承担请求、收藏、反馈、演示、筛选和一大段模板,组件样式又集中在一个全局 CSS 文件里。
这轮整理把请求、收藏、反馈、演示和筛选分别放进搜索页面目录的 composables,由页面显式导入。请求模块拥有原始 response,筛选模块根据 response、收藏集合和已应用反馈派生列表,不改写服务端结果。反馈面板编辑的是当前标记,点击细化才生成应用快照,避免边编辑边改写正在阅读的结果。
阅读、密码输入等组件共用一个通用对话框;Markdown 渲染也有单独组件和私有格式器。业务组件目录使用 index.vue,自己的布局和状态样式放在 scoped Stylus;全局文件只保留 reset、颜色变量、共享按钮样式和第三方库主题。
组件间的 DOM 定位也改为显式入口。反馈动画由结果按钮提供起点,反馈面板暴露自身按钮的目标位置,页面负责连接两者。这样就不用让一个 composable 靠全局 ID 猜另一个组件在哪里。
Nuxt 自动导入仍然负责框架 API 和组件。页面私有的 composable 使用相对路径导入,是为了保留所有权边界;不需要把所有文件都放进自动扫描目录。
选择 Pug 或 Stylus 后,要同时验证格式化、Lint、类型检查和构建链路;语法更短并不自动减少工具维护成本。完整内容见Pug 与 Stylus 的检查链路弹窗。
搜索界面不能提前承诺接口没有接上的能力
最后核对了一遍 DeepSeek 的接口和界面的实际含义。当前应用只使用基础 Search,请求 20 条结果,展示标题、来源、日期和摘要。搜索框可以原样传递官方搜索语法,例如 site:、排除词、精确短语、语言和日期条件。
其他能力仍然有明确的接入范围:
| 能力 | 应用现状 |
|---|---|
ori_question、localization |
未发送,没有查询改写与基于 IP 的本地化 |
need_content 与搜索正文 |
固定为 false,未请求正文 |
| Fetch 单页 Markdown | 未接入,预览提供原网页入口 |
rerank_score、authority、site_icon |
未展示,默认保留上游结果顺序 |
| 时间下拉、收藏、相关性标记 | 作用于当前浏览器或本轮结果 |
| 生成带引用的回答 | 未接入模型,Search 本身不负责生成答案 |
Search schema 没有独立图片搜索接口,站点图标也不能当成文章配图。「带配图」只能筛选当前数据里已有配图的资料。类似地,点击「细化搜索」目前只是重排和排除本轮结果,不是让 DeepSeek 按反馈重新搜索。
如果下一步增加全文阅读,我会优先在打开资料时按需调用 Fetch,处理缓存、失败与来源回退;如果要生成回答,再单独接入模型和引用管理。
总结
演示数据能撑起搜索动效,却没有替应用确定内容和状态的边界。长摘要限制在正文区域滚动,标题和操作便能保持可见。演示与真实结果共用渲染链路,让预览的格式能力与实际一致;原始响应保留不动,细化只调整派生列表,避免把反馈误写成上游返回的内容。部署时也一样,静态前端不会继续运行服务端路由,搜索实现和凭据需要明确的服务端入口,服务端产物也不能混进公开目录。
当前搜索仍是基础 Search 的摘要展示和本轮结果整理,尚未接入 Fetch 全文、反馈重搜或模型回答。Pug、Stylus 的接入需要编译、lint、类型反例与实际产物共同验证;本地演示响应通过,只覆盖了受控数据下的检查,不等于真实上游请求成功。
Pug 与 Stylus 的检查链路
Pug / Stylus 可以用,检查工具也要跟过去
这次还尝试了 template lang="pug" 和 style lang="stylus"。缩进表达层级以后,HTML 结束标签和 CSS 大括号减少,阅读组件结构确实更紧凑。不过,长属性列表仍然需要换行,不能把所有表达式压成一行来换取行数减少。
真正需要付出的成本在工具链。除了安装 Pug 和 Stylus,还接入了 Nuxt ESLint、@sheng/eslint-plugin、Pug tokenizer、Vue 的 Pug language plugin,以及对应格式化插件。
编译器、Lint 和类型工具各自处理不同的内容:
| 检查 | 负责什么 | 如何确认没有漏掉 Pug |
|---|---|---|
| 生产构建 | 模板和样式能否编译成实际产物 | 生成静态前端与 ESA bundle |
| ESLint | Vue 语义和工程约束 | 带原生 title、缺少 key 的反例必须报错 |
| vue-tsc | 模板表达式的类型 | 数字调用 toUpperCase() 必须报错 |
| Formatter | 缩进与代码排版 | 格式化后再次检查,结果应稳定 |
vue-eslint-parser提供了 Pug tokenizer 入口,但它不代表完整 Pug 语言的所有特性都能被 Vue 规则理解。项目继续使用 v-if、v-for,没有混入 Pug 原生循环、mixin 或 include。HTML 结束标签之类的排版规则则按文件类型关闭,交给 Pug formatter;模板语义规则继续运行。
Stylus 还有一个实际遇到的冲突:它的内置 min() 会在构建时比较参数,CSS 的 min(680px, calc(100vw - 48px)) 却需要浏览器结合视口计算,结果出现了 cannot coerce ... to unit。最终只在需要原样输出的位置使用 unquote(...):
// 交给浏览器计算,不调用 Stylus 内置的数学 min。
width unquote('min(680px, calc(100vw - 48px))')
color-mix(in …) 也需要类似处理,避免 parser 把 in 当作语言关键字。格式化插件还可能依赖另一版 Stylus parser,所以格式化通过以后,仍然要跑生产构建并检查生成 CSS。
当前验证环境是 Nuxt 4.6.2、Vue 3.5.44、vue-tsc / Pug language plugin 3.3.13 和 Stylus 0.64.0。pnpm check 包含 lint、类型检查、Pug 类型反例、27 项测试和格式检查;pnpm build 另外验证静态资源与服务端 bundle 的边界。浏览器检查使用本地演示响应,不把模拟数据的通过当成真实上游请求的成功。
阅读基础组件的快照放在下面,包含对话框、Markdown、滚动条、Tooltip 和配置片段。源码区用于阅读,迁移时仍需合并目标项目已有的主题与插件。
请读取 /files/nuxt-search-prototype-engineering/kits/nuxt-reading-ui/ 下的
README.md、MANIFEST.json、FILES.json 和 AGENT_PROMPT.md,按文件索引将阅读 UI 合并到当前 Nuxt 项目,完成长正文、主题、键盘和生产构建验证。