正则为什么会卡死:ReDoS、非回溯引擎与 ESLint 护栏
一个校验函数只有一行正则,输入正常时几乎感觉不到耗时;把输入末尾换成一个不符合规则的字符,它却可能长时间占满 CPU。表达式没有死循环,字符串也未必有多长,问题出在匹配失败之前,引擎尝试了太多条路径。
这种问题叫 ReDoS(Regular expression Denial of Service,正则表达式拒绝服务)。攻击者让程序花费大量时间匹配特定输入,正常请求因此无法及时得到处理。业务代码固定了正则也可能受到攻击,攻击者只要能控制被匹配的字符串,就有机会触发它。
JavaScript 工程可以通过线性匹配库、ESLint 检查和执行预算降低这类风险。原生 RegExp 没有可移植的单次匹配超时参数;判断一段代码是否可控,需要同时看表达式、输入、调用方式和实际引擎。下面涉及版本与默认值的结论,以 2026-10-17 核对的文档、源码和本地运行结果为准。
从一次失败匹配看回溯
先把问题放进一个实际校验需求:输入必须是非空的小写十六进制文本,只需要返回布尔值。下面两条正则都接受 f09a、拒绝 f09a!,但第一条存在多余的重复层次:
// 反例:内外两层 + 都能分配同一串十六进制字符
const ambiguousHex = /^([0-9a-f]+)+$/;

// 正例:这项布尔校验只需要重复一次字符类
const hex = /^[0-9a-f]+$/;
问题出在 ([0-9a-f]+)+:内部的 + 可以一次吃掉 ffff,外部的 + 也允许把它拆成 ff / ff、f / fff 或更多组。输入全都合法时,第一种分配就能成功;输入是很长的 f 加一个 ! 时,最后的 $ 无法通过,引擎才可能不断换一种分组重试。! 始终无法匹配,但失败之前的工作会越来越多。
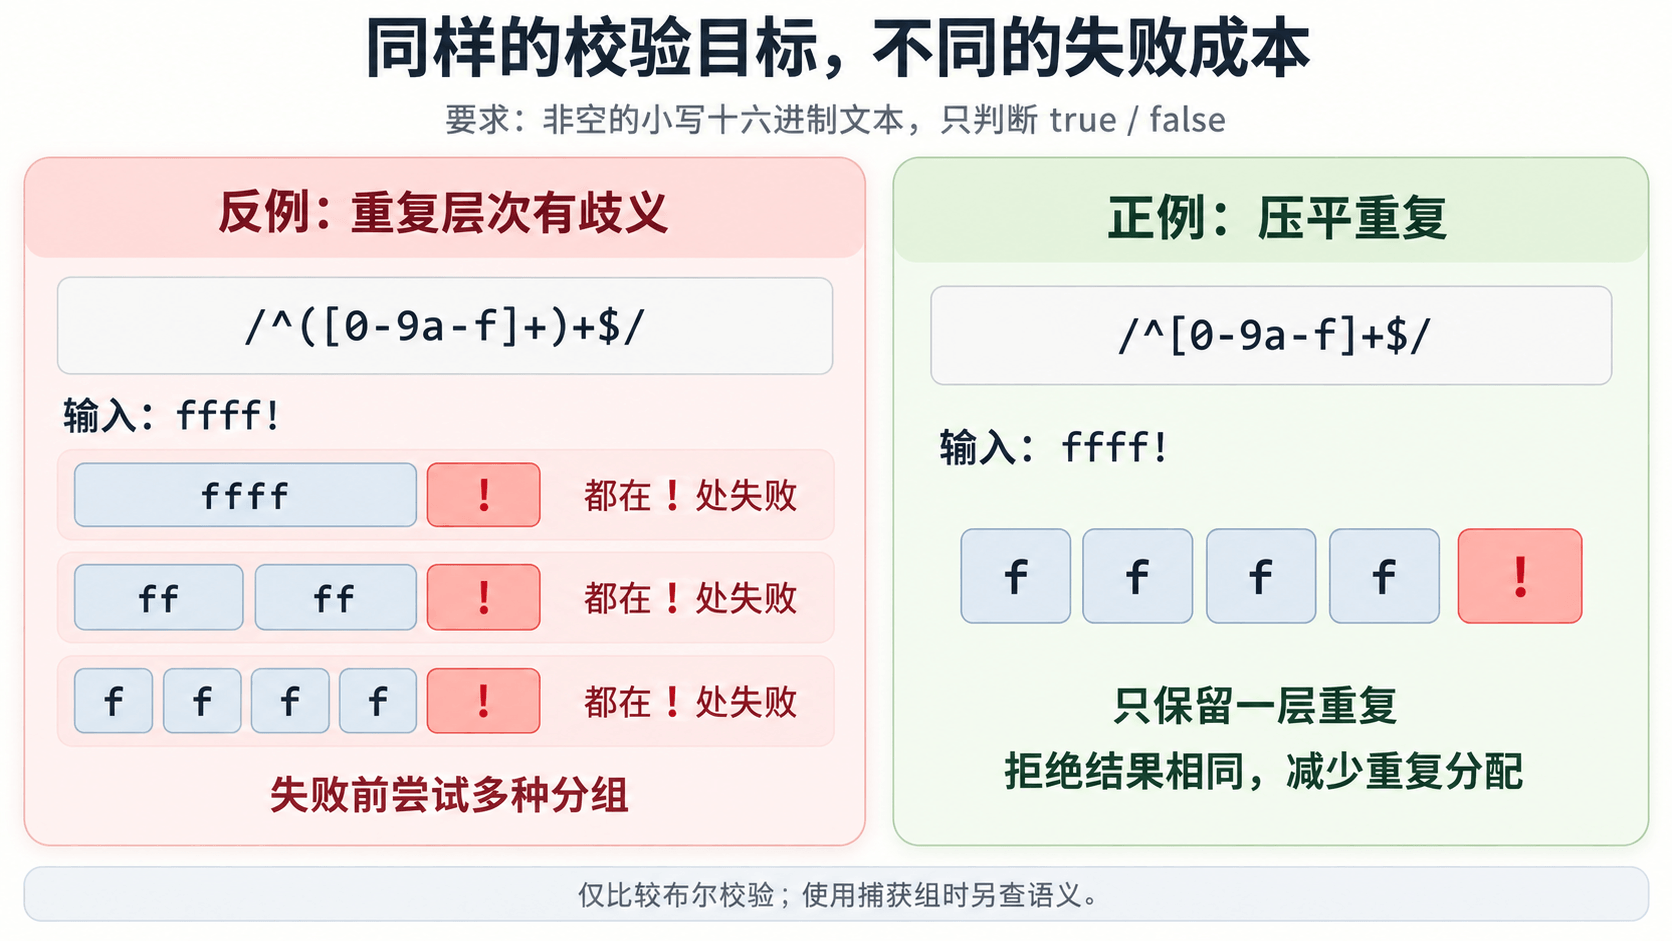
这里的「正例」限定在上述布尔校验需求。若代码还读取捕获组,删除括号会改变返回结果,需要另做语义回归。为了把字符分配过程看清楚,下面把十六进制字符类缩成单个 a,保留出问题的重复结构:
// 反例的机制简化:这里保留了有歧义的 (a+)+
/^(a+)+$/.test('aaaa!');
^ 和 $ 要求匹配输入的起止边界,内部 a+ 匹配一个或多个 a,外层 + 又允许这个分组重复。这个例子不带 m;添加 m 后,起止边界也可以是行的边界,校验语义会随之变化。
回溯 是引擎在后续匹配失败时,退回先前的选择点,尝试另一种分支或字符分配方式。例如一个贪婪量词先吃掉尽可能多的字符,后面的条件不成立时,再逐步把字符让出来。
对 aaaa!,内部 a+ 最初可以吃掉四个 a,随后 $ 在 ! 前失败。引擎于是尝试把这四个字符重新分给多次分组:
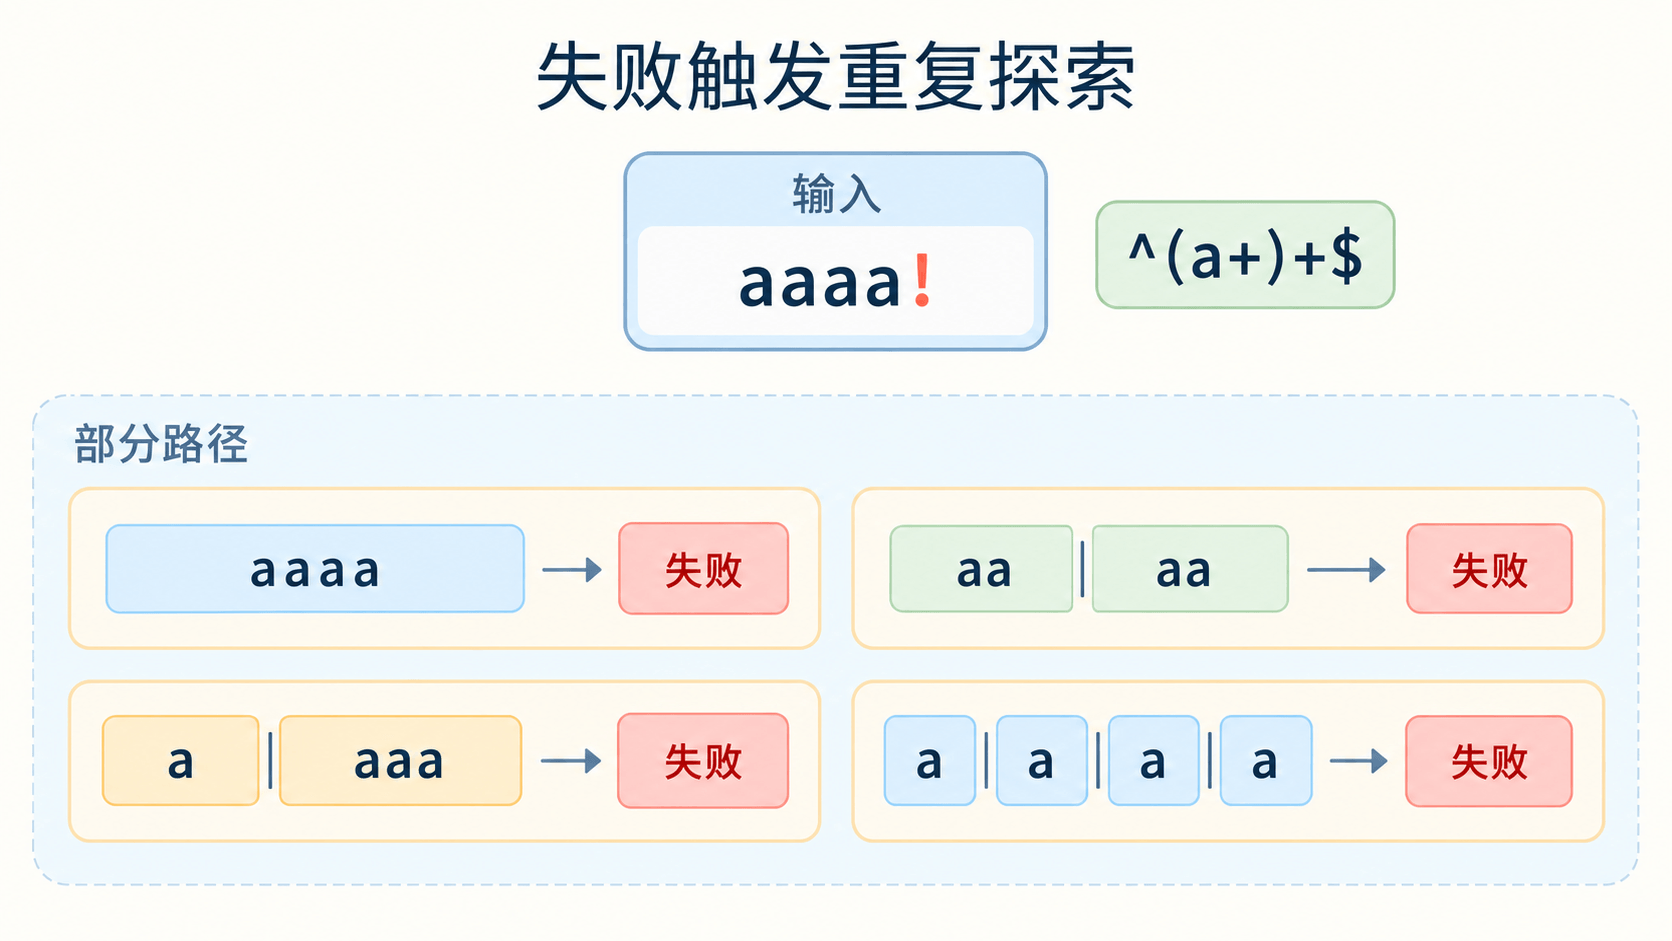
| 分成几组 | 部分分配方式 |
|---|---|
| 一组 | aaaa |
| 两组 | a / aaa、aa / aa、aaa / a |
| 三组 | a / a / aa、a / aa / a、aa / a / a |
| 四组 | a / a / a / a |
n 个连续 a 有 n - 1 个间隙,每个间隙都可以切开或不切开,非空分组的划分数量就是 2^(n-1)。这些路径最终都无法消除末尾的 !,却可能在失败之前被反复探索。
这是朴素回溯模型的解释,具体引擎可能优化或跳过部分路径。它说明的是问题为什么会增长,不能据此推算某台机器上必然需要几毫秒。CodeQL 的 ReDoS 文档也把重复部分的匹配歧义列为重要成因。
如果输入是 aaaa,第一条路径就可能成功。只测合法输入,往往看不出最坏情况。排查时需要考虑较长的重复内容,以及迫使整个匹配失败的后缀。
贪婪匹配怎样退回选择点
量词的「贪婪」说明它优先尝试消费更多字符,并不意味着消费之后不可撤回。对 aaaa!,可以把回溯过程理解成下面几步;这里只列关键动作,不穷举引擎的指令执行:
- 内部
a+吃掉aaaa,在!前停止。 - 外层分组无法继续消费
!,结尾断言也失败。 - 引擎退回内部量词,让它少消费一个
a,再尝试把剩下的a交给外层的下一次分组。 - 结尾仍然失败,就继续尝试其他分配,包括让前一个分组更短、增加更多分组。
- 找不到完整匹配路径后,才返回不匹配。
执行过程中使用的回溯栈保存了这些待尝试的选择点。程序里的 while、递归调用并不是唯一能产生大量重复工作的地方;正则表达式本身也描述了一套搜索过程。
把内部量词改成 a+?,引擎会先试短匹配,再逐渐加长。候选分配仍然存在,只是访问顺序变了。因此,贪婪和惰性的选择应服务于匹配语义,不能把惰性量词当作通用的 ReDoS 修复。
嵌套量词只是线索
(a+)+ 有两层量词,危险来自同一串字符能被不同层次反复分配。看到嵌套就禁止,会把合法表达式一起挡住。例如 ^(ab+)+$ 中,每个分组都从 a 开始,b+ 不能跨过下一个 a;它没有前面那种任意切分连续 a 的歧义。
分支也是如此。^(a|b)+$ 的两个分支分别消费不同字符,不能仅凭出现 | 和 + 就判成指数级风险。^(a|aa)+$ 则不同,连续的 a 可以由长度为一或二的分支组合出来,失败时可能探索大量组合。
这个分支例子没有嵌套量词。若把一串 a 分成每组长度一或二的片段,最后一组可以来自 a,也可以来自 aa,组合数量满足类似 Fibonacci 数列的递推,随长度呈指数增长。检查「有没有两层 +」因此会漏掉它。
因此,「量词嵌套」和「重复分支」适合用来找 review 入口,不能直接代替复杂度分析。惰性量词也只是改变尝试顺序,把 + 改成 +? 并不会自动消除歧义。
没有指数爆炸,也可能足够慢
超线性包括二次方、三次方等多项式增长,也包括指数增长,两者不能混为一谈。
即使起点固定,相邻量词也可能交换字符。例如 ^a+a+$ 中,第一段和第二段都能消费 a。遇到一长串 a 加 ! 时,引擎会在两段之间反复调整分界。这类问题不需要量词嵌套,也不需要分支,成本可能随输入长度呈多项式增长。
例如 /a+$/ 没有嵌套量词,但它可以从输入的不同位置开始搜索。对一长串 a 加末尾 !,从位置零开始失败后,还可能从位置一、位置二继续尝试,总工作量呈现类似下面的累加:
n + (n - 1) + (n - 2) + ... + 1 = n(n + 1) / 2这类风险来自反复移动匹配起点。^a+$ 限定从开头匹配,可以消除这个例子的多起点搜索;但给 ^(a+)+$ 再加锚点没有帮助,它本来就已经锚定了。m 下的 ^ 又允许从不同行的起点匹配,不能把「有 ^」统一视为单起点保证。no-super-linear-move 的规则说明专门解释了这一类复杂度。
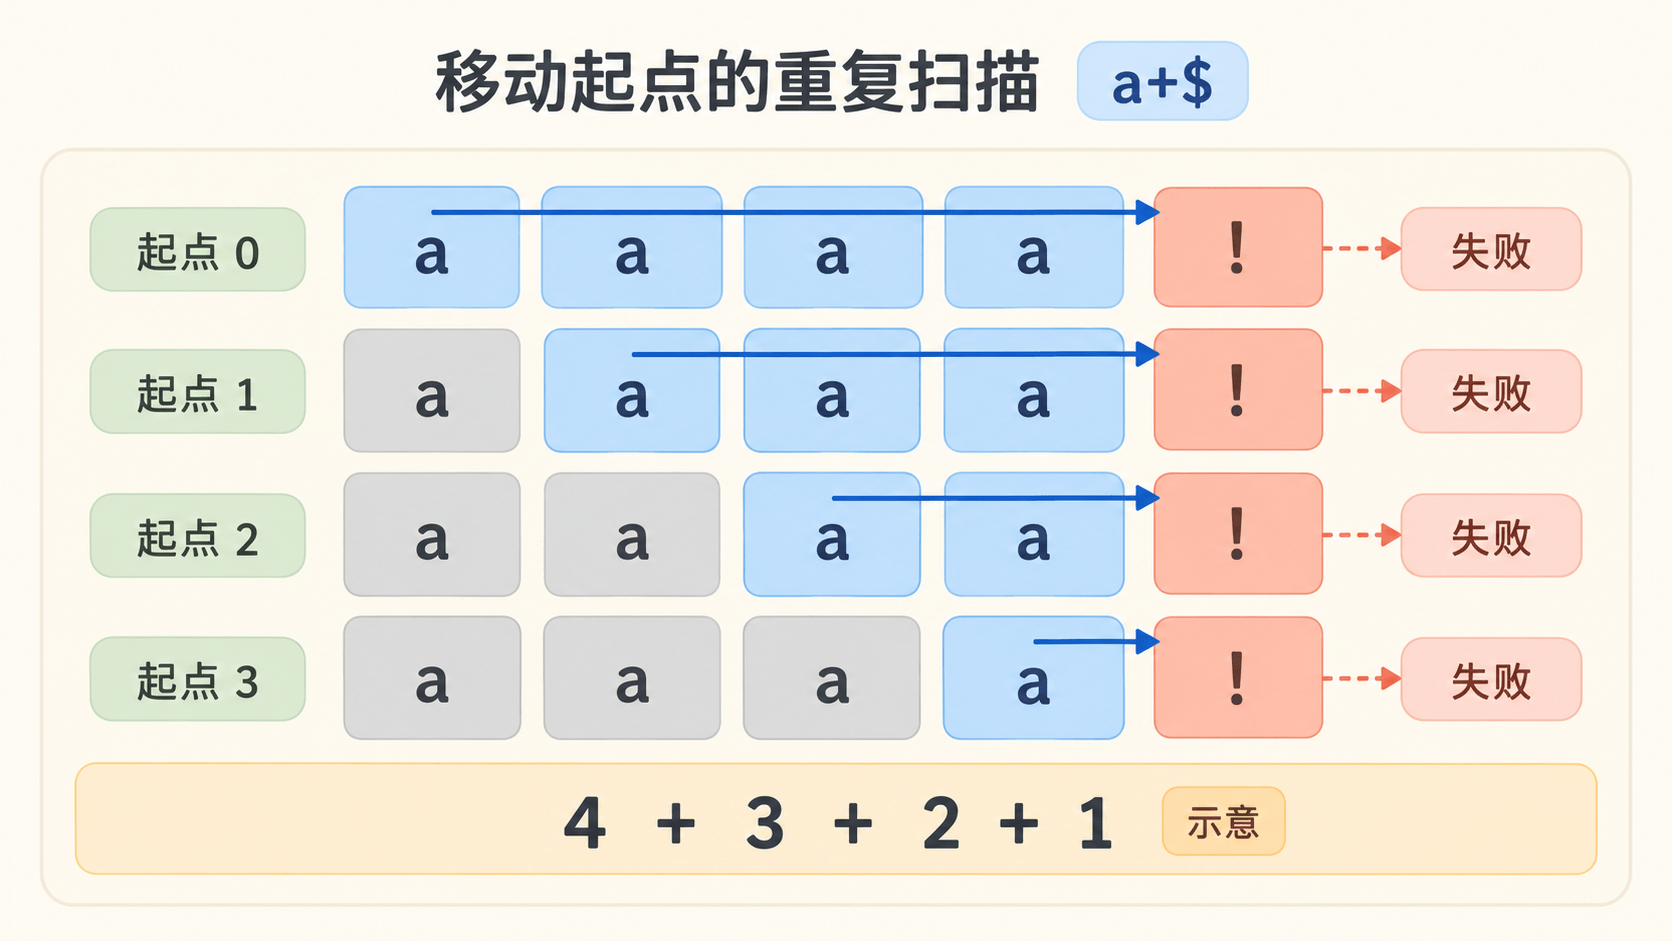
两类重复还可能叠加:每个起点的匹配已经很贵,搜索又从多个起点重新执行。review 时可以分别问:一个起点内有多少选择,以及整个调用会尝试多少起点。消除其中一层重复,不代表另一层也被处理了。
g 控制连续查找时的状态,不能提供线性复杂度保证。y 让一次匹配只从 lastIndex 指定的位置开始,但会改变 API 行为;如果外层算法自己移动 lastIndex 反复调用,仍然需要计算整个循环的成本。不能为了让一条规则不再报错,就直接给表达式增加标志。
写代码时,怎样判断一条正则是否合适
需要分别回答两个问题:它接受和拒绝的内容是否符合业务要求,以及它完成判断需要多少资源。有些正则运行很快,却放过了错误格式;有些正则结果正确,却可能在拒绝长输入时耗尽 CPU。ESLint 主要帮忙检查后一个问题中的部分危险结构,业务语义仍要由开发者明确。
先写接受与拒绝的例子
假设页面地址的短名称只允许非空的小写单词,单词之间用一个横线连接。例如 foo、foo-bar 可以通过,-foo、foo-、foo--bar、Foo 和空字符串必须拒绝。
/^[a-z-]+$/ 只限制「字符来自哪里」,没有限制「字符怎样排列」。它会接受 -foo 和 foo--bar,因此不满足这个需求;不能因为它短、没有嵌套量词,就把它当作正确校验。
// 每个后续单词都必须带一个前置横线
const slug = /^[a-z]+(?:-[a-z]+)*$/;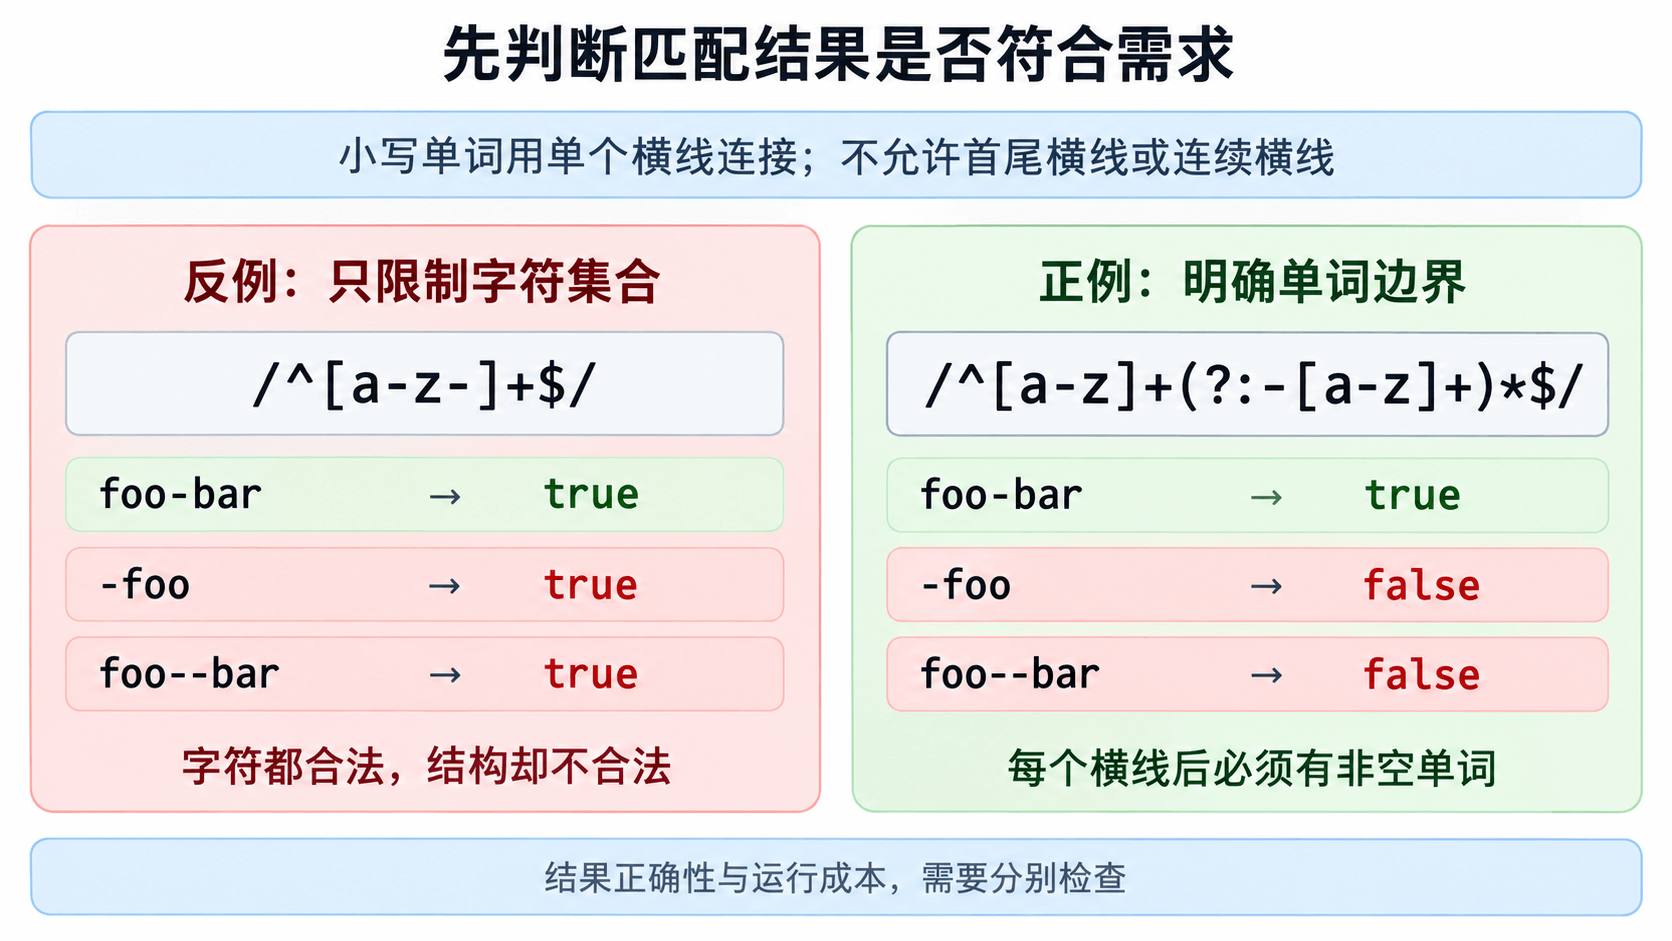
这里的 (?:...) 是非捕获分组,把括号里的内容作为整体重复,但不创建供调用方读取的捕获结果。这个模式把需求分成「第一个单词」和「零个或多个横线加单词」。[a-z]+ 不会消费横线,每个后续分组又必须先看到横线,所以首尾横线、连续横线都无法通过。
这里使用 .test(),不带 g、y、m;切换成搜索、逐行匹配或读取捕获时,需要重新检查调用语义。
长度也属于需求。假设业务规定最多 64 个字符,应先检查长度,再调用正则:
typeof value === 'string' &&
  value.length >= 1 &&
  value.length <= 64 &&
  slug.test(value);
64 是这项假设业务的上限,不是通用安全阈值。该字段只允许 ASCII,所以这里的 .length 与允许字符的数量一致;如果允许其他 Unicode 文本,就需要明确长度单位。
再找“同一段内容能否交给不同部分”
下面这个改动看起来只是让横线可选:
// 反例:-? 可以不消费字符,重复的字母段重新产生歧义
const ambiguousSlug = /^[a-z]+(?:-?[a-z]+)*$/;
它与前面的 slug 接受相同的文本,但连续字母可以被任意拆开:aaaa 可以全部交给开头的 [a-z]+,也可以拆成 aaa / a 或 a / a / aa,后续分组的 -? 每次都取空。加上失败后缀 !,引擎就有机会重新探索这些分配。可选分隔符消除了本来用于确定边界的条件。
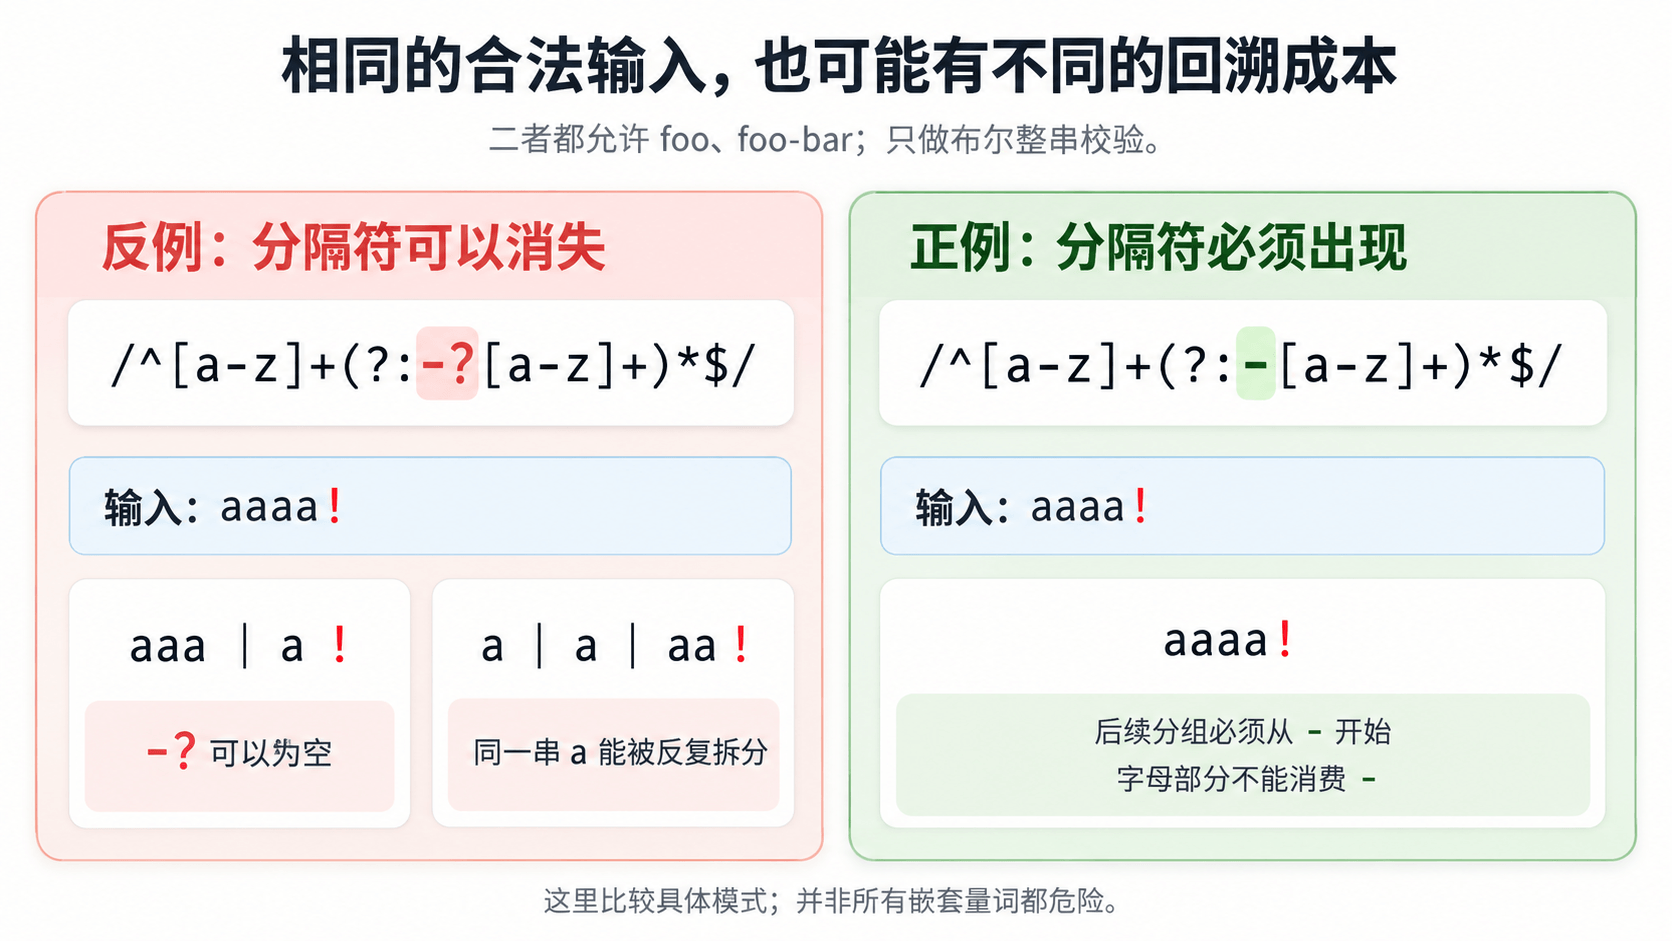
审查时,可以拿一段重复内容分别问每个量词或分支:「你能消费它吗?」如果多个部分都能消费,就继续找是什么条件迫使引擎回头,以及一次调用是否还会移动搜索起点。下面这些对照适合练习判断;成本描述针对常规回溯执行,实际引擎可能有优化:
| 写法 | 值得检查的输入 | 判断依据 |
|---|---|---|
/^(a+)+$/,反例 |
很多 a 加 ! |
内外量词重复分配同一串 a,失败时组合爆炸 |
/^a+$/,对应正例 |
很多 a 加 ! |
单一起点、单层重复,消除了上述分组歧义 |
/^(a|aa)+$/,反例 |
很多 a 加 ! |
同一串 a 可以由不同长度的分支组合,不能只检查量词嵌套 |
/^(a|b)+$/,对照正例 |
很多 a 加 ! |
两个分支消费不同字符,没有前一行的重叠组合 |
/a+$/,搜索场景的反例 |
很多 a 加 ! |
每个起点失败后,可能移动到下一个起点重试 |
/^(ab+)+$/,嵌套但边界明确的例子 |
很多 ab 加 ! |
每组从 a 开始,b+ 不能吞掉下一组的 a |
这些「正例」说明具体的歧义被消除,不代表可以处理无限长输入、无限次调用。/a+$/ 若本来用于搜索后缀,也不能直接用 /^a+$/ 替换,否则会改变业务含义。
把判断变成开发步骤
- 写清语义:整串校验还是子串搜索,允许哪些字符与结构,是否需要捕获或替换。先列合法、非法和边界输入。
- 检查结构:找能重复消费相同文本的量词或分支、可选分隔符、多个搜索起点;构造「重复前缀加失败条件」,而非只测合法短字符串。
- 运行静态检查:启用后文的两条
eslint-plugin-regexp规则。诊断需要处理,没有诊断仍要完成前两步,特别是动态构造的模式。 - 核对真实预算:在实际入口限制长度与次数;需要性能实验时,用可终止的独立进程逐步增加长度,观察拒绝输入的增长趋势。几次快速结果不能证明最坏复杂度。
例如上面的 slug 校验,回归至少包含 foo、foo-bar,以及空串、首尾横线、连续横线、大写、换行、64 与 65 个字符。对复杂模式再增加有外部超时的长失败样本。结果测试检查业务要求,增长测试观察成本,二者不能互相替代。
一段正则怎样影响整个服务
Node.js 的原生正则匹配是同步工作。一个请求在 JavaScript 线程上执行昂贵匹配时,同一事件循环上的其他回调也要等待。Node.js 的事件循环指南因此把易受攻击的正则列为阻塞风险,并建议限制输入、审查表达式或评估替代引擎。
浏览器里也可能出现输入卡顿或页面失去响应。管理员打开攻击者提交的内容时,也可能在自己的页面上触发昂贵匹配,因此提交数据的人和受影响的人未必相同。搜索高亮、日志查看器、Markdown 渲染、文本过滤,都值得检查实际的数据来源。
判断具体项目时,可以顺着调用链确认四件事:输入能否被外部控制、进入匹配前有多长、一次请求会匹配多少次、匹配在哪个线程或进程执行。固定短字符串和无限制请求体,即使使用同一条表达式,风险也不同。
Cloudflare:观察模式里的规则也会消耗 CPU
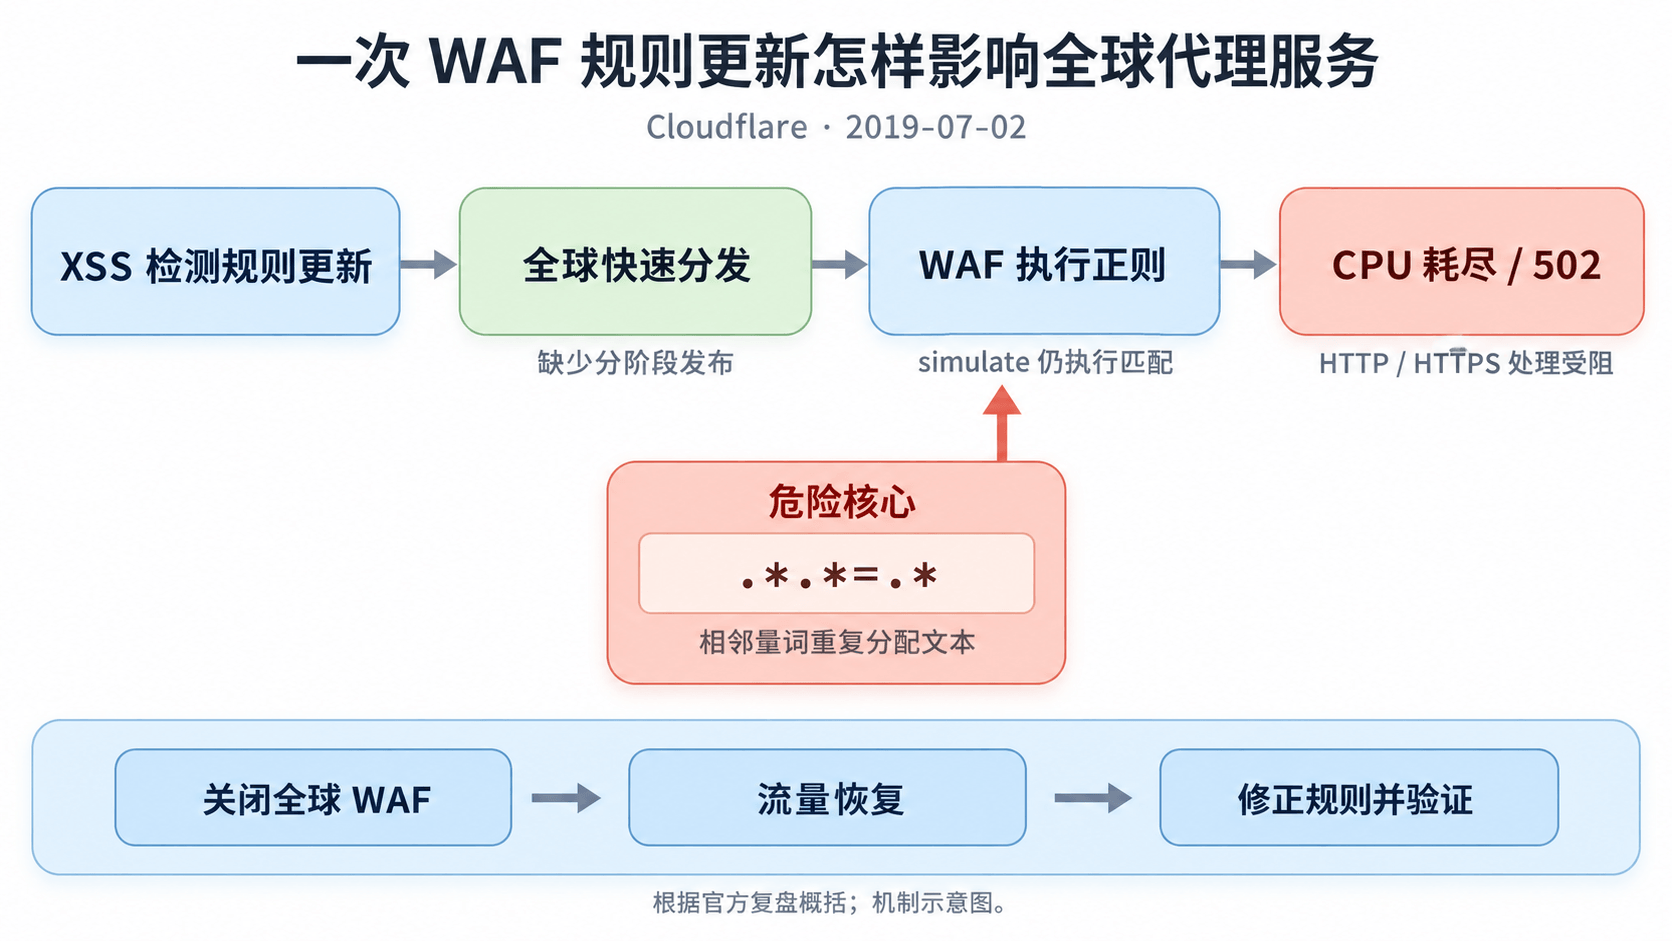
2019 年 7 月 2 日,Cloudflare 发布了一条用于检测 XSS(跨站脚本攻击)的 WAF 规则。WAF 是在请求到达网站前检查 HTTP 流量的 Web 应用防火墙。这次更新让处理 HTTP / HTTPS 的 CPU 被耗尽,访问者看到了大量 502 错误。当日故障说明确认,这是一次错误部署造成的中断,排查后排除了攻击。
按官方复盘概括:新规则处于
simulate模式,只观察匹配结果、不拦截请求,但正则仍会在真实流量上执行。规则通过 Quicksilver 在数秒内分发到全球,没有经过普通软件使用的分阶段发布;于是单条规则的高昂匹配成本,很快变成全球代理服务的 CPU 压力。当时的测试覆盖了应拦截与应放行的请求,却没有识别失控的 CPU 开销;一项防止正则过度消耗 CPU 的保护,还在数周前的重构中被意外移除了。详细复盘记录了这些条件怎样同时出现。
那条规则究竟哪里昂贵
完整的 XSS 规则很长,复盘指出的危险核心是下面这段。去掉不改变此处字符分配的非捕获分组后,可以用第二行观察机制;它是事故规则的局部简化,并非完整规则:
.*(?:.*=.*)
.*.*=.*
这里没有 (a+)+,但等号前的两个 .* 都能消费相同字符。假设输入是没有等号的 xxxx,从位置零开始,前两段可以依次尝试这些分配:
第一个 .*    第二个 .*    接下来要找的 =
xxxx         空           找不到
xxx          x            找不到
xxx          空           找不到
xx           xx           找不到
xx           x            找不到
……
只按朴素回溯模型数分配:固定起点、剩余长度为 n 时,前两个量词可能尝试的长度组合有 (n + 1)(n + 2) / 2 个,已经是二次增长。这个简化模式又没有锚定起点,搜索可以从后续位置重试,把不同剩余长度的二次成本继续累加,达到三次增长量级。这里是结构推演,实际 PCRE 的优化和完整规则中的上下文会影响执行过程,不能把这个公式当作事故的精确耗时。
「前面任意内容,后面再任意内容」在一条很长的规则中容易被忽略,单独抽出来才能看见两个 .* 之间没有明确边界。把它们改成惰性也没有消除这些分配。对于只判断「有没有等号」的独立需求,text.includes('=') 就足够;真实 XSS 规则还有前后约束,修复时必须回到完整检测语义,不能直接用这个局部替换整个防护规则。
为什么恢复也受到了影响
复盘中的关键时间点均为 UTC:13:42 开始部署,14:07 执行全球 WAF 关闭,14:09 流量与 CPU 恢复正常;Cloudflare 将这次中断记为 27 分钟。团队修正规则并在单个城市验证后,于 14:52 重新启用 WAF。
恢复还有一层依赖问题:团队自己的控制面板和部分内部服务也经过 Cloudflare,故障妨碍了登录与操作,需要使用不常演练的旁路。表达式本身的复杂度、全球发布范围和紧急关闭入口,最终影响了同一次故障的规模与恢复速度。
这份案例在工程上的启发是:观察模式仍需要资源预算,规则发布仍需要分阶段验证,紧急控制入口也需要能在服务故障时使用。详细复盘还保留了 CPU 图、发布流程和回溯动画,适合继续核对「正确性测试已经通过,为什么仍会出事」。
外部输入有三种不同含义
「用户输入进了正则」至少包含三类入口,应该分别处理:
| 外部输入承担什么角色 | 代码形态 | 主要关注点 |
|---|---|---|
| 被匹配的文本 | fixedPattern.test(input) |
固定模式的最坏复杂度、文本长度与调用次数 |
| 按字面量搜索的词 | 把关键词放进程序构造的模式 | 先转义关键词,防止它被解释成正则语法;外层模式仍要审查 |
| 用户编写的模式 | new RegExp(userPattern) |
语法范围、模式大小、编译成本、匹配预算与错误处理 |
第一类不涉及正则注入,却仍可能存在 ReDoS。第三类即使对模式字符串做了长度限制,用户仍可能提交很短但执行成本高的表达式。第二类则应保留用户搜索文本的字面含义,不能让输入里的 . 意外变成「任意字符」。
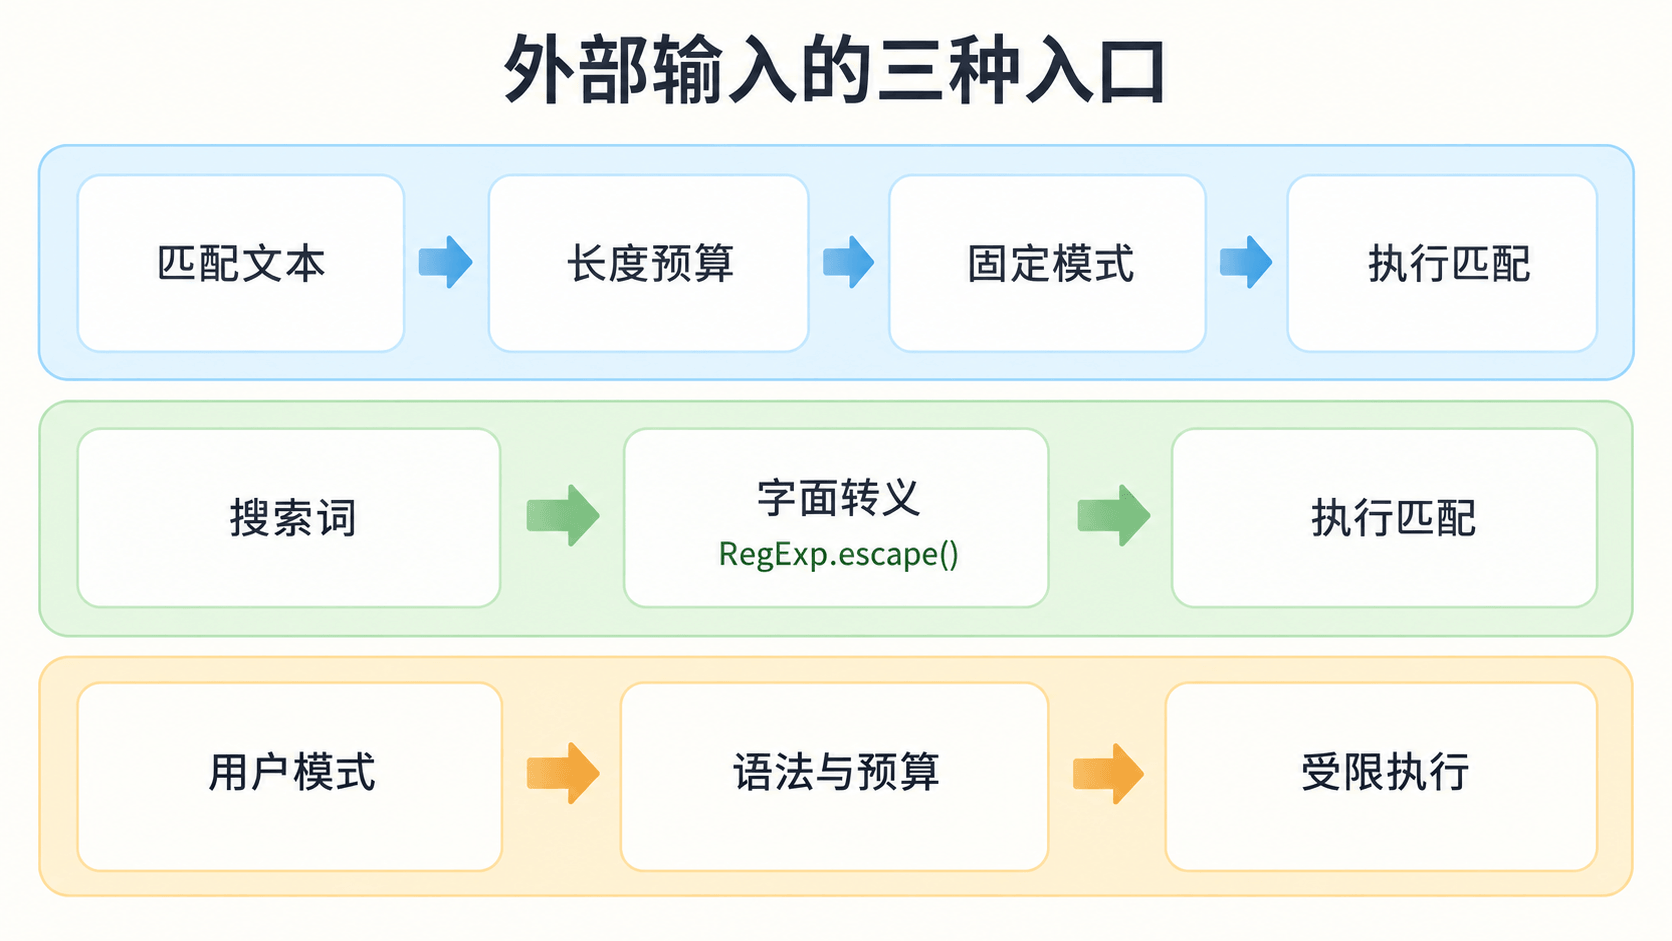
图里的 RegExp.escape() 是 JavaScript 提供的字面转义方法。它适合第二类入口;允许用户编写模式的功能则需要保留模式语法,并把执行交给有明确边界的方案。
非回溯引擎改变了什么
回溯引擎逐条尝试路径;一类非回溯算法则同时维护当前可能到达的状态,每读入一个字符就推进这些状态,并合并重复状态。多条路径如果已经到达同一输入位置和同一状态,就不用继续分别探索相同的未来。
有限自动机 用有限个状态描述已经匹配到哪里,以及读到下一个字符后可以转到哪里。这里关心的是合并等价状态,避免把每种历史分配方式都当成独立工作继续执行。
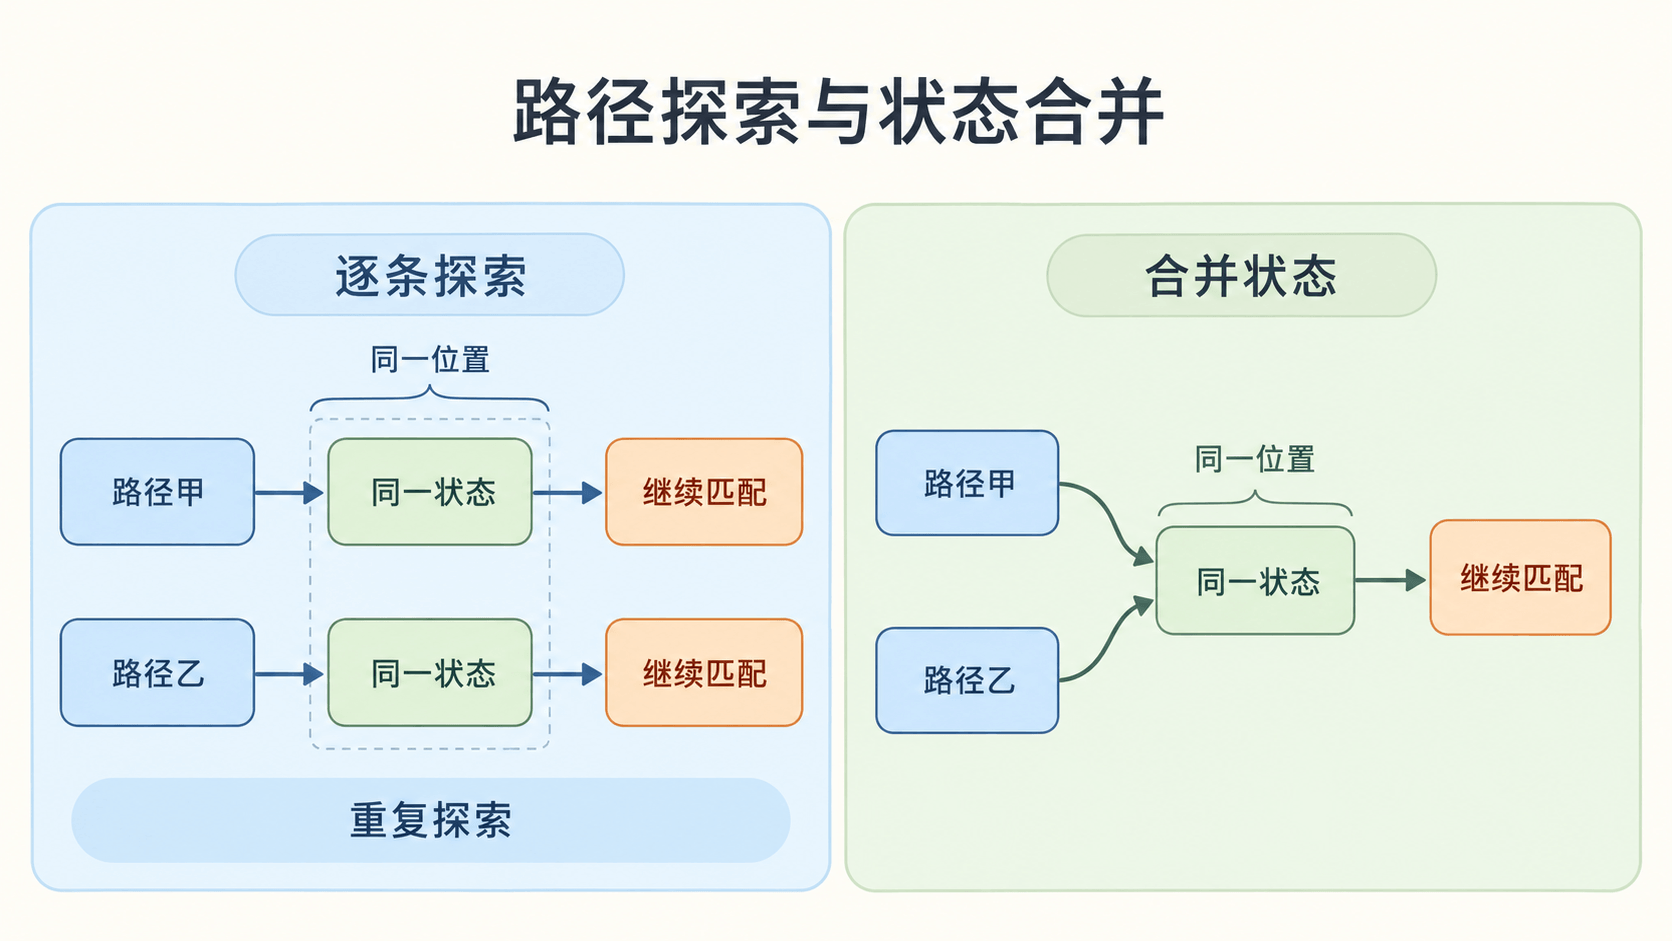
例如,两种不同的分组历史都已经消费到同一个字符位置,并来到同一个自动机状态。对于适用的自动机模型,后面的输入和可用转移相同,再分别搜索一遍并不会带来新的匹配可能。维护状态集合并去重,就能省掉这部分重复工作。
这里的「相同状态」要按引擎的完整语义判断。捕获组、匹配优先级和反向引用会增加处理要求,不能把任意两条到达同一个图形节点的 JavaScript 正则路径都直接合并。图示表达的是状态去重的思想,具体引擎还需要正确处理结果语义。
对固定模式,这类算法可以让单次搜索的耗时随输入长度线性增长。把模式大小也算进去,常见的表达是 O(m × n):m 与模式编译后的规模有关,n 是输入长度。引擎还可能使用 DFA、前缀搜索等优化,不能把所有实现概括成同一段算法。
常见选择包括:
| 引擎或库 | 官方承诺与使用边界 |
|---|---|
| Google RE2 | C++ 库,固定模式的匹配时间随输入长度线性增长,并对编译和执行内存设置预算;主线不支持反向引用和环视 |
Go regexp |
标准库明确承诺匹配时间与输入大小成线性关系;语法、返回结果按 Go API 使用 |
Rust regex |
常用单次搜索提供 O(m × n) 最坏情况边界;不支持环视和反向引用,遍历全部匹配有单独的复杂度说明 |
这些库分别服务于 C++、Go 和 Rust 生态。网页里的 JavaScript RegExp 由浏览器的 JavaScript 引擎执行;在 V8 中,常规匹配由 Irregexp 处理。Chrome 内部其他功能使用的 RE2,并不会自动替换网页里的正则实现。
非回溯引擎主要改善最坏情况保证,同时需要管理状态集合并取舍语法支持。RE2 的设计说明明确表示,它不以所有场景都比其他引擎更快为目标;回溯引擎在常见路径很快成功时也有优势。选择时应分别核对语义、最坏成本和实际负载,不能只用「更快」概括两者。
线性仍需要资源预算
固定模式下的线性增长,仍会受大输入、复杂模式、频繁编译和调用次数影响。允许用户同时提交大模式和大文本时,m、n 都可能增大;把匹配放进循环,成本还要乘上调用次数。
可以把一次请求的工作分成「编译模式」和「执行搜索」两部分。固定的可信模式通常适合编译后复用;用户不断提交不同模式时,编译成本也会成为负担。若缓存这些模式,缓存本身需要数量和内存上限,避免把 CPU 问题转成无限增长的缓存。
Rust regex 的不可信输入说明尤其明确:find、captures 的单次搜索界限,不能直接推广到 find_iter、captures_iter 遍历所有匹配,后者最坏情况下可能达到 O(m × n²)。选引擎之后,仍要核对所用 API,而不只是库的首页介绍。
环视与反向引用要分别讨论
环视(lookaround) 检查当前位置前后是否满足条件,但不把那部分内容计入当前匹配。例如 (?<=foo)bar 要求 bar 前面是 foo。
反向引用(backreference) 要求后面再次出现前面捕获的具体文本,例如 (\w+)\s+\1。它依赖捕获到的内容,和只检查前后条件的环视不同。
RE2 主线目前不支持这两类语法。环视本身已有线性处理算法,论文 Linear Matching of JavaScript Regular Expressions讨论了相关方法,EPFL 的无捕获 lookbehind 实现说明则展示了如何扩展 RE2。研究实现、RE2 主线和各语言包装库的支持范围,需要分别核对。
JavaScript 的引擎与接入方式
在 JavaScript 项目里,可以继续使用原生 RegExp 并约束模式和输入,也可以在需要最坏情况保证的入口显式使用替代引擎。引擎开关、第三方库与语言标准 API 各有职责,接入时要让代码实际使用到对应能力。
V8 的实验引擎与 fallback
V8 提供一套实验性的非回溯引擎,两个入口需要分清:
--enable-experimental-regexp-engine允许非标准l标志,带l的模式直接走实验引擎;不支持的模式在构造时抛异常。--enable-experimental-regexp-engine-on-excessive-backtracks让符合条件的普通模式在回溯达到阈值后切换引擎。它不是给所有正则设置一个统一超时。
2026-10-17 的本地核对使用 Node.js 26.12.0、V8 14.6.202.34-node.39。node --v8-options 的相关默认值节选如下:
--enable-experimental-regexp-engine
  default: --no-enable-experimental-regexp-engine
--enable-experimental-regexp-engine-on-excessive-backtracks
  default: --no-enable-experimental-regexp-engine-on-excessive-backtracks
--regexp-backtracks-before-fallback
  default: --regexp-backtracks-before-fallback=50000
这证明该 Node.js 版本的默认行为,不能代表所有 Chrome、Node.js 和嵌入式 V8 版本。l 也没有成为可直接依赖的跨浏览器标准标志。
当前编译器的资格检查允许部分环视,具体取决于模式内容和实验开关。下面节选了影响这个判断的条件:
// src/regexp/experimental/experimental-compiler.cc:185-191,节选
// 此前还会拒绝 g / y 与环视的组合,这里只摘额外开关的分支。
if (!v8_flags.experimental_regexp_engine_capture_group_opt &&
    (node->type() == Lookaround::LOOKAHEAD || node->capture_count() > 0)) {
  result_ = false;
  return nullptr;
}
本地用短输入构造模式,结果与这些条件相符:
| 模式与标志 | 仅开启实验引擎 | 再开启 capture-group-opt |
|---|---|---|
a+,l |
可构造 | 可构造 |
(?<=a)b,l |
可构造 | 可构造 |
(?=a)a,l |
SyntaxError |
可构造 |
(?<=a)b,lg |
SyntaxError |
SyntaxError |
a+,lu |
SyntaxError |
SyntaxError |
(a)\1,l |
SyntaxError |
SyntaxError |
这里的 capture-group-opt 对应 --experimental-regexp-engine-capture-group-opt。实验引擎已能处理部分 lookbehind,额外开关又扩展了环视能力;但 g、y 与环视组合、Unicode 标志、反向引用等仍有约束。有限重复的展开规模也有限制,具体以目标版本源码和构造结果为准。
显式 l 和 fallback 的失败策略也不同。l 要求模式由实验引擎执行,无法处理时就拒绝构造;fallback 是普通正则执行过程中的优化入口,不符合条件的模式仍可能留在原来的引擎里。应用若需要「每个外部模式都有可预测的执行边界」,不能只靠开启 fallback 来满足这项要求。
原生绑定、Wasm 与纯 JavaScript 库
| 方案 | 适用环境与迁移成本 |
|---|---|
node-re2 |
Node.js 原生绑定,提供接近 RegExp 的接口;需要处理原生二进制安装、平台和 Unicode 语义差异 |
re2-wasm |
RE2 的 WebAssembly 包装,可以用于浏览器;需要检查 Wasm 加载、打包和部署策略,文档要求 Unicode 模式 |
| RE2JS | 纯 JavaScript 实现,可用于 Node.js 和浏览器;API 与原生 RegExp 不完全相同,需要明确选择搜索或整串校验 |
RE2JS 2.8.6提供 RE2JS.LOOKBEHINDS,显式开启后可以使用无捕获 lookbehind。对安装包的短输入验证得到:
// RE2JS 2.8.6:显式开启无捕获 lookbehind
import { RE2JS } from 're2js';

RE2JS.compile('(?<=foo)bar', RE2JS.LOOKBEHINDS)
.matcher('foobar').find(); // true在相同开关下,(?<=(foo))bar 和 (?=foo)foo 都在编译时抛出 RE2JSSyntaxException。该版本文档还说明,lookbehind 会绕开部分更快的执行路径,因此默认关闭。它扩展了 RE2JS 的能力,不能被推广成 RE2、Go 或 Rust 都支持相同语法。
迁移时至少检查捕获结果、Unicode 字符、索引、替换语义和失败处理。RE2JS 的 matches() 用于整串匹配,find() 用于搜索;把原生 .test() 机械换成 .matches() 可能改变行为。不支持的语法也应该明确拒绝,不能悄悄回退到原生正则,让安全边界在失败路径上消失。
以模式 a、输入 ba 为例,原生 .test() 返回 true,RE2JS matcher 的 .find() 也返回 true,但 .matches() 返回 false。后者要求整个输入符合模式,所以选择方法时要先确认业务是在搜索,还是在校验整段内容。
引擎迁移可以按下面这些维度准备回归:
| 维度 | 应检查的实际行为 |
|---|---|
| 匹配范围 | 查找子串、从指定位置匹配,还是要求整串匹配 |
| 字符语义 | emoji、非 ASCII 字母、换行、大小写折叠是否符合预期 |
| 捕获与索引 | 未参与的捕获组、命名分组、返回索引的单位与结构 |
| 状态与重复调用 | 同一个对象连续执行时,搜索位置是否会改变 |
| 替换 | $1、命名捕获替换和回调参数是否保持预期 |
| 错误 | 不支持的语法、编译失败与资源耗尽如何返回给调用方 |
固定的小型业务校验通常可以先改写表达式并限制输入;允许外部编写模式的搜索器、过滤器和规则系统,更值得优先评估线性引擎。原生绑定要纳入安装与部署验证,Wasm 要验证加载路径和运行环境,纯 JavaScript 库也要测实际负载,不能只用实现语言判断性能。
用 RegExp.escape() 保留关键词的字面含义
用户本来只想搜索字面文本时,可以先用 includes()、startsWith() 等字符串操作。必须嵌入正则时,使用标准的 RegExp.escape() 转义文本。
RegExp.escape() 是标准 API,规范定义明确了各类字符的转义方式,Chrome 136 的发布说明也列出了支持。目标浏览器和 WebView 仍要核对兼容性,必要时使用经过验证的 polyfill。
// 用户输入按字面量参与搜索,外层模式仍由程序决定
const keywordPattern = new RegExp(RegExp.escape(keyword), 'u');
例如输入 a+b,直接构造 /a+b/ 会把 + 解释成量词,匹配的是一个或多个 a 后接 b。RegExp.escape('a+b') 在本地返回 \x61\+b,构造出的模式才会搜索字面文本 a+b。
开头的 a 被写成 \x61 也有用途:转义方法需要考虑字符串被拼到其他模式片段后,首字符是否会与前面的转义序列产生歧义。因此不建议用一个只给 .*+? 加反斜杠的简易函数代替它。方法说明列出了首字符、标点、空白和特殊 Unicode 字符的处理。
它解决的是正则注入:避免 keyword 里的 +、( 等字符变成模式语法。它不会修复外层模式已经存在的回溯歧义,也不适合用于「允许用户编写正则」的功能;后者需要限制语法、模式规模和执行预算。
匹配结果与资源错误
PHP 的 PCRE 配置包含 pcre.backtrack_limit。preg_match()用 1 表示匹配、0 表示不匹配、false 表示失败,调用者应使用严格比较,并通过 preg_last_error() 或 preg_last_error_msg() 检查错误。达到资源限制后尽快返回,不等于正确完成了匹配。
处理返回值时,应先区分错误,再决定业务结果。下面是一个结果处理片段:
// preg_match 的资源错误与正常不匹配分别处理
$result = preg_match($pattern, $subject);
if ($result === false) {
    throw new RuntimeException(preg_last_error_msg());
}
$matched = ($result === 1);
WebKit 的正则实现也包含内部工作量限制。在 2026-10-17 核对的主分支 Yarr.h中,限制值为:
// Source/JavaScriptCore/yarr/Yarr.h:51
static constexpr unsigned matchLimit = 100'000'000;
它限制的是内部匹配调用次数,不是毫秒数。这个主分支数字也不能直接当成每个已发布 Safari 版本的行为,本次没有运行 Safari 做对照。对应用而言,浏览器实现中的保护不适合作为跨平台的稳定超时契约。
如果匹配结果决定是否放行、是否过滤或是否提交,资源错误应该进入明确的错误分支。把超时或引擎失败都压成布尔值,会丢失判断依据;调用方需要知道本次校验完成了没有,才能决定重试、拒绝或换用其他处理流程。
用现成规则把风险提前到编辑阶段
工程里可以先启用 eslint-plugin-regexp 的两条规则:
| 规则 | 检查职责 |
|---|---|
regexp/no-super-linear-backtracking |
检查部分指数或多项式回溯;默认采用 report: "certain" |
regexp/no-super-linear-move |
检查移动匹配起点造成的超线性搜索;需要显式启用,不在 recommended 中 |
两条规则都在分析源码里的模式、标志与可识别的用法,不会执行输入来测耗时。阅读诊断时可以先分两层:固定一个起点,内部有没有大量重复选择;一次搜索,又会不会从多个起点重复执行。
回溯规则:同一段字符是否被反复分配
no-super-linear-backtracking 关注固定起点内的超线性回溯。它并不是看到两层量词就报错:需要分析重复部分能否消费相同字符,以及后续条件是否能迫使引擎回头尝试。
在 3.3.1 的实现中,这条规则使用 scslre 的分析结果,关闭 Move 类报告,处理下面两类诊断。self 和 trade 是对应的消息标识,编辑器里的英文提示能映射回这两种原因:
self表示一个量词通过外层循环再次遇到自己。/^(a+)+$/中,内部a+每次都能消费连续的a,外层+又允许重复这一过程。输入是长串a加!时,$提供失败条件,分组边界可以反复变化。提示中的「This quantifier can reach itself via the loop」指的就是这条重复路径;不是说 JavaScript 源码里出现了递归函数。trade表示两个量词可以交换它们消费的字符。/^a+a+$/中,两段a+都能消费a。遇到失败后缀时,第一段少拿一些,第二段就可以多拿一些,分界被反复调整。提示中的「can exchange characters」描述的正是这种交换;它不要求量词嵌套。
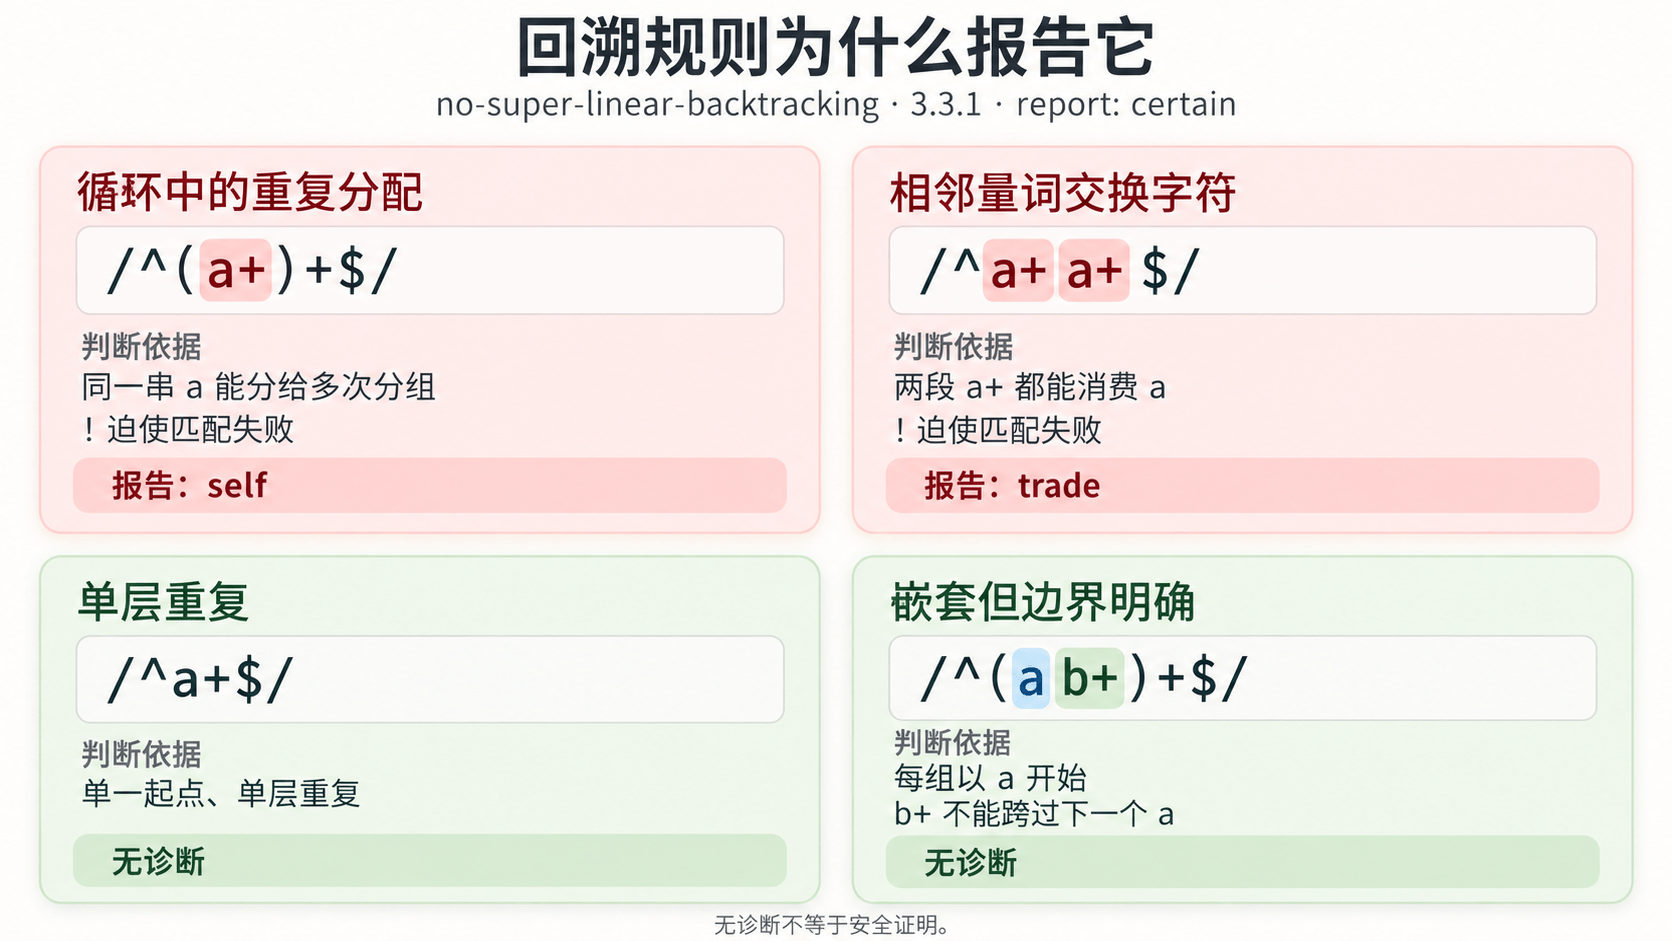
对照来看,/^a+$/ 只有一层重复,/^(ab+)+$/ 的每组又必须以 a 开始,内部 b+ 不能跨过下一组的 a。这几个具体模式里,没有前述可反复重分配的路径,因此本次检查没有报告。不能把它概括成「有锚点就能通过」或「嵌套量词一定不通过」。
前面的十六进制反例 ^([0-9a-f]+)+$ 命中 self;可选横线的 ^[a-z]+(?:-?[a-z]+)*$ 则同时报告了 self 与 trade。后者既能让字母段反复出现,也能在前后字母段之间交换字符,所以同一条正则可能出现多处诊断。
scslre的名称来自 Single-character super-linear RegExps。它主要寻找由单个字符反复重复形成的攻击文本,并不是完整的复杂度判定器。项目说明明确列出了漏检与误报边界。因此,即使输入能用重复的a构造,也不代表所有产生这种输入的歧义结构都会被它识别;^(a|aa)+$就是本次实际漏掉的例子。
移动起点规则:同一段后缀是否被反复扫描
no-super-linear-move 关注搜索起点的移动。单次起点尝试只有线性成本,放到整个搜索中也可能变成二次成本。
例如 /a+$/ 在长串 a 加 ! 上,从位置零检查到末尾后失败,搜索还可以从位置一、位置二继续。剩余内容的长度依次减少,工作量类似 n + (n - 1) + … + 1。规则报告的是 a+ 这个会反复扫描长片段的量词,而不是简单禁止所有不带 ^ 的正则。/abc/ 虽然也可能尝试不同起点,每个起点的检查成本却受固定模式长度限制,不能仅凭移动起点就判为二次风险。
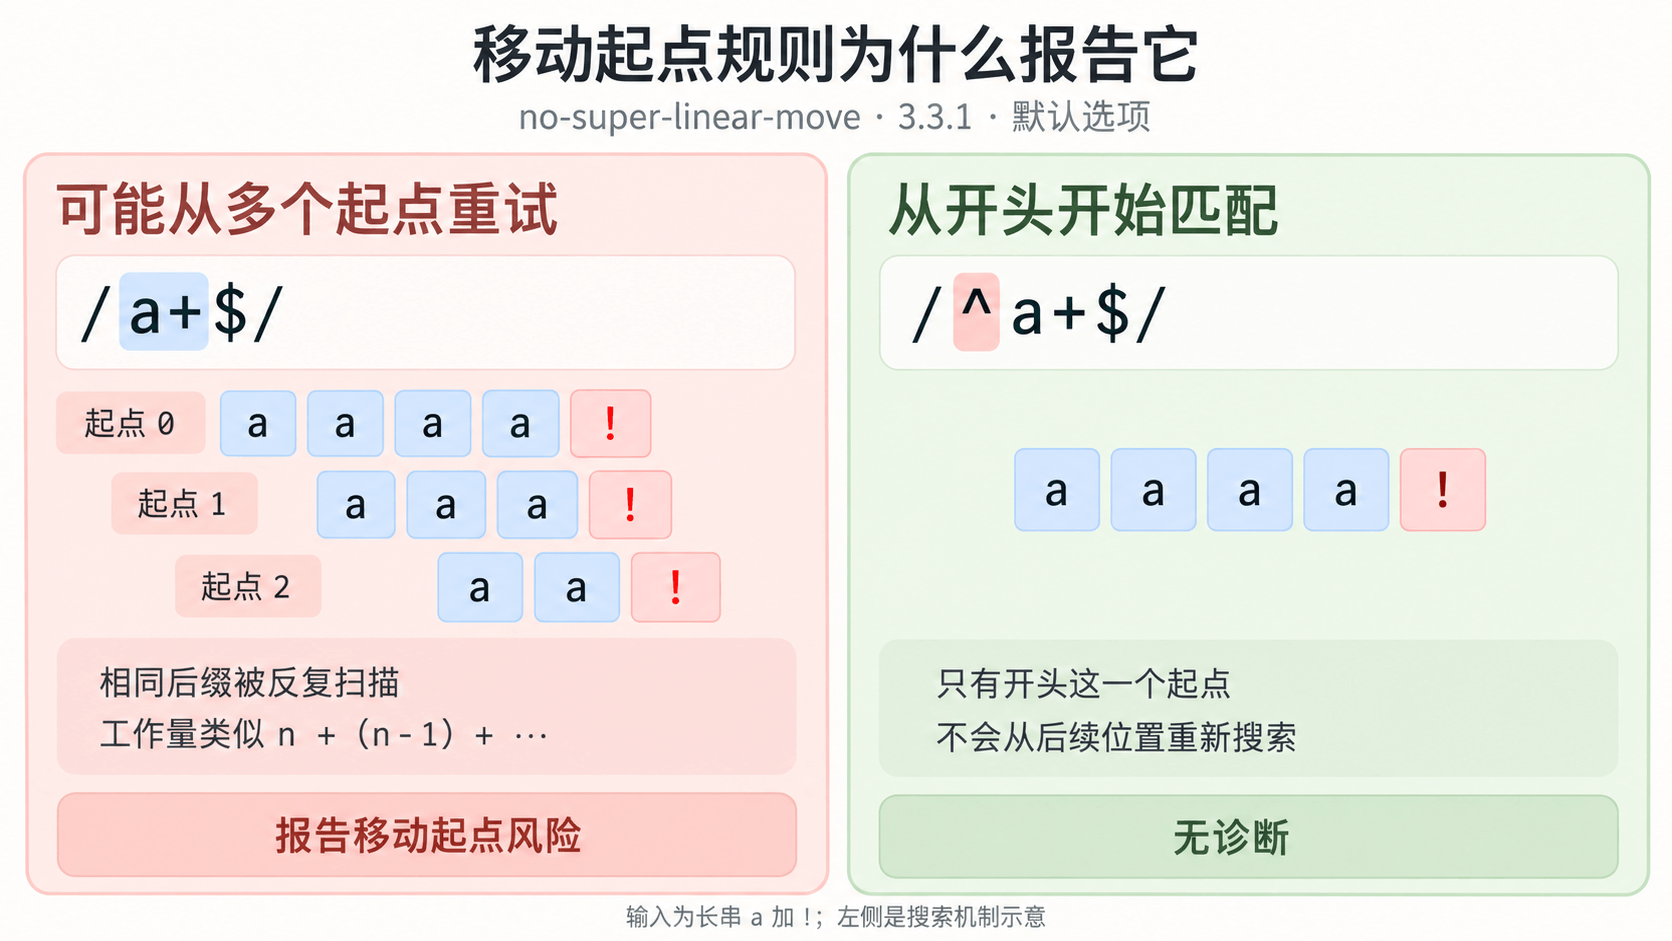
/^a+$/ 在不带 m 的整串校验中只能从开头尝试,因而没有这个例子的多起点成本;但 /^(a+)+$/ 即使起点固定,内部仍有回溯爆炸,应该交给前一条规则检查。两条规则的职责不能互相替代。
3.3.1 的移动起点规则源码既使用 scslre 的 Move 报告,也补充了对可到达的无上限量词的分析。这个检测仍有局限,不能根据它没报告某条修复后的表达式,就认定修复已经充分。
搜索起点也不等于 g 标志。没有 g 的一次 .test() 或 .replace(),仍可能为了找到第一个匹配而移动起点;g 又不会消除单次尝试内部的回溯。.replaceAll() 传入正则时也要执行匹配,只是额外要求正则带 g;传入普通字符串时才走字面查找。replaceAll 的参数与分派机制规定了这个区别。
默认选项为什么会改变报告
report: "certain" 主要控制是否要求分析找到拒绝后缀。例如 /(?:a+)+/ 本身没有结尾条件,找到一段 a 就能成功;不能只凭内外两层 + 就断言它会在当前用法里反复回溯。但把这个模式作为片段,再在后面拼接 $,失败条件就可能出现。
在本次单独运行回溯规则的对照里:
| 源码用法 | certain |
potential |
原因 |
|---|---|---|---|
/(?:a+)+/.test(input) |
无诊断 | 无诊断 | 被识别为完整使用,当前模式没有使歧义展开的拒绝后缀 |
export const part = /(?:a+)+/.source |
无诊断 | 报告 self |
被识别为片段,potential 允许假设拼接后存在拒绝后缀 |
potential 会增加片段审查线索,而不是把所有无诊断都变成错误。它仍受算法与源码可分析性的限制。上面的片段只被导出,没有在测试中拼接或执行;报告表达的是后续组合风险,需要回到实际使用处判断。
移动起点规则还有两个默认会跳过部分模式的选项。按已安装 3.3.1 的实现核对:
| 选项 | 默认值 | 含义 |
|---|---|---|
report |
"certain" |
与回溯规则一样,默认要求分析认为存在拒绝后缀 |
ignoreSticky |
true |
默认跳过带 y 的模式,它们单次匹配不会自行移动起点 |
ignorePartial |
true |
默认跳过被识别为拼接片段的模式,需检查最终组合 |
实际对照中,/a+$/y.test(input) 在默认选项下无诊断,ignoreSticky: false 后会报告;导出的 /a+$/.source 在默认选项下无诊断,ignorePartial: false 后会报告。这些变化来自检查范围扩大,不代表开启选项改变了正则的执行行为。如果外层算法会反复修改 lastIndex,或把片段拼成完整模式,应检查完整调用链;不能为了消除提示随意添加 y。
把检查接入项目
配套源码包使用 ESLint 10.12.0、eslint-plugin-regexp 3.3.1 和 Node.js 26.12.0 验证。这个插件版本要求 ESLint 至少 9.38.0;已有旧版 ESLint 项目应先核对兼容版本,不能直接照抄最新依赖。
复制 copy/ 后,先运行 pnpm install,再运行 pnpm check。接入已有项目时,合并配置和开发依赖即可,不要覆盖整个 package.json;TypeScript 和 Vue 项目继续保留自己的 parser 配置。
请接入 https://shengsheng.fun/files/regex-redos-linear-engines-eslint/kits/regex-redos-checks/。
先读 README.md、AGENT_PROMPT.md 和 FILES.json,再按 FILES.json 读取文件。
合并 copy/eslint.config.mjs 的两条规则及依赖,保留项目已有 parser 和配置。
运行配置自检,并人工检查动态模式、输入上限和调用链。实测能报告什么,又漏掉了什么
用上述两条规则、默认选项分析源码,得到以下结果。测试只让 ESLint 分析代码,没有执行危险匹配:
| 源码中的模式 | 实测诊断 | 如何理解结果 |
|---|---|---|
/^(a+)+$/ |
回溯规则:self |
内部 a+ 经外层循环反复分配字符,$ 可迫使失败 |
/^a+a+$/ |
回溯规则:trade |
两段 a+ 可交换字符,失败时反复调整分界 |
new RegExp('^(a+)+$') |
回溯规则:self |
常量字符串能还原为模式,检查依据与字面量一致 |
/^([0-9a-f]+)+$/ |
回溯规则:self |
十六进制字符可在多次分组之间重新分配 |
/^[a-z]+(?:-?[a-z]+)*$/ |
回溯规则:两处 trade、一处 self |
-? 可以为空,前后字母段能交换、重复消费字符 |
/^[a-z]+(?:-[a-z]+)*$/ |
无诊断 | 必需横线明确分段,字母部分不能吞掉横线 |
/^[a-z-]+$/ |
无诊断 | 没有上述重复分配,但会接受不符合需求的横线结构 |
/a+$/ |
移动起点规则 | 不同起点可重复扫描长串 a,直到末尾失败 |
/^a+$/ |
无诊断 | 在本例中,单层重复且匹配起点固定 |
/^(a|b)+$/ |
无诊断 | 两个分支消费不同字符,没有重叠组合 |
/^(ab+)+$/ |
无诊断 | 每组从 a 开始,b+ 不能跨过组间边界 |
/^(a|aa)+$/ |
无诊断,但有回溯风险 | 重叠分支可产生大量组合,当前检测方法漏掉了它 |
new RegExp(input) |
无诊断,运行时模式未知 | 无法从源码还原外部提供的实际模式 |
把这 13 个模式按诊断原因放在一起看:前两张图覆盖六个被报告的例子,后两张图覆盖七个无诊断的例子。其中,常量构造器一例展示了静态可确定的字符串同样能接受正则检查。
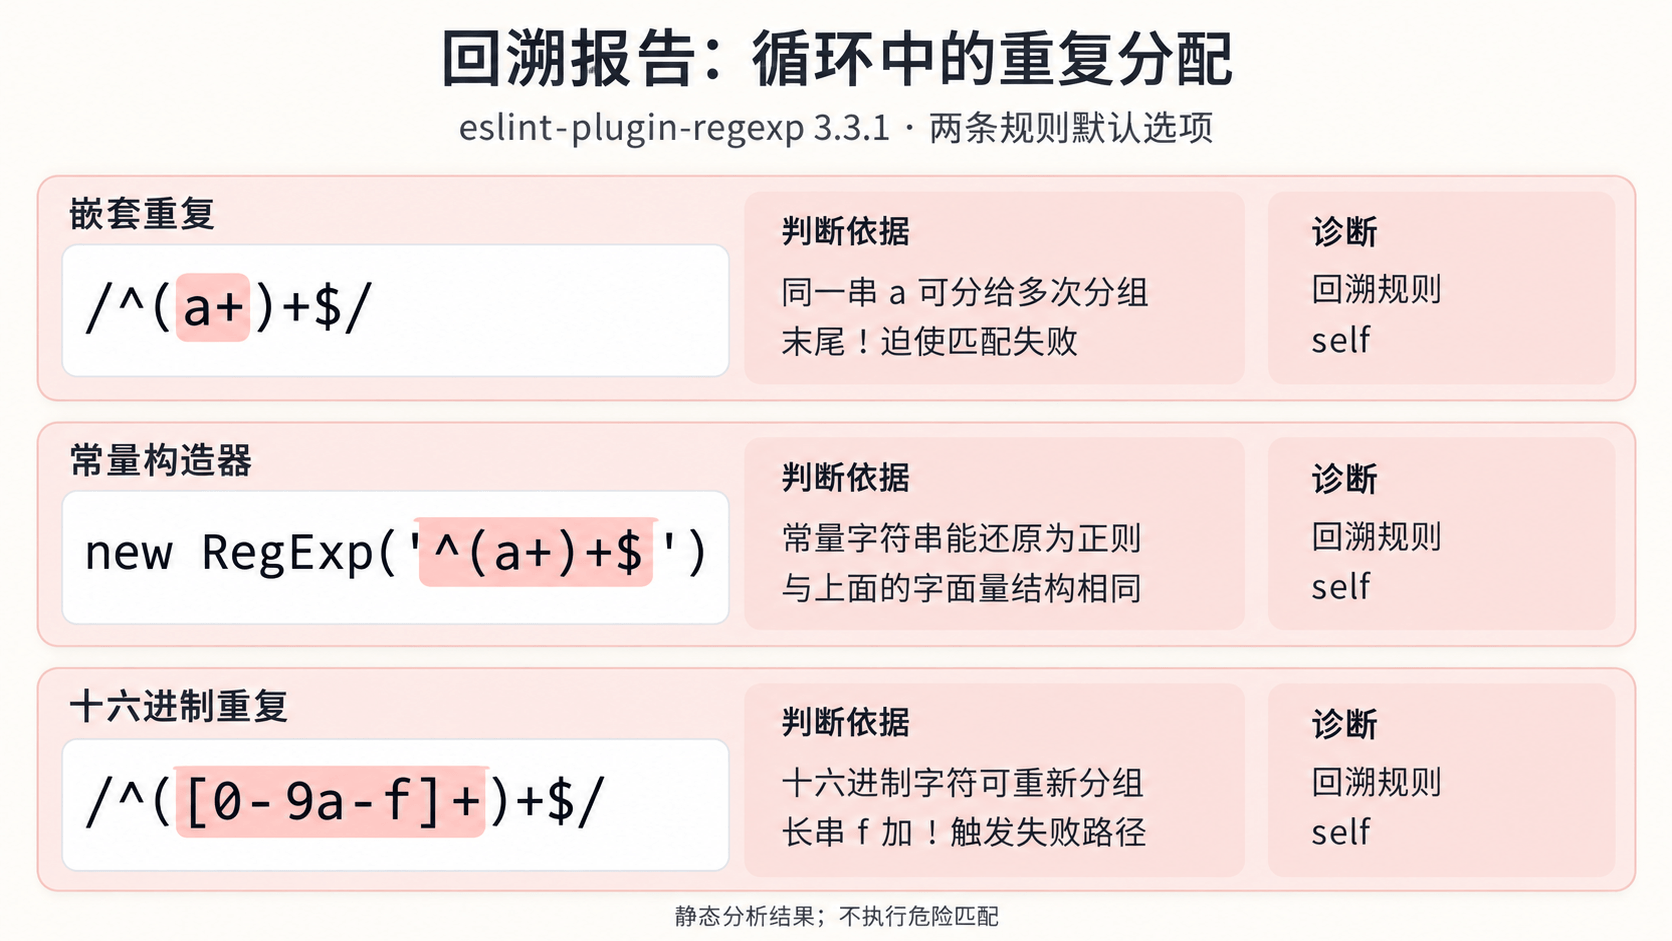
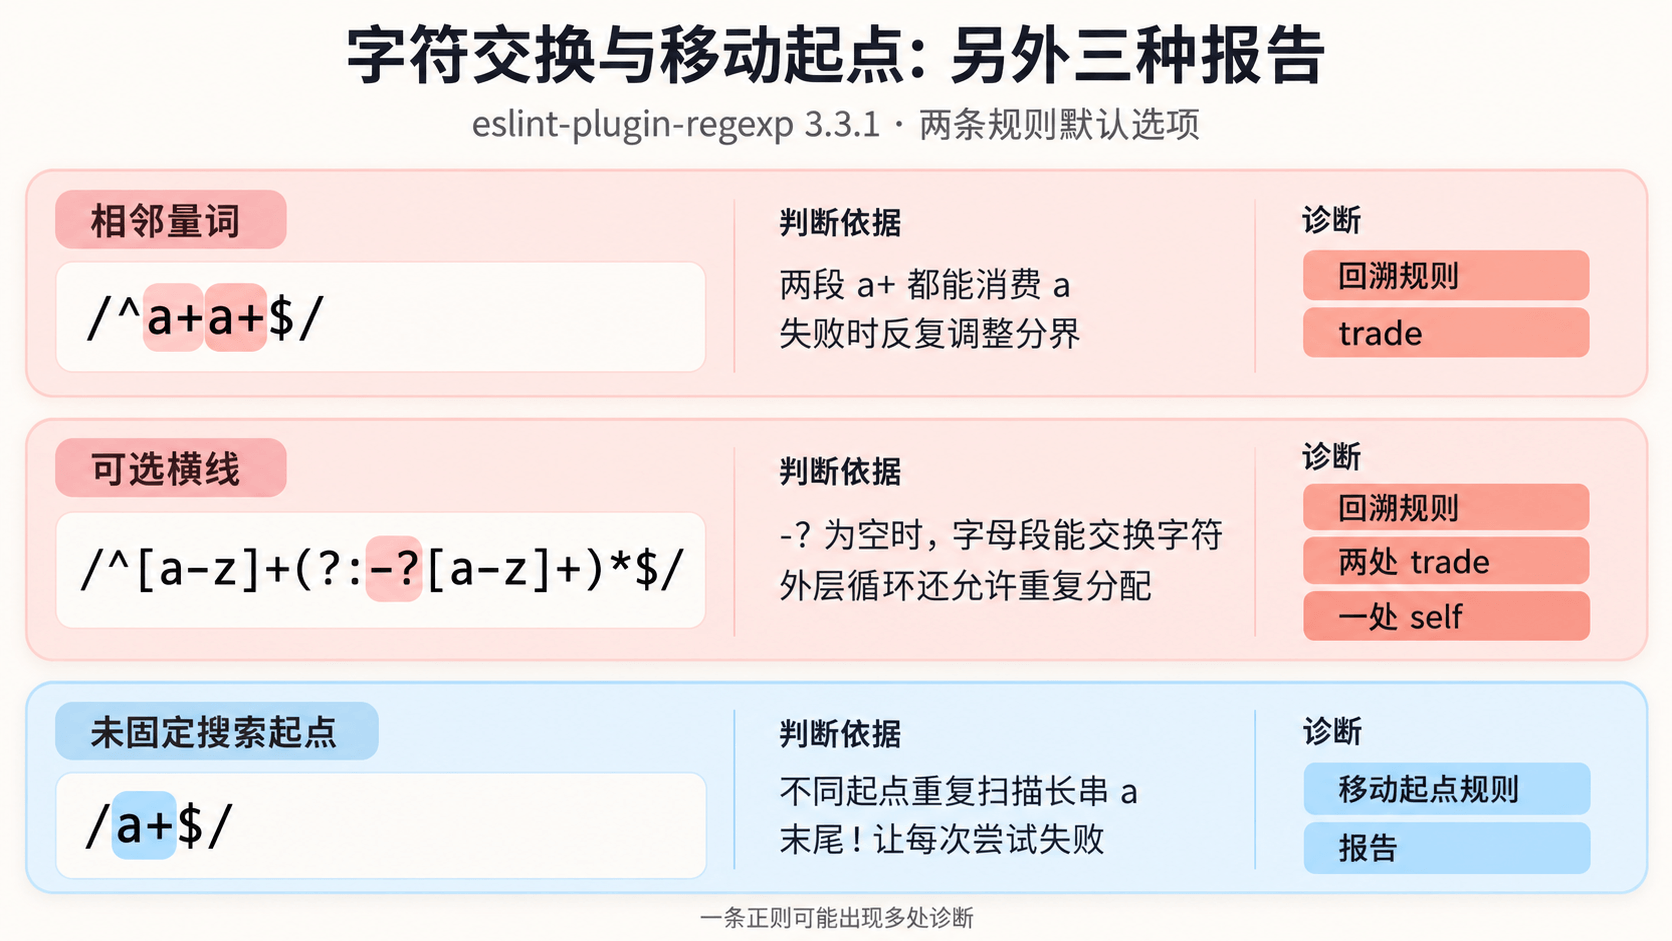
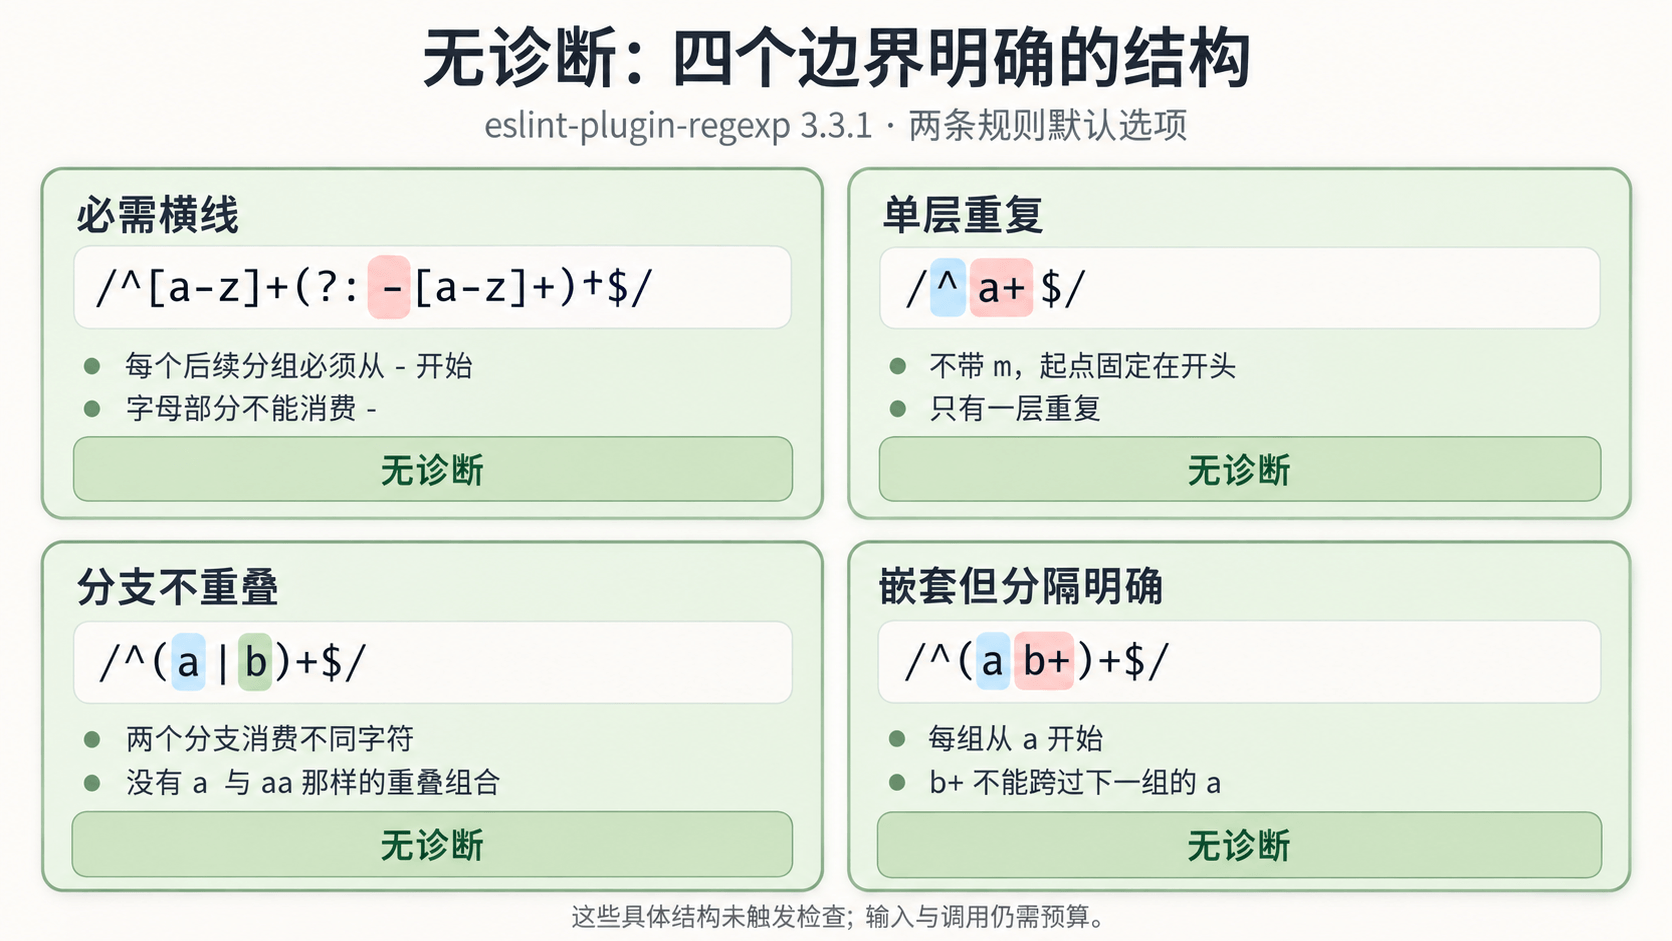
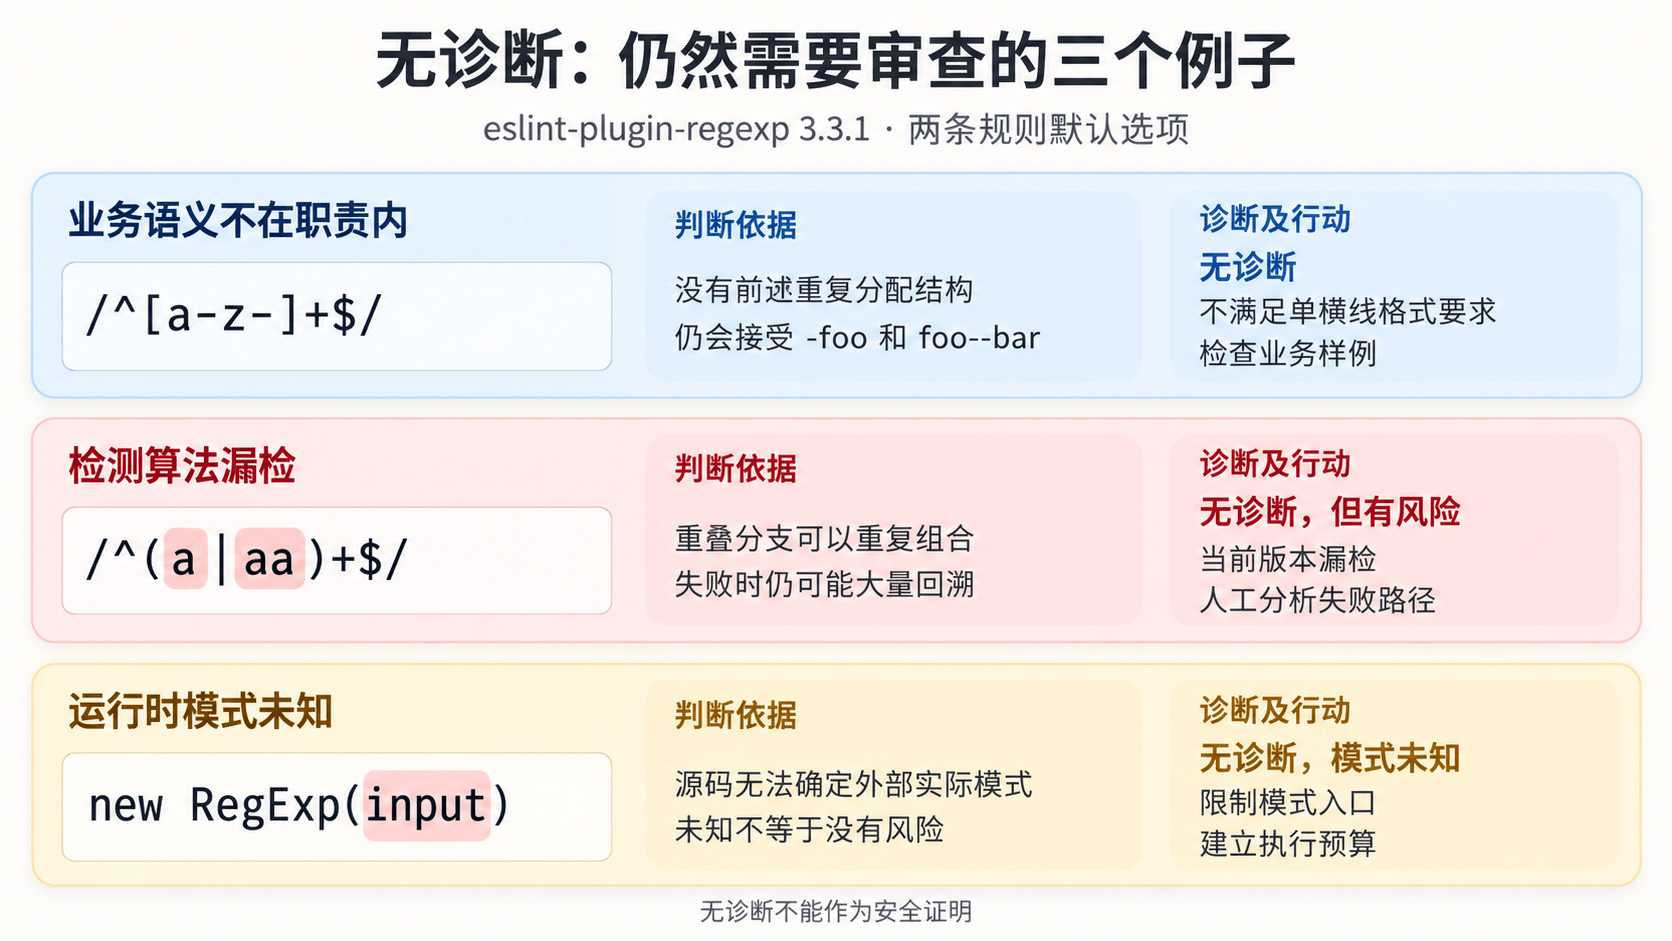
尤其要注意 ^(a|aa)+$:它只有一个外层量词,歧义来自内部 a 与 aa 两个分支的组合,不是图中典型的嵌套量词或相邻量词交换。这个具体结构没有被当前检查识别,不能据此反推它没有风险。额外启用 no-dupe-disjunctions 的对照中,它同样没有诊断,仍需要人工分析失败路径。
规则能够定位某些危险结构,却未必知道 HTTP 层有没有限制文本长度、这个模式是否被高频调用,以及攻击者能否到达调用入口。诊断适合触发修复或 review,实际风险还需要沿输入链路确认。
处理报告时,可以先找出会重复消费的字符,再确认是什么条件迫使匹配失败。随后判断能否减少重复分配、限定起点或改用字符串操作。规则提供自动修复时,也要检查捕获与匹配语义;不能只以「重新运行 ESLint 不报错」作为验收。
若业务确实有固定且足够小的输入上限,需要把上限来源、调用位置和验证依据放在代码附近。局部关闭规则应对应这个明确边界,并保留回归;缺少上下文的「这是安全的」注释无法帮助后续维护者判断输入约束是否还存在。
其他工具可以补哪一层
eslint-plugin-security 的 detect-unsafe-regex也是现成规则,它调用 safe-regex。不过 safe-regex 自己说明了误报和漏报,粗粒度结构启发式适合筛查,不适合作为安全证明。
需要追踪外部数据时,可以补充 CodeQL:js/redos检查低效模式,js/polynomial-redos关注不受控数据上的多项式风险,js/regex-injection追踪不可信数据进入动态正则。它们的职责与本地 ESLint 的快速反馈不同。
SonarJS 也提供相关检查,而且规则职责仍在调整。2026-10-16 主分支的变更记录包含将 S5852 收窄到指数回溯、增加 S8786 的记录。接入时应核对所安装分析器的版本与规则说明,不能把主分支变更直接当成所有 SonarQube 部署已经生效。
这些工具的反馈可以互相补充:编辑阶段快速指出可见的模式问题,CI 扫描追踪更完整的数据流,运行时执行预算处理静态分析无法确定的输入。结构启发式和静态扫描都有能力边界,不能单独承担生产执行的全部保护。
Lint 之外,给实际执行建立边界
默认处理方向是先简化表达式,再限制资源;需要接受复杂或用户自定义模式时,才选择适合的引擎和执行环境。
消除重复选择,保留原有业务语义
如果真实需求就是检查一串 a,^(a+)+$ 可以改成 ^a+$。如果真实需求是搜索固定文本,直接用字符串 API 通常更容易核对。带分隔符的结构可以让重复部分不能吞掉分隔符,复杂语法则考虑解析器。
前面的十六进制校验通过压平重复,减少字符在内外量词之间的分配;slug 校验通过必需的横线确定分段边界。这两种改法都先依赖明确的业务语法,再判断哪些选择可以消除。
修改时要验证接受集合、拒绝集合、捕获结果和替换结果。加锚点可能把搜索改成整串校验,删除捕获组会改变后续索引,收窄字符类可能拒绝此前允许的输入。性能修复需要这些语义回归,不能只看危险输入变快了。
长度限制放在昂贵匹配之前
按业务限制文本长度、模式长度、请求体大小、编译次数和每次请求的匹配次数。长度单位要清楚:JavaScript .length 是 UTF-16 代码单元,网络请求限制通常按字节计,两者不能直接互换。
预算可以分布在不同入口,但要检查中间是否绕过了限制:
| 入口 | 需要限制什么 | 常见遗漏 |
|---|---|---|
| HTTP 或消息接收 | 请求体、字段大小与接收频率 | 只限制整个请求体,没有限制单个待匹配字段 |
| 模式创建 | 模式长度、允许语法、编译次数 | 每条数据都重新编译同一个模式 |
| 匹配调用 | 文本长度、单次请求的调用次数 | 单条文本很短,但循环匹配了大量模式和记录 |
| 任务调度 | 并发、队列长度、执行时间与内存 | 超时后只返回错误,后台任务仍继续占用资源 |
对压缩、解码或拼接后的文本,还应在真正调用匹配前检查最终长度。入口处检查的是原始数据时,后续转换可能让长度发生变化。
上限来自真实业务和实测预算。指数问题可能在几十个重复字符时就明显变慢,因此「已经限制到几千字符」仍可能不够。限流和依赖漏洞扫描也有价值,尤其是路由、格式化、语法高亮等依赖内部使用的正则,未必出现在业务源码中。
同线程定时器不能打断同步匹配
下面这段教学反例不会给 .test() 设置可中断的超时:
// 教学反例:求值 Promise.resolve 的参数时,匹配已经同步执行
Promise.race([
  Promise.resolve(pattern.test(input)),
  new Promise((_, reject) => setTimeout(() => reject(new Error('超时')), 100)),
]);
把匹配包进 async 函数或 .then() 也不会自动换线程。需要强制停止时,浏览器可用专用 Web Worker,Node.js 可用 Worker 或子进程,由外部执行环境计时并终止任务。还要限制并发、队列和输入,否则昂贵任务仍可能耗尽工作线程或进程资源。
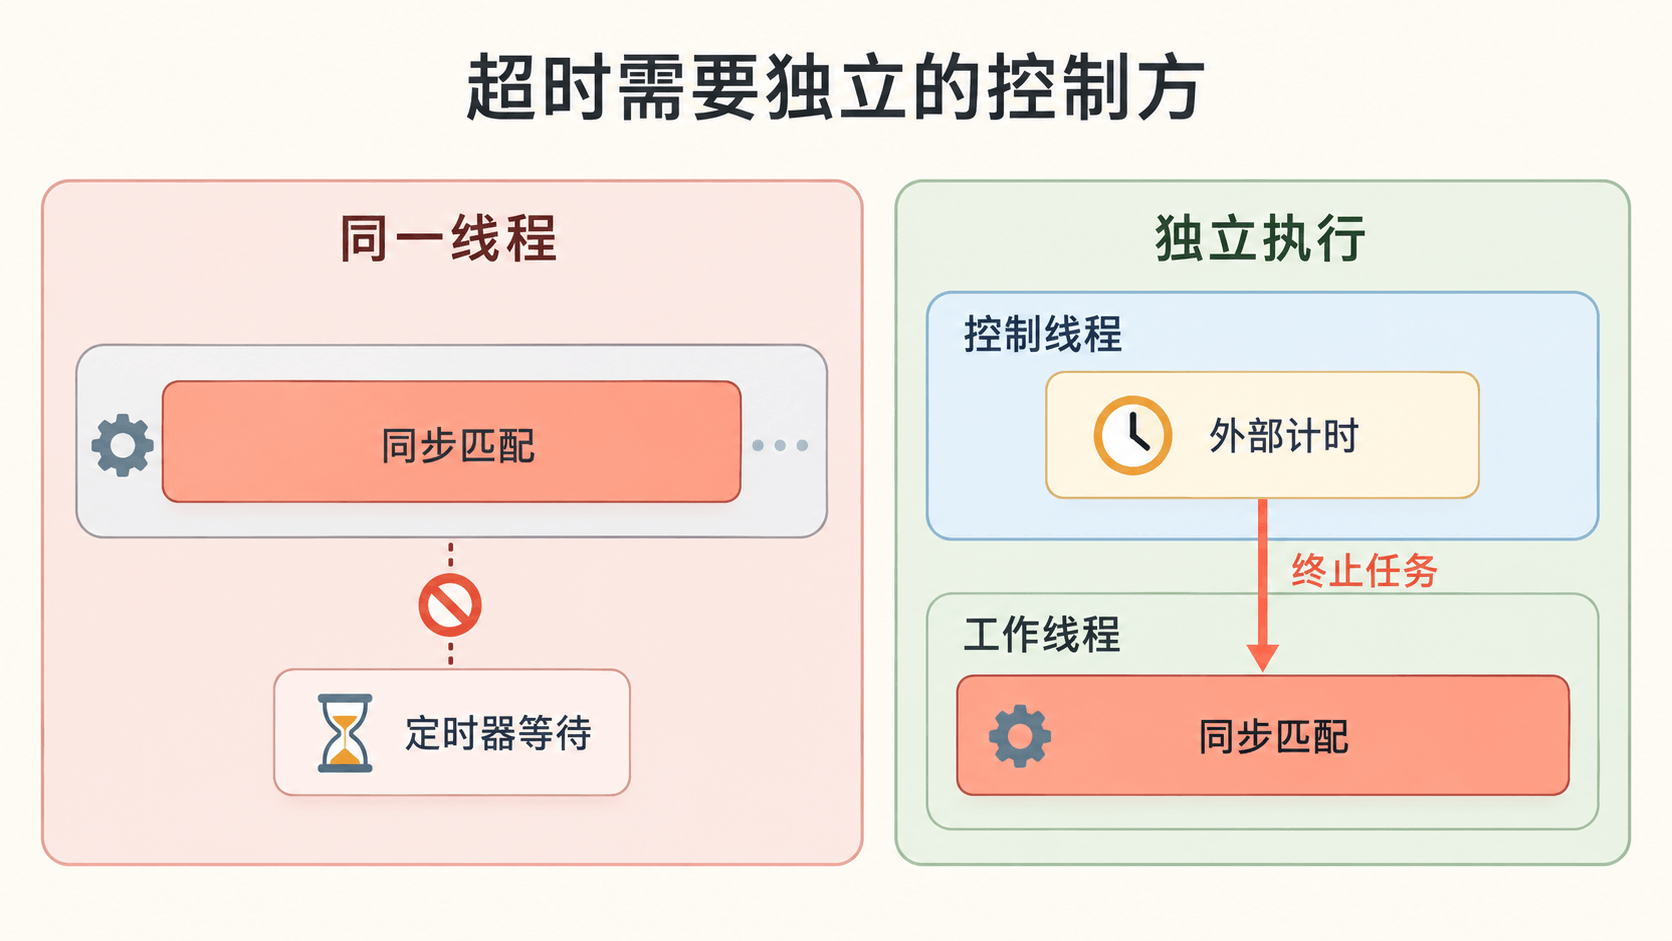
独立执行时,控制方把模式和文本交给工作方,启动外部计时,并接收结果或错误。正常完成就清理定时器,超过预算就终止工作方;使用 Node.js Worker 时,还应通过退出事件或终止返回的 Promise 确认退出,再释放任务槽位。需要处理「结果刚好到达,同时超时触发」的竞态,确保一次任务只产生一个最终结果。
浏览器的 Worker.terminate()会直接停止工作线程,不等待其中的业务代码自行结束。Node.js 的 worker.terminate()返回一个在工作线程退出时完成的 Promise,可以用来确认清理完成。取消定时器、拒绝外层 Promise 和真正停止 CPU 工作,是三个不同动作。
高频任务还要考虑创建线程的成本。可以使用有界的工作池和等待队列,超时后替换被终止的工作方;不能为每个外部请求无限创建 Worker。若控制线程本身也在执行昂贵同步工作,它的计时回调同样可能延迟,因此控制方应保持轻量。
用可终止的实验观察最坏输入
配套 probe-regexp.mjs 为每个样本启动独立 Node.js 子进程,外部设置一秒超时。2026-10-17 的一次单次冷执行记录如下,模式为 ^(a+)+$,输入为 n 个 a 加 !:
n |
默认引擎 | 开启过量回溯 fallback |
|---|---|---|
| 12 | 约 0.25 ms | 约 0.31 ms |
| 18 | 约 11.96 ms | 约 1.52 ms |
| 24 | 约 757.58 ms | 约 1.63 ms |
| 32 | 子进程超过一秒被终止 | 约 1.50 ms |
已完成样本的毫秒数只计匹配部分,不包括进程启动;超时则从外部启动子进程时开始计,两个口径不能混算。这组数据只展示一个模式和当前环境的增长现象,没有预热、重复采样或统计区间,不能作为引擎性能排名,也不能外推到不符合 fallback 条件的模式。
原始验证记录保留了版本、样本、诊断位置和引擎开关;源码包中的 pnpm probe 可以重新运行有限样本。日常回归更适合固定语义样本和外部执行预算,避免把精确毫秒阈值当成跨机器稳定断言。
日常 review 可以从哪里看起
- 对固定业务正则,先启用回溯和移动起点两类检查;报告要处理,未报告的复杂表达式仍要 review。
- 对用户输入,区分它是被匹配的文本、按字面量搜索的关键词,还是用户真正编写的模式。三种入口需要不同处理。
- 对允许自定义模式的功能,核对引擎支持的语法、模式规模、编译成本和执行预算;禁止不支持语法后的隐式不安全回退。
- 对引擎升级和迁移,分别验证功能语义与资源行为。实验开关、主分支实现、已发布库和终端实际版本要分别记录。
正则值得保留的优点是表达紧凑、匹配能力强;需要额外维护的是输入边界、失败路径和执行成本。把这些条件写进配置、测试和调用入口,才能让一行表达式继续保持可控。