给 Markdown 文档接入 textlint:加粗、术语和异常字符检查
一篇 Markdown 文章能正常生成网页,并不意味着里面的格式和用词都符合预期。双星号可能作为普通文字留在页面上,产品名称可能有几种拼法,从网页复制来的文字还可能夹着看不见的字符。
此前整理中文加粗为什么会露出星号时,我关注的是解析器为什么不接受某种写法。写文章时还需要另一层反馈:保存或提交之前,工具能不能直接指出那一行有问题?
textlint 提供了这样的检查框架。它的工作方式与 ESLint 接近,检查对象换成文档中的文字。加粗边界、技术术语、括号配对和异常字符可以各自交给一条规则,再由同一个命令运行。
文档检查也需要规则
textlint 是一个独立的工具。它负责读取文件、加载配置、解析文档、执行规则和整理诊断,具体怎样判断错误由规则包决定。它默认支持 Markdown 和纯文本,其他格式可以通过处理器插件扩展;安装 textlint 本身并不会自动启用一套中文写作规范。
这与 markdownlint 的默认体验有所不同。两者可以同时使用,但关注点有区别:
| 工具 | 主要关注 | 规则从哪里来 |
|---|---|---|
| markdownlint | 标题层级、列表、空行、代码围栏等 Markdown 结构和风格 | 自带规则,也支持自定义规则 |
| textlint | 用词、术语、标点以及文档中的特定问题 | 安装规则包或预设,再显式启用 |
这个分工描述的是各自的规则生态,不是能力限制。检查中文加粗失效的逻辑也可以写成 markdownlint 自定义规则;只是这次找到的现成实现发布在 textlint 生态里。
markdownlint 的 MD037检查强调标记内侧的空格,例如 ** 重点 **;MD050 检查加粗使用星号还是下划线。它们并不等同于「所有想加粗的文字都成功解析了」。在独立对照中,markdownlint 0.41.1 的默认规则没有报告 这是**重点。**然后继续。,专门的 CJK 强调规则则报告了结束标记。
对于已有博客,我更愿意先接入能解释清楚的问题检查。markdownlint 可以随后选取少量结构规则,例如标题层级、代码块语言;行长、列表标记和空行属于另一组约定,应结合现有文章决定。尤其是 Hexo 的文章标题由文件名和模板生成,不能直接照搬「正文必须从 H1 开始」的要求。
加粗已经解析失败,为什么还能检查
textlint 会先把 Markdown 解析成抽象语法树,再遍历其中的节点。
抽象语法树(AST)把源码组织成段落、文本、强调、链接和代码等结构。节点保留源码位置,规则因此能够指出具体的行列和字符范围。
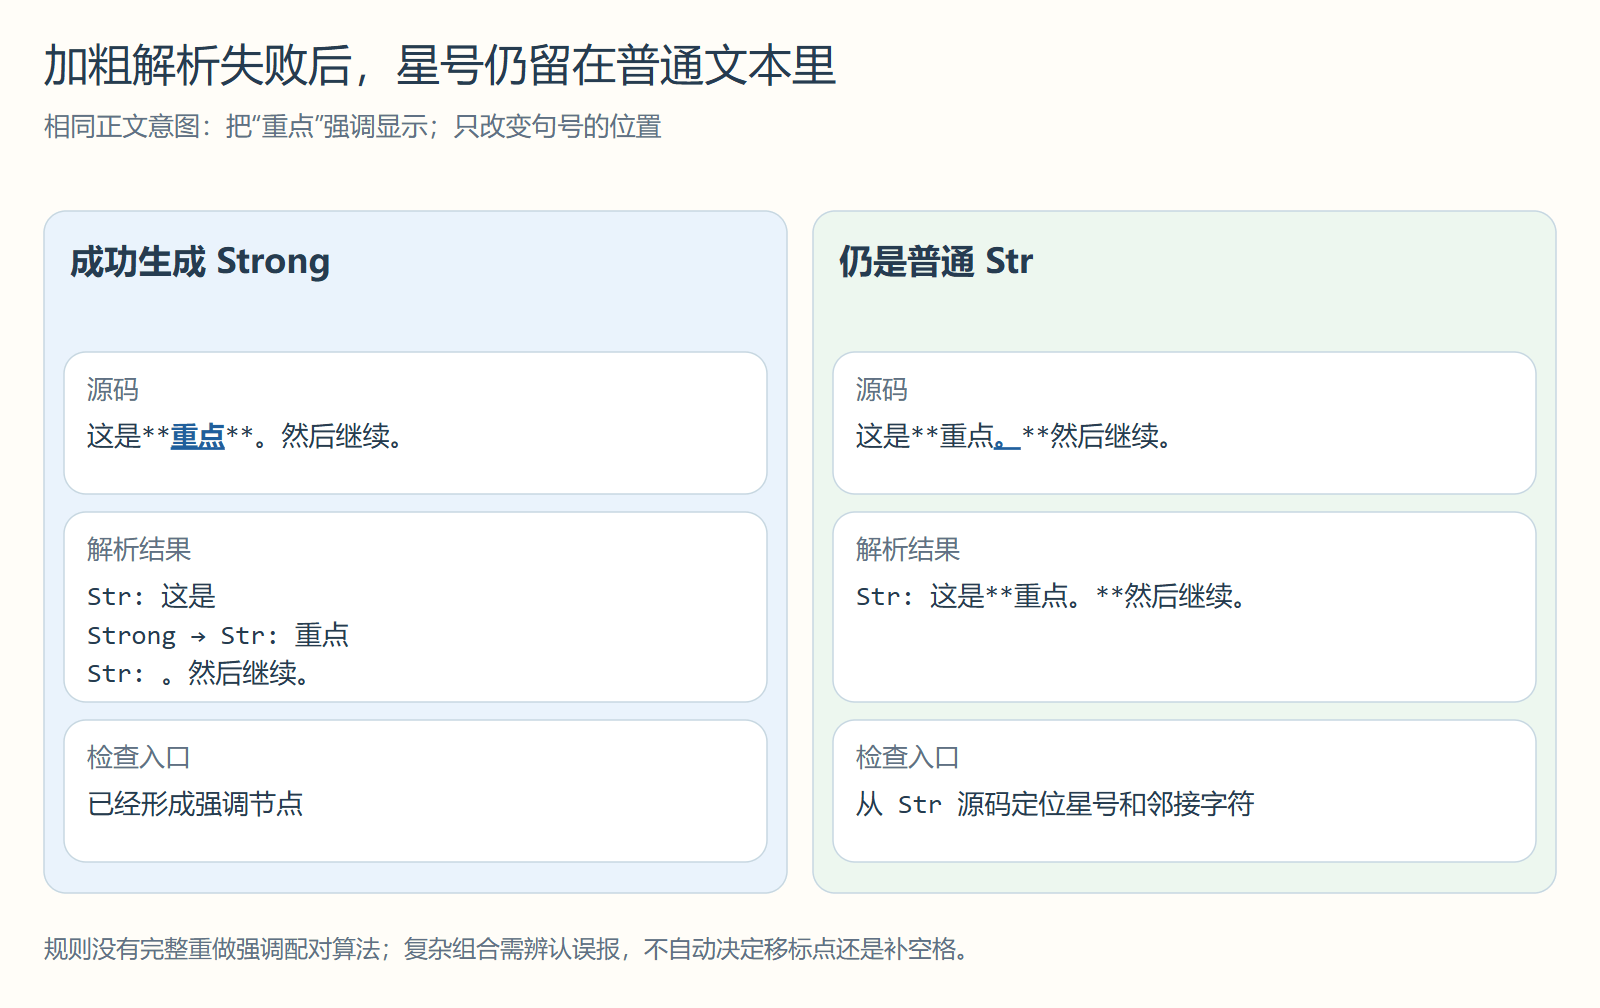
正确写法 这是**重点**。然后继续。 的结构可以简化为:
Paragraph
├─ Str: 这是
├─ Strong
│  └─ Str: 重点
└─ Str: 。然后继续。
有问题的 这是**重点。**然后继续。 则可能整段成为一个 Str 普通文本节点。星号没有消失,也没有变成有效的 Strong。因此,检查失败强调的规则需要回到普通文本中的源码,不能只遍历已经成功生成的加粗节点。
@lemonadern/textlint-rule-no-broken-cjk-emphasis 的 0.2.0 实现就在 Str 节点中寻找一至三颗连续星号,跳过转义写法,推测开始与结束角色,再用 CommonMark 的边界条件判断标点是否让标记失效。发现问题后,通过 textlint 的 report() 和位置 API返回诊断。
规则没有完整重做 CommonMark 的强调配对算法。同一文本节点里,同长度星号主要按出现顺序分配开闭角色,所以复杂组合、数学记号和通配符可能被误判。它也不提供自动修复:把标点移到强调外,和在外侧补空格,会产生不同的源码与排版,应由作者决定。
先接入能稳定解释的几项检查
我给博客启用的是五条规则,分别对应四类问题。包名和配置中的规则名略有区别,例如安装 textlint-rule-prh 后,在配置里写 prh。
中文强调的标点边界
@lemonadern/no-broken-cjk-emphasis 检查前面讨论的加粗失效,也覆盖部分单星号和三颗星号写法。它会跳过代码块、行内代码、链接 URL、HTML 标签及转义星号,因此文章可以正常展示反例。
这条规则以 CommonMark 的强调行为为前提。目标站点如果使用 CJK 友好扩展,某些被它报告的写法可能已经能够正常显示,是否保留检查要按实际解析链路判断。
用 prh 维护技术名称
textlint-rule-prh读取 YAML 词典,把不符合约定的写法对应到标准写法。它可以服务中文技术文档,但需要项目维护自己的词典。
这次词典只收录 JavaScript、TypeScript、GitHub、GitLab、WebSocket 和 Node.js 六个名称,主要检查大小写。下面是其中一项真实配置,放在项目根目录的 .textlint/prh.yml 中:
version: 1
rules:
  - expected: JavaScript
    options:
      wordBoundary: true
wordBoundary 要求匹配词边界,减少在较长英文标识符内部误替换的机会。是否替换中文近义词、是否统一技术译名,需要另有明确约定,不能因为词典工具支持替换,就把有语境差异的表达全部归成一种写法。
代码中的变量、命令和包名也不能按正文的产品名称随意修改。当前配置启用了 checkEmphasis,检查强调文本中的名称;引用块继续沿用规则默认的跳过行为,保留引用原文的拼法。
括号配对与异常字符
@textlint-rule/no-unmatched-pair检查它所支持的括号和引号配对,例如左侧用了 (,右侧却用了 )。它关注是否配对,不替项目决定中文括号和英文括号各自应该用于哪些场景。
异常字符拆成两条规则:@textlint-rule/no-invalid-control-character检查不允许的控制字符,默认保留换行、回车和制表符;no-zero-width-spaces检查零宽空格。两者范围不同,也不能被理解成「所有不可见 Unicode 字符检查」。
在仓库里运行
运行环境需要 Node.js 20 或更高版本。项目使用 pnpm,依赖装在开发依赖中,规则统一放在根目录 .textlintrc.json。安装和合并配置后,在项目根目录运行:
pnpm lint:posts这个入口只扫描 source/_posts/**/*.md,找到错误时返回非零退出码。源码包、文章附件和生成的 HTML 不在这个范围内;需要检查草稿或其他文档目录时,应显式扩展文件集合。
完整配置与最小示例可以在下面的源码工作区查看。迁移到已有项目时,合并 package.json 中的命令和依赖,保留原来的项目配置。
把 /files/textlint-markdown-writing-checks/kits/textlint-blog-checks/ 接入当前 Markdown 仓库。
先读 README.md 和 AGENT_PROMPT.md,按 FILES.json 获取配置,合并 copy/ 中的文件。
调整文章目录和术语词典,运行有效示例和问题示例,再扫描现有文章,保留完整诊断供人工复核。如果要保存完整结果,仓库另有 pnpm lint:posts:report,把 JSON 写到 .textlint-report.json。这是报告导出入口。textlint 15.8.0 使用 --output-file 时,即使结果中有错误,也返回 0;提交检查应运行前面的 lint:posts,或自行统计 JSON 中的错误,不能拿报告命令的退出码判断文章是否通过。
安装时遇到 micromark 子路径错误
这次安装还碰到了一个依赖解析问题:pnpm 11.17.0 配合 npmmirror 和默认发布时间检查,把旧 GFM 解析链路中的 micromark 选到了不兼容新 Node.js 的 2.11.0。它发生在规则开始运行之前。
原因、两种 registry 响应的对照、临时 override 的退出条件,以及 pnpm 11.28.2 和 12.11.2 的修复验证,单独整理在pnpm 为什么装到了旧版本:npmmirror 时间字段与依赖解析排查。使用旧 pnpm 的项目可以先保留兼容约束;升级到已验证版本后,再通过无 lockfile 的隔离安装与正文检查判断是否需要它。
扫一遍存量文章,先辨认误报
首次扫描覆盖了接入前的 97 篇正式文章,共得到 7 条诊断,全部来自QQ 超级调色盘配色分析。其中 1 条对应真实的强调边界问题,另外 6 条是普通星号触发了规则的推测。
真实问题的局部写法是:
基础色色相 h 在 **150°–330°(含端点)**时为 +1结束标记前面是 ),后面紧接汉字 时。处理时只强调数值区间,把括号说明放在外面,数值和端点含义保持不变:
基础色色相 h 在 **150°–330°**(含端点)时为 +1误报来自两个位置:正文里的 CIE L* 有 2 条,表格里的 on_bubble* 有 4 条。前者的星号是色彩空间记号,后者表示名称族,作者没有把它们当作强调开始符号。工具只能看到字符和局部结构,无法可靠地恢复这种意图。
其余四条规则在这批文章中没有报告问题。这个结果只对应当前词典和扫描范围;它不能证明所有术语都正确,也不能证明没有其他种类的不可见字符。
这 6 处误报通过转义字面星号处理:源码写成 CIE L\* 和 on_bubble\*,网页仍显示 CIE L* 和 on_bubble*,字体与排版保持不变。转义明确了星号的字面含义,不需要关闭规则或添加忽略注释:
CIE L\*
on_bubble\*
修正后,连同这篇介绍文章共扫描 98 篇,五条规则均为 0 条诊断。先确认诊断是否成立,再选择能保留原意的写法,检查结果才有长期参考价值。
后续规则跟着需求增加
这套接入方式可以逐步扩展。官方规则目录里还能找到链接检查、列表句号、括号宽度、英文拼写和英文表达风格等规则。目录按语言分类,日语技术写作预设包含日语语法与文风要求,不能直接当成中文写作规范。
对博客而言,规则最有价值的地方是把重复出现、能稳定判断的问题放到写作现场。技术判断、引用是否支持结论、例子是否有说服力,仍然需要人来读。词典与例外应留在仓库中维护,文章则保留规则为何需要、怎样接入,以及哪些诊断不能直接接受的依据。