React、Vue 2 与 Vue 3 的 DOM Diff:从节点身份到最长递增子序列
最近一道前端面试题问到了 React、Vue 2 和 Vue 3 的 DOM Diff。这个问题既涉及列表如何重排,也涉及更基础的更新:同一个按钮改了 class 与文本,是否重建 DOM;把 div 换成 section,原来的子组件状态还在不在;同一种组件收到新 props,和换成另一种组件又有什么区别。
这些场景需要先回答「旧节点与新节点是否属于同一个身份」,再决定更新什么。列表还多了一层顺序问题:旧列表是 [a, b, c, d, e],新列表是 [e, a, b, c, d],既可以只把 e 放到最前面,也可以依次把 a、b、c、d 放到后面,两种做法分别需要一次和四次移动。
下面先讲属性、文本、节点与组件的更新规则,再比较三种列表策略,并展开 Vue 3 使用的最长递增子序列。移动次数统一限定在同父级、唯一稳定 key、类型不变、每项一个普通宿主节点的列表上;组件、Fragment 与调度成本会另外说明。
Diff 在一次更新中负责什么
React 和 Vue 的常规虚拟 DOM 路径,会先生成对界面的新描述,再把它和上一次的描述匹配,最后修改宿主环境。浏览器里的宿主通常就是 DOM;自定义渲染器也可以把结果交给别的平台。
虚拟 DOM 是用 JavaScript 对象描述界面结构的一种方式。Vue 的节点通常叫 VNode;React element 描述需要渲染的内容,Fiber 还承载组件状态、父子兄弟关系、更新任务和副作用标记。它们的内部结构不同,讨论列表匹配时可以先把它们看作「带类型和身份的节点描述」。
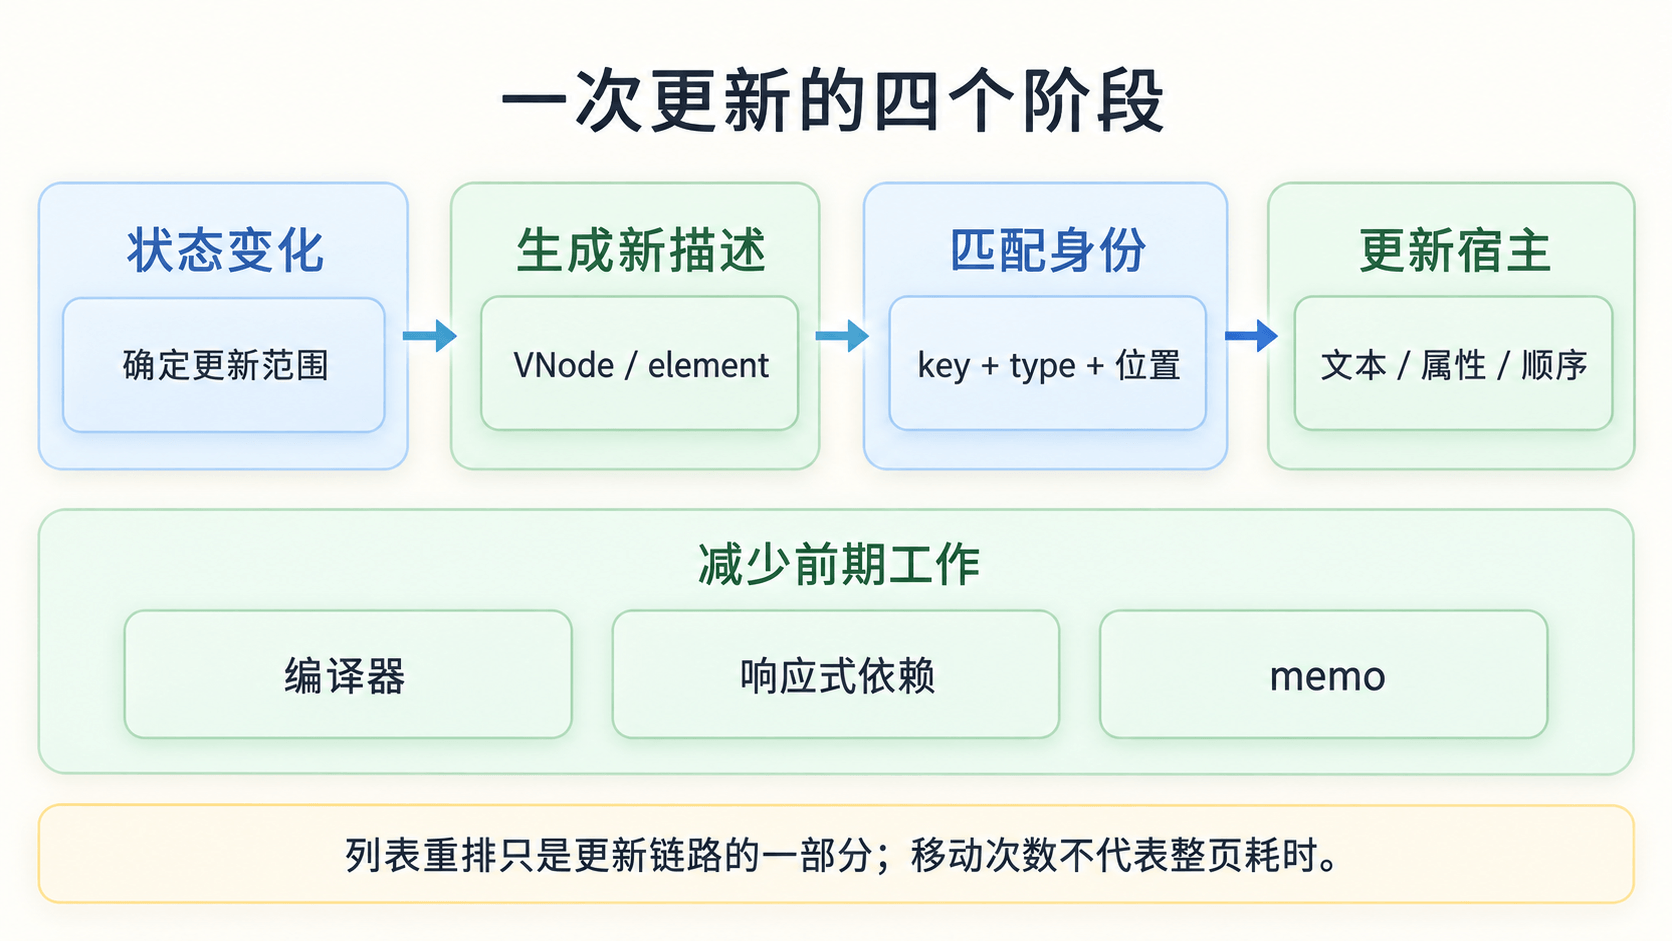
这里至少有三个独立的问题:状态变化会影响哪些组件或表达式;旧描述与新描述如何对应;对应关系确定后,宿主节点该怎样更新。列表 Diff 主要处在后两步。
因此,组件的 render 再执行一次,并不等于它下面的 DOM 全部重建。同样,某个 VNode 被复用,也可能继续更新文本、属性、事件或子节点。Vue 的 patch 流程和 React 的渲染与提交都需要按这些阶段理解。
先匹配身份,再讨论怎样移动
假设列表里有两条待办,每条都有一个本地输入状态。把数据从 [a, b] 改成 [b, a] 时,我们希望 b 的输入状态跟着 b 走。这就要求框架认出「新位置上的 b」和「旧位置上的 b」属于同一个身份。
React 的常见写法是:
{items.map(item => <TodoRow key={item.id} item={item} />)}Vue 的对应写法是:
<todo-row v-for="item in items" :key="item.id" :item="item" />key 给出了同一组兄弟之间的身份线索,节点类型还决定这份身份能否继续复用。相同 key 下把 TodoRow 换成另一种组件,或者把普通元素从 div 换成 span,不能只凭 key 相同就沿用原来的实现和状态。React 的状态保留规则明确把树中的位置、类型和 key 联系起来;Vue 3 的 isSameVNodeType也检查 type 和 key。
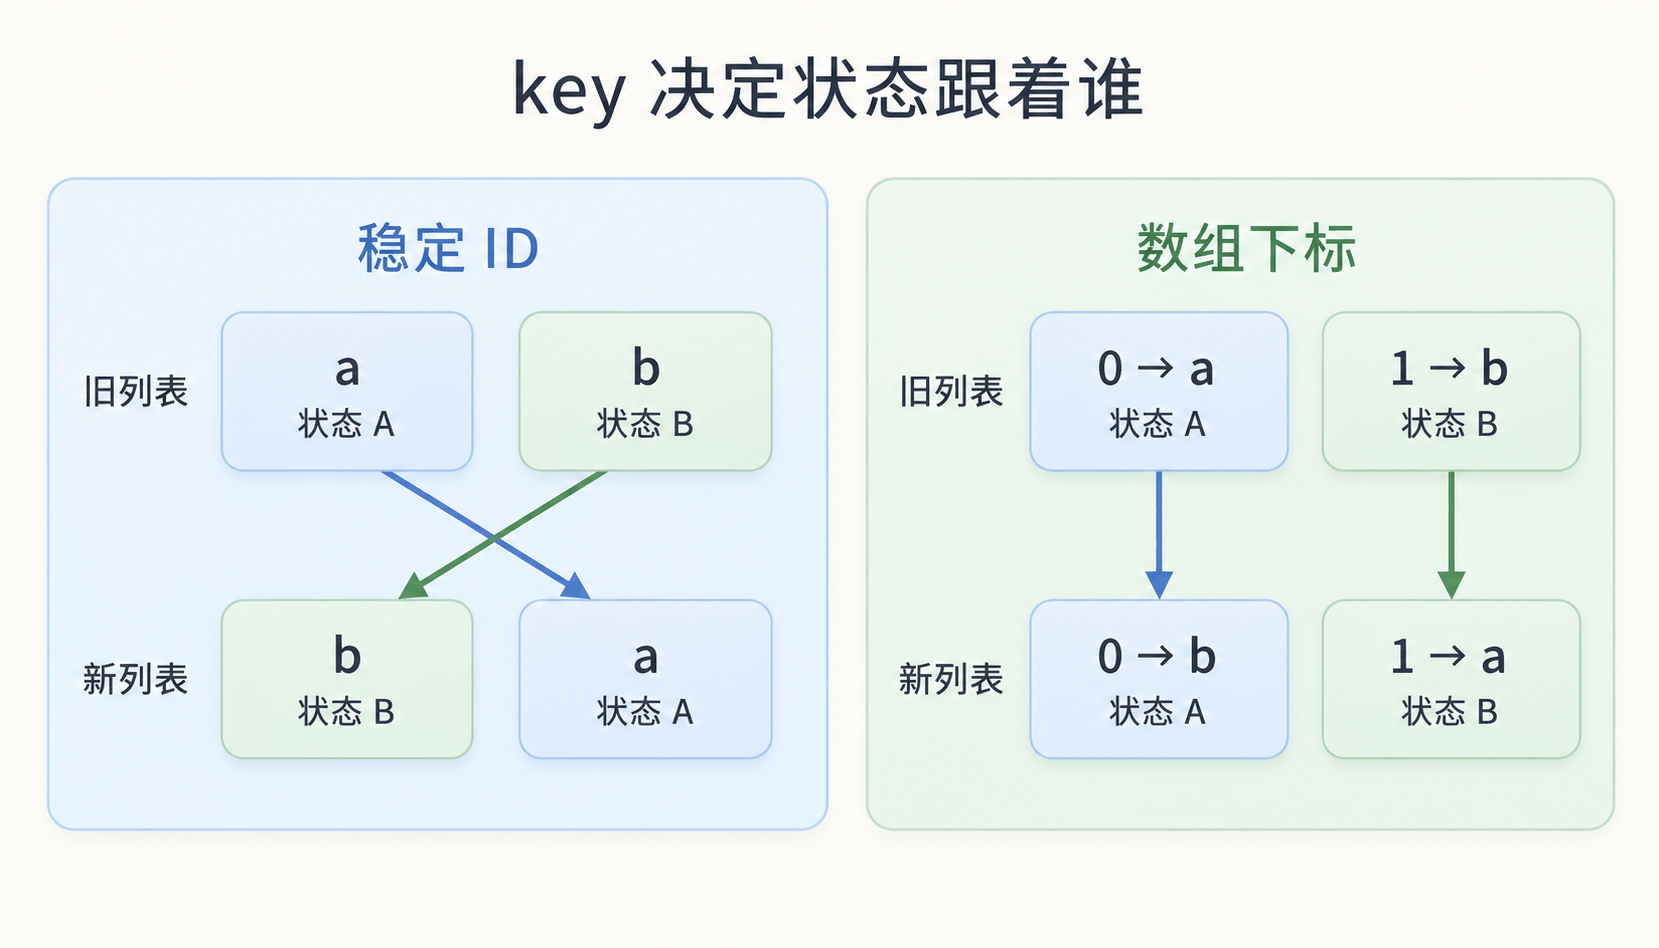
使用数组下标时,位置 0 的 key 始终是 0。数据重排以后,位置 0 的组件仍可能被复用,只是它接收到的业务数据从 a 变成了 b;输入状态却还属于原来的那个组件实例。页面有时看着排列正确,状态已经和业务项错配。
下标 key 是否适合,要看身份本来是不是位置。始终不重排、不插队、没有需要随业务项保留的本地状态时,它可以满足需求。可编辑、可排序的业务列表通常更适合稳定 ID。每次 render 都生成随机 key,会让身份不断变化,失去复用基础;重复 key 则会让同级匹配出现歧义。
key 的作用域通常是当前父节点的孩子集合。同一个 key 从一个父节点的列表移到另一个父节点的列表,不能据此推导出组件状态一定跨父级保留。Teleport、Portal、KeepAlive 等机制另有专门规则,不能用普通兄弟重排替代解释。
「同层比较」限制的是搜索范围
框架通常在一个父节点的孩子之间建立对应关系,再递归处理匹配节点内部的变化。这种局部身份规则避免了在整棵旧树里搜索每一个新节点。
「同层」容易让人联想到广度优先遍历,但它在这里主要表达匹配范围。两个节点即使深度相同,只要不属于同一组兄弟,也不一定会互相匹配;算法的实际执行顺序仍可能递归进入子树。
不少介绍会从「通用树比较 O(n³),框架降到 O(n)」讲起。React 的历史设计说明确实使用过这样的对照,但它指向特定的通用树比较研究和启发式假设。把它推导成「两棵树各遍历一次是 n²,执行增删移动再乘 n」并不成立:比较关系、编辑操作的定义、代价模型和树形都会影响复杂度。
后面讨论复杂度时,统一数当前父节点下的列表项,并把身份匹配、LIS 计算和真实宿主操作分开。这样才能解释 Vue 3 为什么在重排分支里出现 O(n log n),也不会把框架整个更新过程都写成一个 O(n)。
同一种元素:复用 DOM,更新属性和内容
先看比重排更常见的一次更新。按钮仍在原来的位置,类型和 key 都没有变化,只改了属性与文本。下面用 JSX 表示更新前后,Vue 模板的对应场景遵循同样的复用原则。
// 更新前
<button
  className="idle"
  title="提交表单"
  disabled={true}
  style={{ color: 'blue', marginTop: 8 }}
>
  提交
</button>

// 更新后
<button className="saving" data-state="saving" style={{ color: 'red' }}>
  保存中
</button>
这里可以继续使用原来的 HTMLButtonElement,在它上面处理变化。属性更新还包括删除新描述里已经不存在的旧值,只覆盖新值并不够。
| 比较项 | 变化 | 需要完成的工作 |
|---|---|---|
className |
idle → saving |
更新 class |
data-state |
无 → saving |
添加 data-state |
title |
有 → 无 | 移除旧 title |
disabled |
true → 未提供 |
清除按钮自身的禁用设置 |
style.color |
blue → red |
更新内联颜色 |
style.marginTop |
8 → 无 |
清除旧内联 margin-top,让样式重新由其余规则决定 |
| 文本 | 提交 → 保存中 |
更新按钮内容 |
如果只遍历新属性并写入,就会漏掉旧的 title、disabled 和 marginTop。React 的 updateProperties、Vue 2 的 attrs 等更新模块、Vue 3 的 patchProps都会处理旧值清理,只是具体入口与分工不同。
属性、DOM property、样式和事件要分开处理
日常说「更新属性」,经常把几种不同操作混在一起:HTML attribute 是标签上的特性;DOM property 是元素对象上的属性;style 还有自己的声明对象;事件需要接入监听与分发机制。框架不能把它们全部转换成 setAttribute(key, String(value))。
例如 HTML 的
disabled是布尔 attribute,是否存在才是关键。手写disabled="false"仍然声明了禁用;React 的disabled={false}、Vue 的:disabled="false"则传入布尔值,由框架按相应规则处理。字符串"false"和布尔值false不能混用。
文本输入框的当前内容由 DOM 的
input.value表示,不能把所有 value 更新都理解成修改 HTML 字符串。React 又区分控制当前值的value与提供初值的defaultValue,见 input 文档;Vue 的v-model则组合相应的 property 与事件来同步表单状态。表单控件需要专门处理,复用同一个 DOM 并不意味着用户输入永远不会被覆盖。
Vue 3 的 patchProp把 class、style、事件和其余属性分到不同处理函数,再根据元素与属性决定写 DOM property 还是 HTML attribute。下面是职责示意,省略了 SVG、强制绑定前缀和表单兼容分支,不是可直接替换源码的实现:
if (key === 'class') {
  patchClass(el, nextValue);
} else if (key === 'style') {
  patchStyle(el, prevValue, nextValue);
} else if (isEvent(key)) {
  patchEvent(el, key, prevValue, nextValue);
} else if (shouldSetAsProperty(el, key, nextValue)) {
  patchDOMProperty(el, key, nextValue);
} else {
  patchAttribute(el, key, nextValue);
}
style 为对象时,需要比较内部各项。React 的 setValueForStyles和 Vue 3 的 patchStyle都会清除新对象里缺失的旧样式,再设置需要变化的样式。这里清除 marginTop,也不代表最终计算样式一定是 0:外部样式表仍可能提供值。
事件最能说明「结果规则相近,内部实现不同」。更换点击回调时,Vue 3 的 patchEvent可以保留已注册的 invoker,只替换其中保存的回调;新增或删除事件时,再调用原生监听 API。React DOM 的事件系统则把许多事件委托到根容器,由分发流程读取当前处理函数;也有不能按同样方式委托的事件。
因此,改一个 onClick 不必等于对当前按钮执行一次 removeEventListener 再执行一次 addEventListener。理解属性 Diff 时,先确认新旧值的语义,再看框架把它交给哪个宿主更新模块。
节点兼容条件也有具体差异。例如同一位置、key 不变的
<input type="text">改成<input type="checkbox">,Vue 2 的sameInputType会令sameVnode判断失败,转而替换节点;若新旧都属于它认可的文本输入类型,则可以复用。React 的updateInput可以更新既有 input 的 type;Vue 3 普通路径的 VNode 类型仍是 input,再由宿主属性模块更新。只看标签字符串相同,还不足以替所有框架判断复用结果。
子内容变化,也不一定进入列表重排
父元素复用后,它的内容可能从文本变成一组元素,或者从一组组件变回文本。把 children 按「文本、节点数组、空」理解,能看清几类基本动作。
| 旧内容 → 新内容 | 处理思路 |
|---|---|
| 文本 → 文本 | 内容不同才更新文本 |
| 文本 → 节点数组 | 清除旧文本,挂载新孩子 |
| 节点数组 → 文本 | 卸载旧孩子,再设置文本 |
| 节点数组 → 节点数组 | 匹配孩子身份,递归 patch,处理增删与顺序 |
| 有内容 → 空 | 清除文本,或卸载旧孩子 |
| 空 → 有内容 | 设置文本,或挂载孩子 |
这个表描述的是常见结果与职责,React 和 Vue 的内部节点表示、快速路径并不完全一样。Vue 3 的 patchChildren直接按 children 的形态分支;React 还会区分宿主元素中的直接文本与需要协调的子节点。
「清空旧 DOM」不能替代「卸载旧组件」。例如把
<div><Editor /></div>改成<div>暂无内容</div>,外层 div 可以保留,但 Editor 已离开组件树,需要按框架规则释放它的组件工作和副作用。直接写div.textContent = '暂无内容'只完成了浏览器节点操作,不能单独代表完整的框架更新流程。
节点类型变化与组件整体替换
判断能否复用,要先分清当前比较的是普通元素,还是组件。<div> 的类型是宿主标签;<Counter> 的类型是那个组件定义。组件生成的根 DOM 又是下一层描述,两层身份不能合并判断。
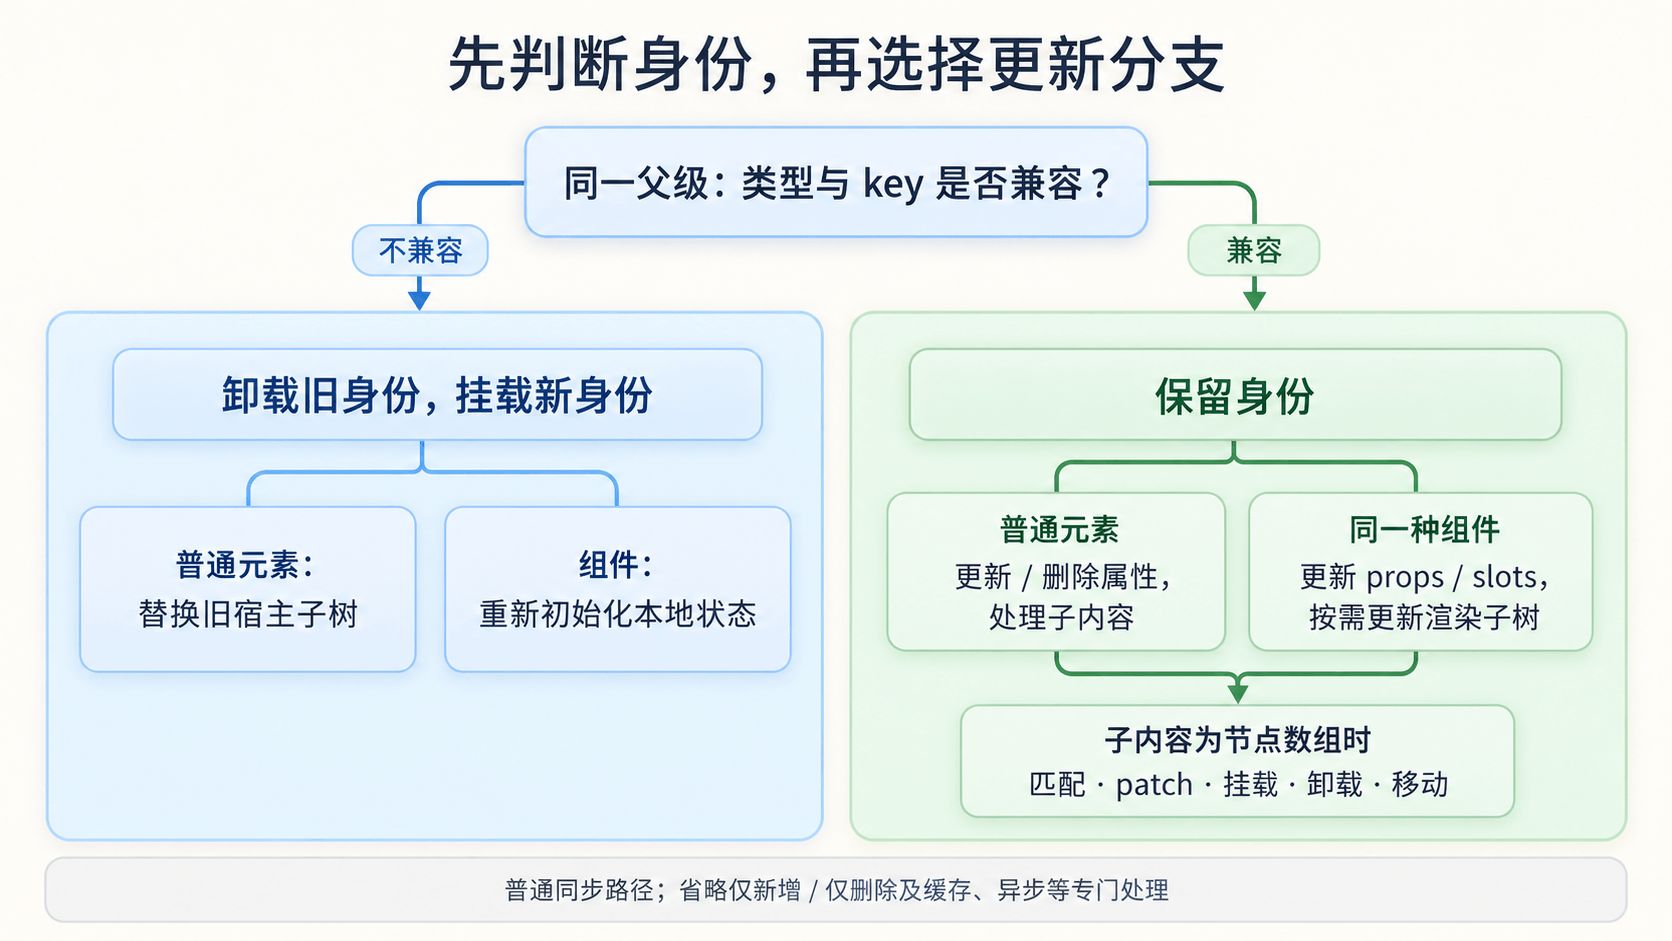
普通元素类型不同,旧宿主子树需要替换
例如同一位置从下面的 div 变成 section:
// 更新前
<div><Counter key="counter" /></div>

// 更新后
<section><Counter key="counter" /></section>
在普通 React / Vue 虚拟 DOM 路径中,div 与 section 属于不同类型,框架会卸载旧宿主子树并挂载新子树。旧 Counter 也随旧父节点离开,新的 Counter 重新初始化本地状态。即使 Counter 的类型与 key 写得一样,也不能跨过已经替换的父节点继续匹配。
Vue 3 的 patch在进入具体节点分支之前,就有下面这段判断:
if (n1 && !isSameVNodeType(n1, n2)) {
  anchor = getNextHostNode(n1);
  unmount(n1, parentComponent, parentSuspense, true);
  n1 = null;
}
旧节点身份不兼容时,先记录新内容的插入锚点,卸载旧树,再把 n1 置空;后续按新节点类型进入挂载分支。React 的节点类型与子树规则也描述了不同宿主类型引起的子树重建。
「整体替换」是身份和生命周期层面的概括,不必理解成只调用一次 DOM API。旧树可能包含许多组件与宿主节点,新树也需要逐步建立。Transition、KeepAlive、Portal / Teleport、Suspense 等功能还会加入专门处理;这里讨论普通同步内容的身份规则。
同一种组件,只改 props,通常继续保留本地状态
例如同一父级下的 Counter 从 step={1} 变成 step={2},组件类型和 key 都不变:
// 更新前
<Counter key="main" step={1} />

// 更新后
<Counter key="main" step={2} />
Counter 的本地计数可以保留,新 props 参与后续渲染,再比较它输出的子树。React 延续对应 Fiber 上的组件状态,Vue 复用组件实例;既有状态的初始化逻辑不会因为普通 props 变化就重新来一遍。
这里的 props 是组件输入,不一定直接变成根 DOM 的同名属性。step 可能只改变点击时加多少,也可能改变文本、样式或整段结构,最终需要看组件如何使用它。
Vue 2 的 prepatch会沿用旧 componentInstance 并更新子组件输入;Vue 3 的 updateComponent同样先取得旧实例,再判断是否需要更新。React 的 updateElement则检查组件类型兼容性,能够复用时继续使用既有 Fiber 的状态。
「复用组件」和「每次都执行组件渲染」也不是一回事。React 的 memo、Vue 的更新判断与编译器提示可以跳过部分工作;组件自己也可能通过 effect、watch 或业务逻辑主动修改状态。这些都需要与框架身份导致的重建分开理解。
组件类型或 key 不同,建立新的组件身份
把同一位置的 <Counter key="main" /> 换成 <Timer key="main" />,组件类型变了,即使两者最后都输出一个 button,也不能因此沿用 Counter 的组件状态。反过来,类型不变而 key 从 a 变成 b,同样会建立新身份。
这也是 key 在列表之外的用途。例如切换不同用户的编辑表单时,可以让用户 ID 成为表单 key:
<ProfileForm key={user.id} user={user} />当 user.id 变化,旧表单的本地草稿状态随旧身份销毁,新表单重新初始化。Vue 可以写成 <ProfileForm :key="user.id" :user="user" />,其 key 文档也说明了利用 key 强制替换组件的用法。
旧组件的卸载与清理、新组件的初始化和挂载,会按各自框架的生命周期规则执行。被重置的是旧组件及其被卸载后代的本地状态;父组件、外部 store 或服务端保存的数据,不会因为这个 key 变化自动清空。
同一个组件换根 DOM,组件状态仍可以保留
再看一个容易混淆的例子。Counter 类型和 key 一直相同,只是 asSection 改变后,它的渲染结果从 div 变成 section:
function Counter({ asSection }: { asSection: boolean }) {
  const [count, setCount] = useState(0);
  const content = <button onClick={() => setCount(count + 1)}>{count}</button>;
  return asSection ? <section>{content}</section> : <div>{content}</div>;
}
这个 Counter 自身的身份没有变化,count 可以保留;它输出的 div 与 section 身份不兼容,因此根宿主子树替换。如果这个根节点下面还有带本地状态的子组件,那些后代会随旧根子树卸载。Vue 组件在 render 或模板条件分支中输出不同根标签时,也要分层看待组件实例与它的渲染子树。
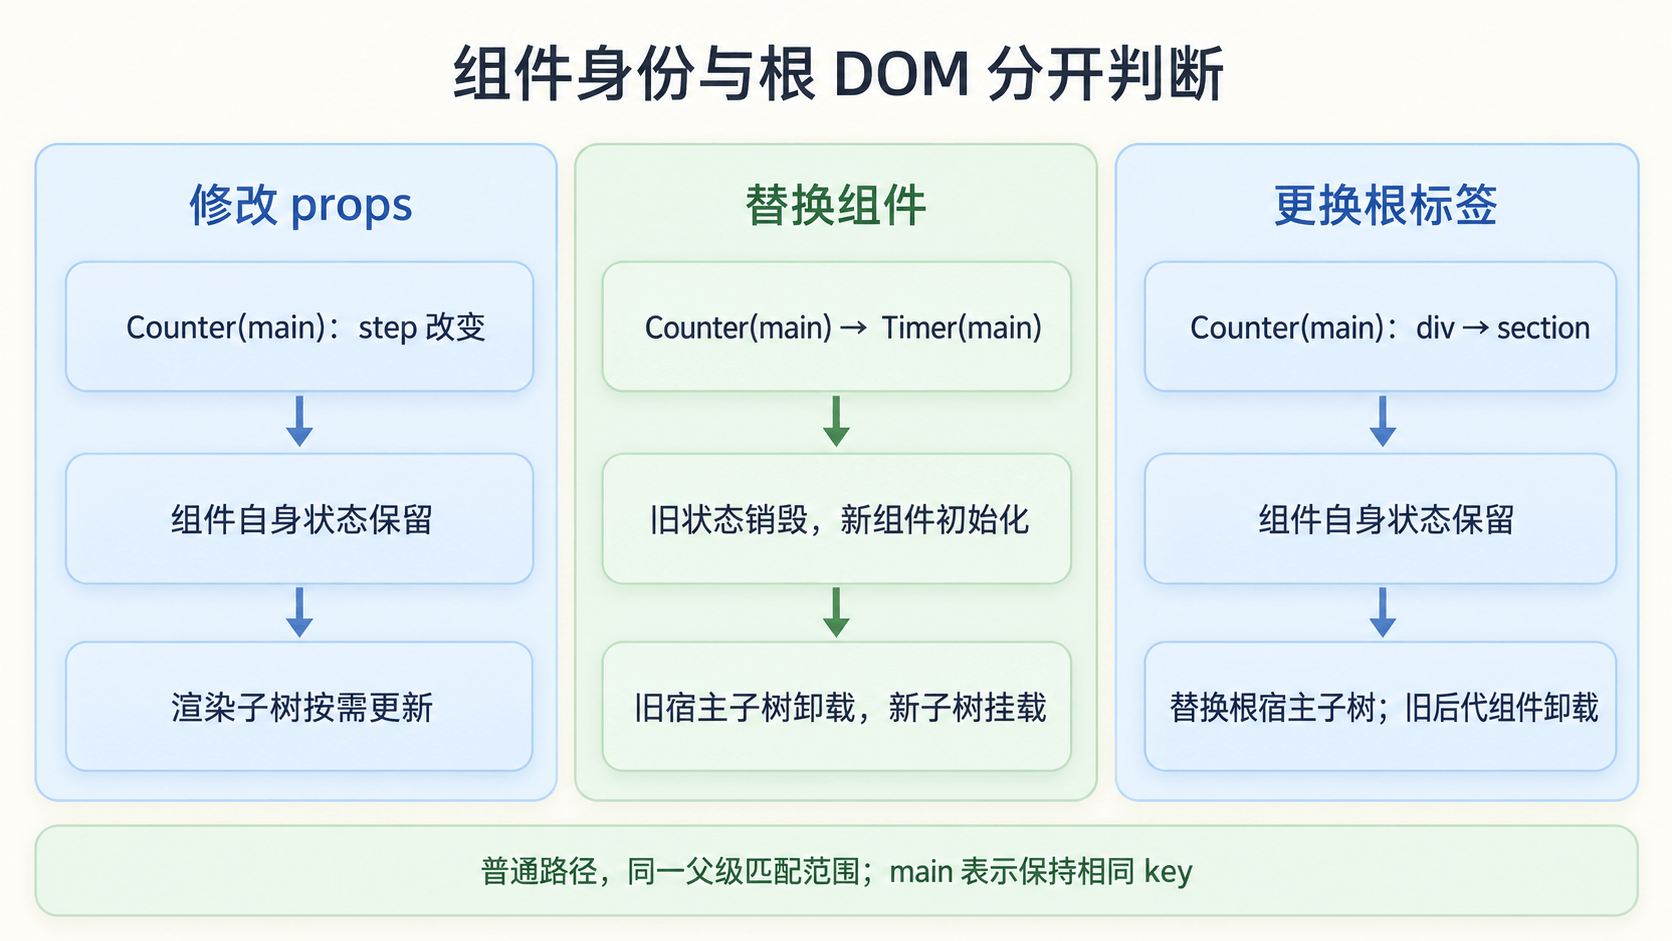
把这些情况并排比较,普通路径的共同规则就很清楚了:
| 场景 | 当前身份是否保留 | 后续主要工作 |
|---|---|---|
| 身份兼容的普通元素改属性 | 保留 DOM | 更新属性、事件与内容 |
| 普通元素类型或 key 改变 | 不保留旧宿主子树 | 卸载旧树,挂载新树 |
| 同类型、同 key 的组件改 props | 保留组件身份与既有状态 | 更新输入,按需渲染并 patch 子树 |
| 组件类型或 key 改变 | 不保留旧组件身份 | 卸载旧组件,初始化新组件 |
| 同一个组件输出不同根标签 | 组件身份保留,根宿主身份改变 | 保留组件自身状态,替换根宿主子树 |
| 一组兄弟的顺序或数量改变 | 逐项判断 | 匹配、patch、挂载、卸载与移动 |
React、Vue 2、Vue 3 在这些普通场景里有相近的身份与复用原则。接下来重点比较的分歧,是一组兄弟之间如何寻找对应关系,以及怎样安排移动;属性模块、事件系统、组件更新调度和编译器提供的信息,仍然各有实现。
先让三种策略处理同一个重排
旧列表 [a, b, c, d, e] 变成 [e, a, b, c, d],节点类型和 key 都保持不变。在本文限定的单宿主节点模型里,三种策略的判断结果如下。
| 策略 | 明确移动哪些项 | 移动次数 |
|---|---|---|
React 的 lastPlacedIndex 策略 |
a、b、c、d |
4 |
| Vue 2 的四端比较 | e |
1 |
| Vue 3 的按需 LIS 策略 | e |
1 |
可以点「下一步」观察每个策略的判断,也可以切换「头项移到尾部」「中段重排」和「仅插入删除」。三个模型的步骤数不同,先结束的模型会停在最终状态。
独立打开列表演示可以获得更宽的阅读空间。演示用数组模拟宿主节点顺序,保留关键判断;React 模型省略了前缀快速匹配。它适合解释流程,不包含组件执行、Fragment、并发调度、hydration 和浏览器布局成本。
Patch 表示把一个可复用的旧节点更新到新描述,内部仍可能更新属性或递归更新孩子。演示中的「保留」只表示当前逻辑项不需要显式重排,不表示它的内容一定不变。
Vue 2:每轮比较四个端点
Vue 2 的孩子列表更新以两组头尾指针推进。旧列表有 oldStartIdx、oldEndIdx,新列表有 newStartIdx、newEndIdx。每轮先尝试几种成本很低的端点匹配,命中后 patch,必要时直接移动节点。
四种配对有固定顺序
vue@2.7.16 的 updateChildren按下面的顺序尝试匹配。此前还会跳过旧数组中已经置空的槽位。
| 旧节点与新节点 | 命中后的处理 | 指针变化 |
|---|---|---|
| 旧头与新头 | patch,位置可保持 | 两个头前进 |
| 旧尾与新尾 | patch,位置可保持 | 两个尾后退 |
| 旧头与新尾 | patch,把旧头移到当前旧尾之后 | 旧头前进,新尾后退 |
| 旧尾与新头 | patch,把旧尾移到当前旧头之前 | 旧尾后退,新头前进 |
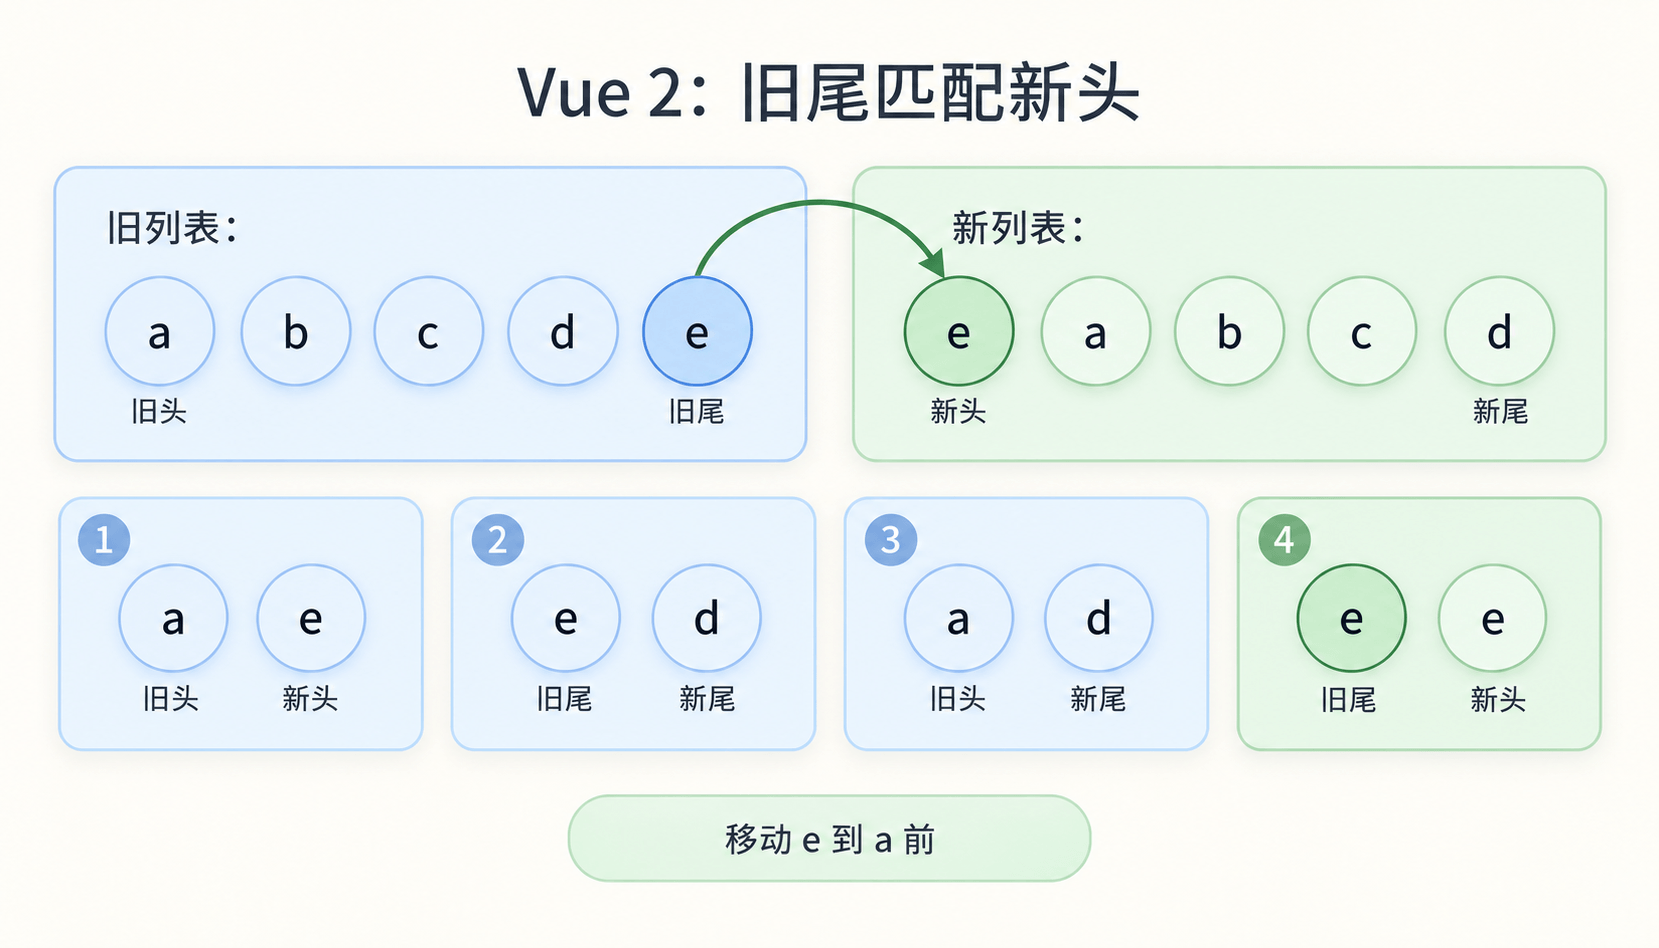
对于尾项移到头部的例子,前三种配对都失败,第四种发现旧尾和新头都是 e。框架把旧 e 对应的 DOM 放到旧 a 前面,列表已经成为目标顺序。剩下的 a、b、c、d 再通过端点匹配完成 patch。
Vue 2 同时检查了「旧头对应新尾」和「旧尾对应新头」,所以这种算法能直接处理两种方向的首尾轮转。
Vue 2 的
sameVnode判断包含 key、标签、注释节点状态等条件,输入元素还涉及类型兼容检查。用「key 与 type」概括身份规则有助于理解,但它不是 Vue 2 判断函数的逐字翻译;完整条件见同一文件的sameVnode。
端点都不匹配时,再查旧列表
端点匹配失败后,Vue 2 会为剩余旧孩子建立 key → 旧下标 的索引,并尝试定位当前新头。
- 找不到旧项,就在当前旧头前创建新节点。
- 找到且能复用,就 patch,再把对应旧 DOM 移到当前旧头前,并把旧数组中的原槽位置空。
- 找到相同 key 却不符合节点兼容条件,仍然需要创建新节点。
置空很有必要。旧项已经通过兜底分支移走,后续头尾指针再次遇到那个槽位时,要知道它已经被处理过,不能重复使用。新头处理完就前进,继续下一轮四端比较。
当旧区间先用尽,新区间剩余的项统一挂载;当新区间先用尽,旧区间剩余且未被复用的项统一卸载。这里判断的是区间是否耗尽,例如 oldStartIdx > oldEndIdx,指针恰好相等时仍有一项要处理。
它没有求全局最少移动
四端比较是局部策略,兜底也是围绕当前新头推进。它在首尾轮转等模式里很有效,但没有额外求整个重排的最长递增子序列,不能保证任意排列的移动次数都最少。
例如旧 [a, b, c, d, e, f] 变成新 [a, c, d, b, f, e]。Vue 2 先保留 a,随后兜底把 c 和 d 分别移到 b 前,最后再把 e 放到 f 后,共移动 3 项。保留 a、c、d、f 的相对顺序,只移动 b 和 e,则只需要 2 次。演示中的「六项交错重排」可以逐步观察这组差异。
在唯一 key 且可以直接查表的普通列表中,匹配与推进通常按线性规模进行,索引表最多占 O(n) 空间。对缺少 key 的兜底路径,Vue 2 还存在 findIdxInOld线性搜索;重复搜索可能把某些输入推向平方级。复杂度结论需要带上 key 和实际分支条件。
Vue 3:先同步两端,再处理未知中段
Vue 3 普通渲染器的 patchKeyedChildren 采用另一条主线:先 patch 相同前缀,再 patch 相同后缀,接着判断剩余部分是纯新增、纯删除,还是需要进一步匹配的中段。
这里的「同步两端」与 Vue 2 的四端轮询不同。Vue 3 并不在每一轮依次做四种端点交叉匹配,而是把尚未解决的重排交给中段映射与按需 LIS。
相同前后缀仍然要 patch
假设旧、新列表分别是:
const oldKeys = ['a', 'b', 'c', 'd', 'e', 'f', 'g'];
const newKeys = ['a', 'b', 'e', 'd', 'c', 'h', 'f', 'g'];
前缀 a、b 的身份相同,依次 patch;后缀 f、g 的身份也相同,从后往前 patch。剩下的区间是旧 [c, d, e] 与新 [e, d, c, h]。
如果同步后旧区间为空,新区间的剩余项可以直接挂载;如果新区间为空,则卸载旧区间。纯追加、纯裁尾、保留相同后缀的前插等场景,经常在这些分支就结束,不需要 LIS。
同步前后缀省掉的是进一步寻找身份和规划位置的工作。key 相同的
a仍可能从文本「未完成」变成「已完成」,因此同步过程中依然要 patch。
中段先建新索引表,再扫描旧节点
vue@3.5.44 的中段处理先为新中段建立 key → 新下标 的 Map,再遍历旧中段。
旧节点在新表里找不到,就卸载;找到时,先 patch,并把它的旧位置写入 newIndexToOldIndexMap。这个数组按新顺序排列,保存的是旧下标加一。
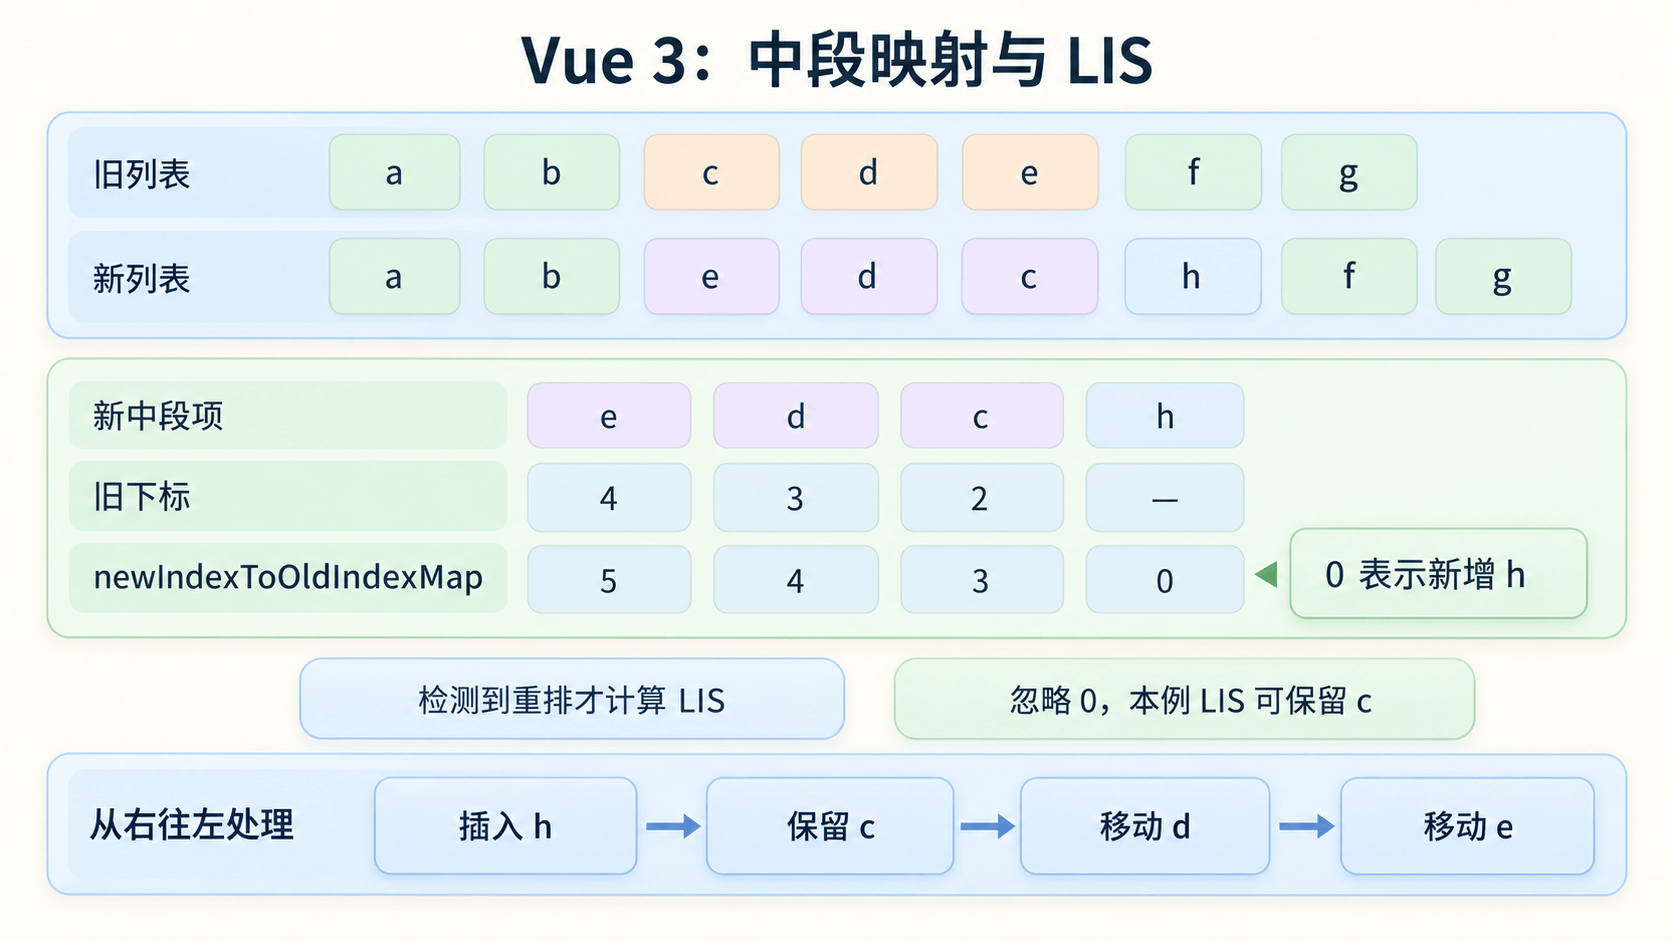
| 新中段项 | 在完整旧列表中的下标 | 映射值 |
|---|---|---|
e |
4 | 5 |
d |
3 | 4 |
c |
2 | 3 |
h |
不存在 | 0 |
所以映射数组是 [5, 4, 3, 0]。加一是为了空出 0,把它作为「没有可对应旧位置」的标记;旧下标 0 自己也是合法下标,不能和新增节点混在一起。
这里新表记录完整新列表的下标,映射数组使用中段内的局部下标。源码里的
newIndexToOldIndexMap[newIndex - s2] = i + 1同时体现了这两个坐标系:s2是新中段起点,i是完整旧列表中的位置。
扫描旧节点时,Vue 3 还记录找到的新下标是否保持递增。若旧顺序对应到新顺序时已经出现倒退,就把 moved 设为 true;只有检测到这种重排,后面才计算 LIS。
最长递增子序列保留的是相对顺序
先忽略新增项,看一个更容易观察的排列:旧列表 [a, b, c, d, e],新列表 [b, d, a, c, e]。按新顺序写出旧下标,得到 [1, 3, 0, 2, 4]。
其中 [0, 2, 4] 对应 a、c、e。它们在旧列表中的相对顺序已经和新列表一致,可以都不主动移动,只把 b、d 放到合适的位置。
子序列 可以跳过元素,但必须保留先后顺序;严格递增 要求后一个数大于前一个数。
[0, 2, 4]是这里的递增子序列,不要求数字连续,也不要求它们占据新列表中连续的槽位。最长递增子序列常缩写为 LIS(Longest Increasing Subsequence)。
为什么保留最长的那条,就能得到最少的移动次数?设新旧列表共同保留了 r 个身份,每次操作可以把一个既有项移动到任意位置,成本统一为 1。
- 所有从未被移动的项,在最终结果里仍然维持原来的相对顺序。因此它们对应的旧下标必须组成递增子序列,数量最多是 LIS 的长度
L。 - 至少有
r - L个项必须移动,这是下界。 - 固定一条 LIS,从后往前把其余项放到正确的后继之前,可以在恰好
r - L次移动内得到目标顺序。
下界可以达到,于是在这个模型中,最少既有项移动次数 = r - LIS 长度。新增和删除要另外计算。
这个证明依赖「单项可以移动到任意位置,且各项移动成本相同」。如果一项渲染多个 DOM 节点、带过渡动画,或者优化目标是布局耗时、焦点保持、带权移动成本,就不能把同一个公式当作整页性能最优的证明。
从右往左处理,后继就是锚点
映射 [5, 4, 3, 0] 中,忽略 0 后最长递增子序列的长度为 1,可以保留 c。Vue 3 从新中段的右端向左处理:
h对应 0,挂载到已确定位置的f前。c属于所选 LIS,保留。d位于 LIS 外,移到c前。e位于 LIS 外,移到d前。
最终得到 [a, b, e, d, c, h, f, g]。逆序处理让右侧后继的位置已经可用,不必反复计算一个随着插入而变化的绝对 DOM 下标。
锚点 是插入位置的参照节点。
parent.insertBefore(node, anchor)把节点放到anchor之前;anchor为null时相当于追加到末尾。对已经在 DOM 树中的节点执行插入,会移动原节点,通常不需要手动先删除再创建。组件、Fragment 等还需要渲染器把逻辑节点转换成相应的宿主节点或范围。
源码中的关键调用关系如下。这是官方源码的节选,省略了循环中的其他 patch 参数和挂载分支:
// vuejs/core@v3.5.44/packages/runtime-core/src/renderer.ts:2036-2077(节选)
const increasingNewIndexSequence = moved
  ? getSequence(newIndexToOldIndexMap)
  : EMPTY_ARR
j = increasingNewIndexSequence.length - 1
for (i = toBePatched - 1; i >= 0; i--) {
  // ...省略 nextChild / anchor 计算和新增节点的挂载分支
  if (newIndexToOldIndexMap[i] === 0) {
    // ...省略 patch(null, nextChild, ...)
  } else if (moved) {
    if (j < 0 || i !== increasingNewIndexSequence[j]) {
      move(nextChild, container, anchor, MoveType.REORDER)
    } else {
      j--
    }
  }
}getSequence返回的是映射数组中被选项的下标,循环里的 i 也在这个局部坐标系中比较。把 LIS 的值、映射数组下标和完整新列表下标混用,容易在实现时移动错节点。
有 key、无 key 与复杂度
Vue 3 编译结果可以通过 KEYED_FRAGMENT 和 UNKEYED_FRAGMENT 选择不同孩子更新路径。明确的无 key 列表会在 patchUnkeyedChildren中按位置 patch 共同长度,再处理多余项;它没有为业务项寻找跨位置的稳定身份。
普通 keyed 路径也保留了对混合、缺 key 输入的兜底处理:旧项缺少 key 时,会在未匹配的新项中按兼容类型搜索。这个分支可能重复线性搜索,不能把它和唯一 key 的查表路径混成同一种复杂度。
以当前父节点下 n 项为尺度,唯一 key 的索引与匹配一般是 O(n);需要求 LIS 时,重排规划增加 O(n log n) 时间,辅助空间为 O(n)。这是列表匹配与移动规划的口径,尚未计算递归 patch 子树、组件执行、宿主插入和浏览器渲染。
React:向前扫描,用旧下标阈值判断 Placement
React Fiber 的普通数组孩子匹配,先沿旧兄弟链和新数组向前尝试对齐。容易匹配的前缀处理完以后,如果还有无法对齐的项,再把剩余旧 Fiber 放进 Map,通过 key 查找;缺少显式 key 的项会使用相应位置索引参与匹配。
旧列表先用尽时可以直接创建余下新项,新列表先用尽时可以删除余下旧项。进入 Map 路径后,匹配并复用的旧项会从表中移除,最后留在表里的旧项进入删除流程。完整分支见 reconcileChildrenArray。
lastPlacedIndex 保存旧顺序中的阈值
React 在遍历新列表时记录 lastPlacedIndex。对可复用项,它比较当前项的旧下标与这个阈值:
oldIndex >= lastPlacedIndex,当前项可以加入已经保留的顺序,把阈值更新成oldIndex。oldIndex < lastPlacedIndex,当前项的旧位置落在已保留顺序之前,需要标记Placement,阈值保持不变。- 没有对应旧 Fiber 的新项,也标记
Placement,阈值保持不变。
Placement 是 Fiber 上的一类提交标记,可以对应新节点的插入,也可以对应已有节点的重排。匹配阶段主要记录这项工作,宿主修改在提交阶段执行;它不等于一个固定的「向右移动一格」命令。
placeChild的复用分支很短,核心判断可以直接看到:
// facebook/react@v19.3.0/packages/react-reconciler/src/ReactChildFiber.js:523-535(节选)
const current = newFiber.alternate;
if (current !== null) {
  const oldIndex = current.index;
  if (oldIndex < lastPlacedIndex) {
    // ...省略官方开发环境说明注释
    newFiber.flags |= Placement;
    return lastPlacedIndex;
  } else {
    // ...省略官方说明注释
    return oldIndex;
  }
}
alternate 在这里连接可复用的旧 Fiber 与正在构建的新 Fiber,所以 current.index 是它上一次所属兄弟序列中的位置。newFiber.index = newIndex 另外记录新位置。
阈值始终来自已经保留项的旧下标。它既不是 max(oldIndex, newIndex),也不是下一次操作的 DOM 目标下标。
尾项移到头部,为什么会移动四项
按 [e, a, b, c, d] 读取旧下标,就得到 [4, 0, 1, 2, 3]。初始阈值为 0,先看到 e 的 4,可以保留它,阈值变成 4;随后每一项的旧下标都小于 4,因此 a、b、c、d 分别被标记为 Placement。
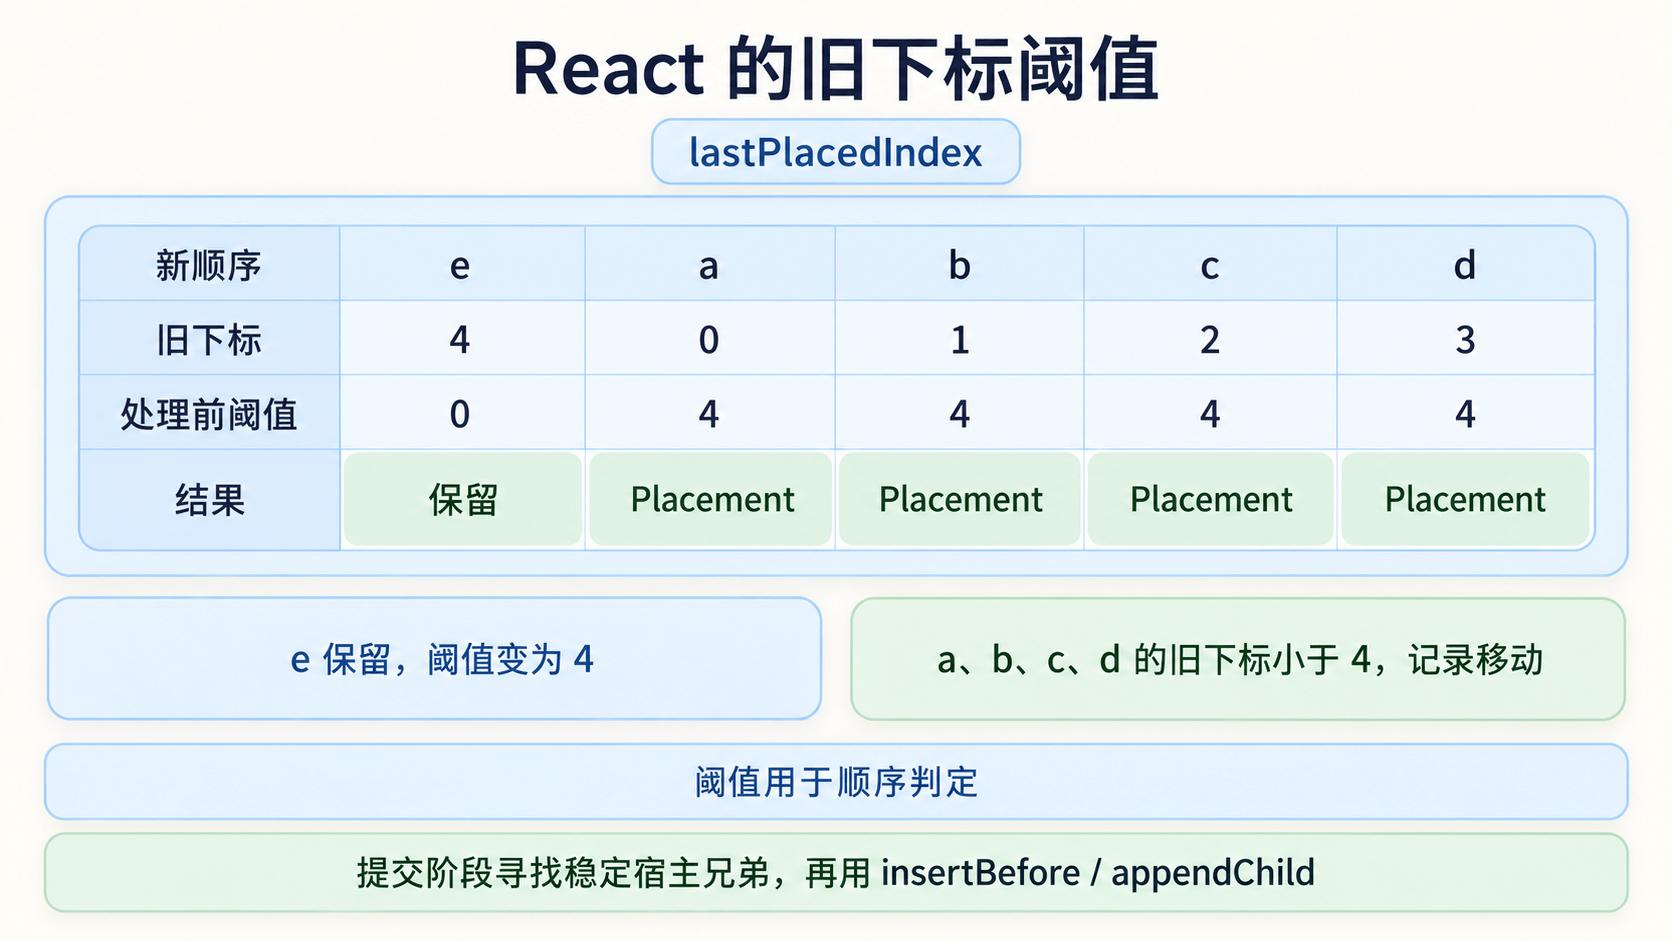
在这组普通 DOM 孩子的提交中,把 a、b、c、d 依次放到末尾,原来的 e 就留在最前面。目标顺序正确,但用了四次移动。
反过来,旧 [a, b, c, d, e] 变成新 [b, c, d, e, a] 时,旧下标序列是 [1, 2, 3, 4, 0]。前四项依次提高阈值,只有最后的 a 低于阈值,需要移动一次。
这种策略会保留向前扫描时遇到的递增旧下标,但没有回头寻找最长的递增选择。[4] 本身是一条递增子序列,只是它没有 [0, 1, 2, 3] 长;这正是它和 LIS 策略在尾移头场景中的差别。
「只右移」只能作为受限直觉
React 提交阶段通过 getHostSibling 与 insertOrAppendPlacementNode寻找合适的稳定宿主兄弟,再调用插入或追加操作。实际实现使用的是锚点关系,不能把它写成所有 DOM 节点都只会向右移动的物理限制。
当删除、新增、Fragment、组件子树或 Portal 参与更新时,逻辑位置和实际宿主节点位置的关系还会继续变化。用「保留已接受的旧下标顺序,其余项记录 Placement」解释算法,可以覆盖更多情况。
一个 Fiber 的 Placement 可能使多个宿主后代被插入。提交阶段寻找稳定宿主兄弟也需要额外遍历。因此「数组孩子的匹配扫描通常线性」不能直接扩大成「完整 React 更新严格 O(n),每个 Placement 恰好调用一次 DOM API」。
同一批案例能说明哪些差异
把纯重排放在同一个模型里,差异更容易比较。这里的数字来自对应策略的判断与教学模型验证,不是框架耗时基准。
旧列表均为 [a,b,c,d,e] |
React | Vue 2 | Vue 3 | 理论最少移动 |
|---|---|---|---|---|
[e,a,b,c,d] |
4 | 1 | 1 | 1 |
[b,c,d,e,a] |
1 | 1 | 1 | 1 |
[b,d,a,c,e] |
2 | 2 | 2 | 2 |
[e,d,c,b,a] |
4 | 4 | 4 | 4 |
框架教学模型的完整 TypeScript 源码可以在下面逐文件查看。关键身份前提集中在入口,快照只是为了观察过程;数组的 indexOf、splice 和逐步复制不能用于推导真实框架的时间复杂度。
LeetCode 300:从求长度到还原具体序列
LeetCode 300「最长递增子序列」给定一个整数数组,要求返回严格递增子序列的最大长度。Diff 还多了一项要求:知道究竟保留哪些逻辑项,所以需要从「长度」继续走到「具体下标」。
例如 [10, 9, 2, 5, 3, 7, 101, 18] 的答案是 4,可以选 [2, 3, 7, 18]。递增子序列不需要连续,重复数字也不能扩展严格递增的长度;[2, 2, 2] 的答案是 1。
动态规划先给出一个容易验证的解
定义 dp[i] 为以第 i 个元素结尾的最长严格递增子序列长度。只要前面的 nums[j] < nums[i],就可以把 nums[i] 接在那条序列后面。
// 算法示意:dp[i] 表示以 nums[i] 结尾的最大长度。
const dp = nums.map(() => 1);
for (let i = 0; i < nums.length; i++) {
  for (let j = 0; j < i; j++) {
    if (nums[j] < nums[i]) dp[i] = Math.max(dp[i], dp[j] + 1);
  }
}
const answer = Math.max(0, ...dp);
每个位置检查此前全部位置,时间复杂度为 O(n²),辅助空间为 O(n)。最后的 0 覆盖空数组;正式题面的输入约束可以更严格,工具函数仍可以自然处理空输入。
这个解法直接对应「以谁结尾」,也适合作为小输入的独立正确性基线。要加速,就要减少每次查找可以接在哪些前驱之后的工作。
同样长度的序列,结尾越小越容易继续接
假设当前已经找到两条长度为 3 的递增子序列,一条结尾是 8,一条结尾是 5。后来出现 6 时,只有结尾为 5 的那条能继续接;后来出现 9 时,两条都能接。对于未来可扩展性,较小的结尾不会更差。
于是维护 tails:tails[k] 表示已经处理的前缀里,长度为 k + 1 的递增子序列所能取得的最小结尾值。每读到一个新值 x,找到第一个大于等于 x 的位置并替换;找不到就追加。
这些最小结尾值按长度递增,可以通过二分定位。标准解中的核心循环如下,完整可复制的 TypeScript 函数在本节末尾的源码区。
最小结尾为什么递增?从一条长度为
k + 2、结尾最小的递增子序列里去掉最后一项,就得到长度为k + 1、结尾更小的候选。因此长度k + 1的最小结尾还会小于长度k + 2的最小结尾,这保证了二分所依赖的有序性。
// dom-diff-lab/copy/length-of-lis.ts:5-12(节选)
let left = 0;
let right = tails.length;
while (left < right) {
  const middle = left + Math.floor((right - left) / 2);
  if (tails[middle] < value) left = middle + 1;
  else right = middle;
}
tails[left] = value;
这里寻找的是 lower bound,即第一个 >= value 的位置。相等的值替换同一个长度的结尾,不会额外增加长度。若改成找第一个 > value 的位置,求的就会变成允许相等的最长非递减子序列,问题已经变化。
对所有长度保留最小结尾,不等于只保留一条全局看起来最小的序列。每个长度都需要一个候选;它们分别回答「如果下一步想接出这个长度,当前最容易继续的结尾是什么」。
二分替换为什么不会丢掉正确答案
设 x 被写到 tails[p]。当 p > 0 时,前一个位置的结尾严格小于 x,已经存在一条长度为 p 的递增子序列可以接上它,所以长度 p + 1 确实可达。p = 0 时,x 自己就是长度为 1 的序列。
如果原来的 tails[p] 已经存在,用不更大的 x 替换,只改善了这个长度的未来扩展条件;如果 p 位于数组末尾之外,就找到了一条比现有最长长度多 1 的序列。整个过程中,tails 的每个槽位都对应某个可达长度,最长长度也没有被较大的结尾阻挡。
因此最终 tails.length 就是答案。每项做一次二分,时间为 O(n log n),保存最多 n 个结尾,空间为 O(n)。
| 读入值 | 处理后的 tails | 变化 |
|---|---|---|
| 10 | [10] |
建立长度 1 |
| 9 | [9] |
降低长度 1 的结尾 |
| 2 | [2] |
再次降低结尾 |
| 5 | [2,5] |
建立长度 2 |
| 3 | [2,3] |
改善长度 2 的结尾 |
| 7 | [2,3,7] |
建立长度 3 |
| 101 | [2,3,7,101] |
建立长度 4 |
| 18 | [2,3,7,18] |
改善长度 4 的结尾 |
tails 不一定是原数组中的真实子序列
上面的例子恰好让最终 tails 看起来像正确序列,但输入 [2, 3, 1] 时,tails 会先后成为 [2]、[2, 3]、[1, 3]。最后的长度 2 正确,值 [1, 3] 却不能按这个顺序从原数组里取出来,因为 1 出现在 3 之后。
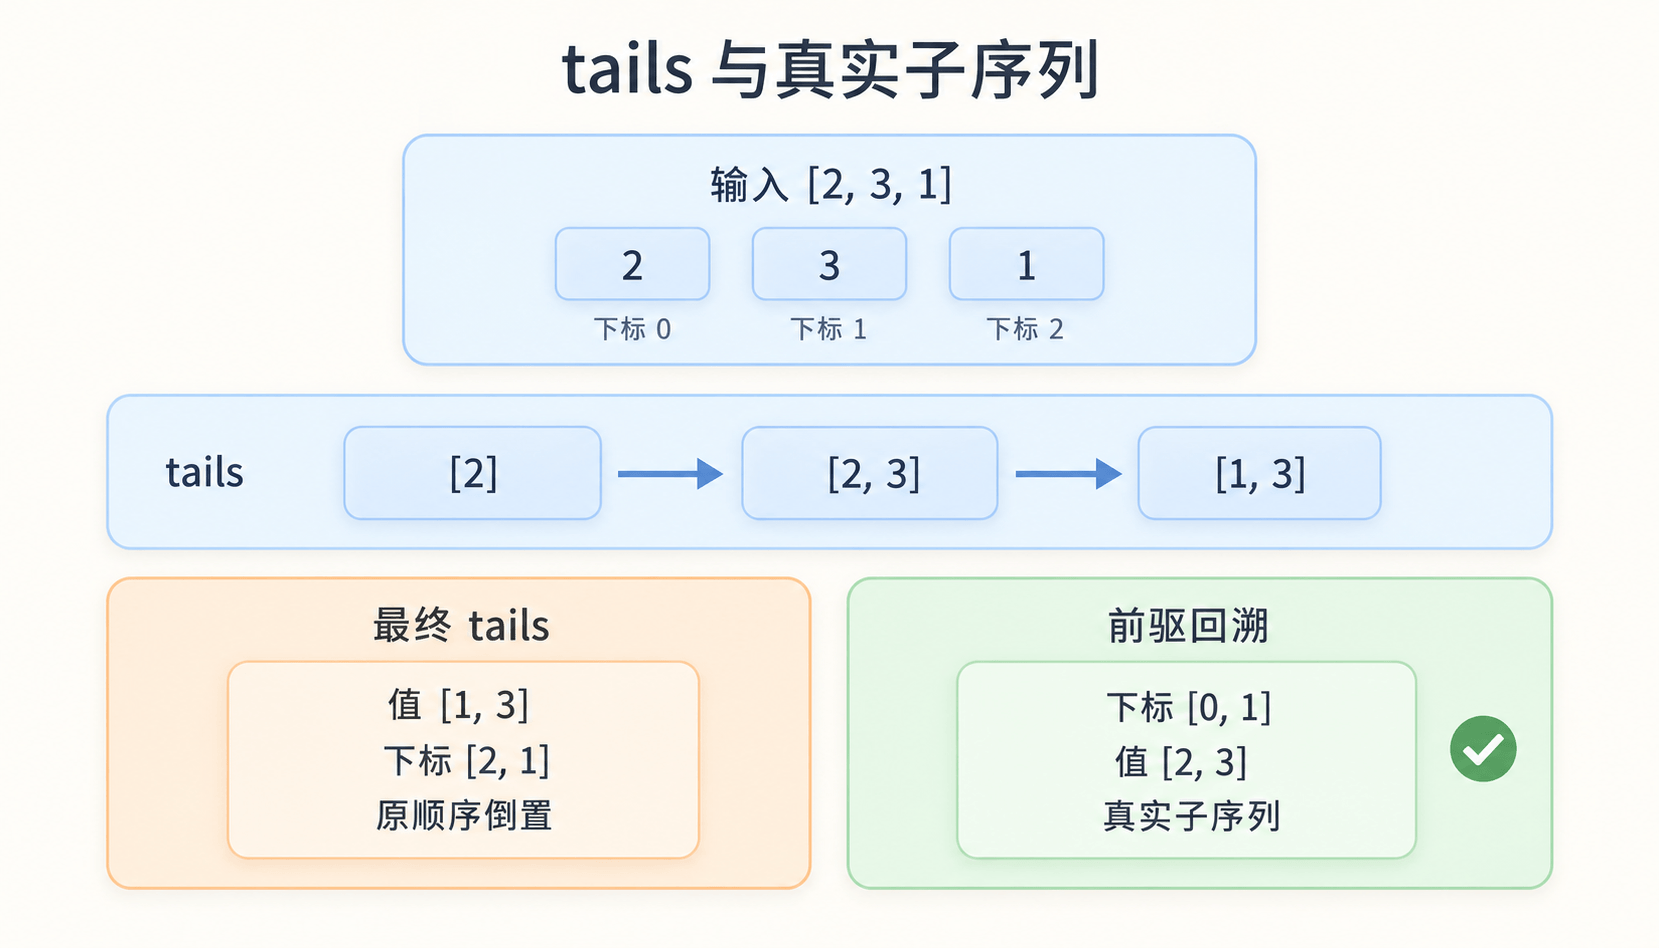
要还原真实序列,可以让 tails 保存各结尾在原数组中的下标,并在处理当前元素时记录前驱下标。写入长度 p + 1 的候选时,它的前驱就是当时长度 p 的候选结尾。
对 [2, 3, 1] 来说,3 的前驱在读到 3 时就记为下标 0。后来长度 1 的候选被 1 替换,也不会把 3 已经记录的前驱改掉。最后从最长候选的末尾沿前驱回溯,得到原下标 [0, 1],对应真实值 [2, 3]。
Vue 的
getSequence使用p = arr.slice()作为前驱记录的初始存储,再记录各候选对应的下标并回溯。复制数组本身不会把一个「乱序答案」修好;真正起作用的是处理时留下的前驱关系和最后的链式回溯。LIS 可能不唯一,找到其中一条最长的就足以达到上述单项移动下界。
逐步观察结尾、下标和前驱
演示默认使用 [2, 3, 1],最后一步单独执行回溯。可以换成经典题面,也可以选择 Vue 中段的 [5, 4, 3, 0],观察跳过新增标记的结果。
普通 LIS 里的 0 是合法数字,例如
[-2, 0, 1]的长度为 3。只有 Vue 的「旧下标加一」映射把 0 预留给新增项,才需要跳过它。演示中的复选框默认关闭,选择 Vue 映射案例时才开启;不能直接把 Vue 专用的忽略 0 规则复制到 LeetCode 标准答案中。
下面的 lengthOfLIS 是标准长度答案,lisIndices 返回一条真实 LIS 的原数组下标。traceLIS 额外保存逐步快照以供教学,因此它的空间成本高于只返回答案的函数。
源码包中的测试用 O(n²) 动态规划作为独立基线,穷举短数组中的重复值、下降序列、负数和 0,再检查回溯下标和值都严格递增。Diff 模型还覆盖了 5 项列表的全部 120 个排列,以及交错增删的有序子集组合,验证 Vue 3 模型的移动数符合 r - L。
哪些版本变化影响了这套解释
截至 2026 年 10 月 14 日,本文核对的稳定版为 React 19.3.0、Vue 3.5.44。Vue 2 的最终官方版本为 2.7.16,已于 2023 年底结束官方维护;存量项目的维护边界见 Vue 2 EOL 说明。具体标签用于定位证据,理解算法主要抓下面几处变化。
React:Fiber 改变渲染架构,列表仍采用旧下标阈值
React 15 的 Stack reconciler 已经在 ReactMultiChild里用 lastIndex 与 _mountIndex 判断移动。React 16 的 Fiber 改造改变了工作记录与执行架构,用 lastPlacedIndex 与 Placement 表达放置工作;当前 ReactChildFiber仍可见这类旧下标阈值策略。
因此,从 Stack 到 Fiber 是重要的架构变化,但普通 keyed 列表没有因此变成 Vue 3 式的 LIS 最少移动规划。前面的重排例子仍需要按 Placement 判定解释。
并发渲染改变工作如何被中断、组织和提交;React Compiler通过自动记忆化减少不必要的计算与渲染。它们影响更新成本,但不能据此推导出孩子匹配已经换成 LIS。
Vue 2 → Vue 3:列表策略与编译器协作都发生变化
Vue 2 的四端比较,在 Vue 3 普通 keyed 路径里变成了前后缀同步、新中段 key 索引与按需 LIS。这个主线在 Vue 3.0中已经存在,当前稳定版仍沿用这一类策略。Vue 2.7 虽然引入了 Composition API 等能力,其孩子更新主线仍然属于 Vue 2。
Vue 3 还增强了编译器与运行时的协作。编译器可以识别静态内容、标记动态属性,并通过 Block 收集动态后代,让运行时少检查一些无需变化的内容。这也会影响前面讲的属性与子树更新,说明三者的差异并不只存在于列表里。
Patch flag 是编译器交给运行时的变化提示,例如某个节点只需要关注动态文本或特定属性。Block 用来记录需要动态更新的后代,帮助运行时避开大段静态结构。它们减少进入具体 patch 的工作,不等于每次更新都需要计算 LIS。
Vapor:需要单独理解的编译与运行时路径
查证时 Vue 3.6.0-rc.11仍是候选发布版。其中 Vapor 的编译与运行时组织直接面向 DOM 块和响应式更新,普通 VNode 树比较的讲法不能整体搬过去。
减少通用虚拟 DOM 工作,也不会让可重排列表的身份匹配问题消失。该 RC 的 createFor仍会建立 key 索引、记录旧位置加一,由 planMoves 规划需要移动的块,必要时调用 getSequence,随后逆序应用挂载和移动。Vapor 的块、effect 和空块锚点另有处理,本文三个平面列表模型没有模拟其完整实现。
版本核对记录保留了查证日期与源码标签,便于后续重新核对稳定版和实验路径。
其他框架也在解决身份与重排,但方法不同
把 DOM Diff 当成所有数据驱动框架统一的一套流程,会忽略编译器和细粒度响应式路线。不同实现可以减少通用树比较,列表变化时仍然需要判断旧项、新项与宿主范围之间的对应关系。
Snabbdom 保留了四端匹配的清晰结构
Snabbdom 3.6.4 的 updateChildren仍然能看到头头、尾尾、头尾、尾头比较,失败后通过旧 key 索引寻找节点。它与 Vue 2 的主线相近,适合对照阅读端点策略。
不过,这里相近的是孩子匹配与放置结构。节点相等条件、模块 hooks、属性更新和框架组件机制仍各有实现,不能把整个渲染器视为同一份代码。
Preact 11 已增加按需 LIS 规划
Preact 有独立的虚拟 DOM 实现,React API 兼容并不要求它复制 React Fiber 的孩子算法。本文对照的 10.27.2 children.js使用位置偏移 skew 与向两侧搜索的 findMatchingIndex,在匹配后决定插入。
当前稳定的 Preact 11.0.1仍使用这类匹配线索,但 constructNewChildrenArray在检测到重排后,已经会对匹配的旧下标计算 LIS,让该序列上的项保留,其余项获得 INSERT_VNODE 标记。
skew是对候选旧位置的偏移修正,帮助前插、删除等模式继续在附近匹配。Preact 11 的 LIS 优化发生在匹配之后;findMatchingIndex在不利输入下仍可能逐项向外搜索,所以不能仅凭新增了O(n log n)的 LIS 步骤,就断言整个孩子匹配最坏复杂度也变成O(n log n)。
这个版本对比至少说明:讨论其他框架时,必须带上标签。「某个框架不用 LIS」这样的结论可能在升级后失效,而 API 风格看起来仍然很接近。
Svelte 5 的 keyed each 更新 effect 和 DOM 范围
Svelte 通过编译把模板转换成更新代码,通常不需要每次生成并比较整棵通用 VNode 树。对 {#each items as item (item.id)}这样的 keyed 列表,运行时仍要根据 key 复用列表项、更新数据并处理顺序。
Svelte 5.57.2 的 each 实现保存 key 到列表项的 Map,并通过 effect 链、matched 和 stashed 等结构推进重排。遇到已扫描过的项时,代码会比较组的长度,决定移动后面的项到前面,还是把较早的项放到后面。
Effect 在这里承载一段响应式工作及其生成的 DOM 范围。一条列表项可能包含多个节点,移动的对象也就可能是一个范围。Svelte 5 的这条路径不适合直接套成 React 的
lastPlacedIndex,也不适合仅凭结果相同就说它采用 Vue 3 的同一套 LIS 实现。
Solid 把普通表达式更新和列表复用分开
Solid 的细粒度响应式把依赖变化关联到具体更新工作,常规 DOM 更新不依赖反复比较整棵通用虚拟 DOM 树。动态列表仍有专门的复用机制。
<For>围绕项身份映射和复用,<Index> 则保留位置身份、让各位置的值更新。业务身份稳定和位置稳定分别适合不同场景。重建一批内容相同但引用不同的对象,也可能改变以对象身份为依据的复用结果。
| 实现或路径 | 主要观察入口 | 讨论时要保留的条件 |
|---|---|---|
| React Fiber 普通数组孩子 | 前向匹配、Map、Placement 阈值 | 不保证最少逻辑项移动 |
| Vue 2 | 四端匹配、旧 key 索引 | 无 key 兜底与 keyed 查表不同 |
| Vue 3 普通 keyed children | 前后同步、新 key 索引、按需 LIS | 无 key、组件、Fragment 另有处理 |
| Snabbdom | 四端匹配 | 节点判断和 hooks 有自己的规则 |
| Preact 11 | 偏移匹配、局部搜索、按需 LIS | 匹配搜索成本与 LIS 成本分开 |
| Svelte 5 | 编译结果、keyed each、effect 范围重排 | 常规更新不依赖整棵 VNode Diff |
| Solid 1.x | 响应式依赖、For / Index |
项身份与位置身份分别设计 |
比较性能与回答面试题时,保留这些边界
Vue 3 在本文的等成本单项重排模型中,可以通过 LIS 达到最少既有项移动;React 的阈值策略在某些排列里会产生更多 Placement。这是可以由算法解释的差异,但不能据此给 React 和 Vue 的整页性能排出固定高低。
实际页面还要支付组件计算、依赖追踪、VNode 或 element 分配、属性 patch、宿主锚点搜索、样式计算、布局和绘制的成本。列表里主要是改文本,还是反复大幅重排;单项是一个 li,还是一组复杂组件;更新是否被记忆化或编译器跳过,都会影响结果。
真要做性能实验,应固定框架版本与构建模式,使用同样的节点结构、数据规模和交互,再分别观察匹配时间、DOM 操作、提交耗时与浏览器渲染时间。本文的逐步快照会主动分配数组,不能拿演示本身的耗时充当框架基准。
回到面试题,可以按一条完整的因果线回答:
框架先根据父级作用域、节点类型和 key 建立身份。身份兼容的普通元素可以复用 DOM,更新或清除属性,并继续处理内容;同类型、同 key 的组件可以保留本地状态,更新输入与渲染子树。类型或 key 不兼容时,卸载旧身份、挂载新身份;组件自身与其根 DOM 的身份需要分层判断。
对普通 keyed 列表,Vue 2 用四端比较加旧 key 索引;Vue 3 普通 keyed 路径先同步前后缀,再给未知中段建立新 key 索引,记录旧下标加一,检测到重排时计算 LIS,逆序挂载或移动。React Fiber 普通数组路径向前匹配,必要时建立剩余旧项 Map,并用
lastPlacedIndex判断 Placement;截至本文核读的 19.3.0,这条规则仍然存在。LIS 保留的是旧顺序与新顺序中相对次序一致的最大集合。在每项移动成本相同的模型中,保留
L项就只需移动其余r - L项。不过列表移动最少只是一项优化指标,完整更新性能还要考虑组件、编译器、调度和浏览器成本。
真正需要记住的,是身份、搜索范围、移动代价和版本路径之间的关系。换一个排列、换一种 key,或者换成编译器直接更新 DOM 的框架,仍然能沿着这些问题判断它会怎样更新。