让 Codex 调用普通 ChatGPT:一次本地代理链路验证
看到网罗灯下黑的《不加钱,把 ChatGPT 几乎无限的网页额度当 Codex 用》后,我想验证另一种接法:继续在本地 Codex 里读文件、执行命令、改代码,把模型请求转给普通 ChatGPT。
这样既不用把工作搬到网页,也能保留 Codex 的本地执行环境。CC Switch 可以帮忙改配置,不过我更想知道,能不能直接启动一个本地服务完成转发。
2026 年 10 月 5 日,Codex 通过这条链路读取了测试文件里的随机值,调用补丁工具把它写进新文件,再把执行结果送回普通 ChatGPT,最后结束任务。中间需要修改适配服务,原版组合没有直接跑通;成功后的一次复测也出现过空响应。
这里确认的是普通 Chat 上游与 Codex 本地工具之间的连通性。没有测量账户额度扣减,也没有验证桌面 App 全局切换后的行为。原文标题里的「几乎无限」不能作为这次实验的结论。
模型换到 Chat,本地工具仍由 Codex 执行
一个 Codex 任务至少包含两部分:模型根据上下文决定下一步,本地执行环境负责把这一步做出来。模型输出「读取文件」的工具调用,真正打开文件的是本地程序;执行结果还要发回模型,供它继续判断。
因此,把模型请求转给普通 ChatGPT,并不要求另外装一套 WebCodex 来提供文件和终端能力。只要适配服务能把工具定义、调用参数和执行结果来回转换,原来的 Codex 执行环境就能继续工作。
WebCodex 对应另一种需求。它让 ChatGPT 等云端客户端通过 MCP 和 HTTPS 连接本地开发环境,入口在云端聊天界面。项目 README展示的方向是「云端客户端 → WebCodex → 本机仓库和工具」。这次实验的入口在本地 Codex,转出去的是模型请求。
这也解释了「加一个全局代理」为什么还不够。HTTP、SOCKS 或系统代理通常只改变网络请求经过哪里;要从 Codex 上游换到普通 Chat 上游,还要换认证方式,并转换模型接口协议。CC Switch 在这里可以承担配置管理,实际转换仍由本地服务完成。
桌面 App 左上角的 Codex、ChatGPT,以及 ChatGPT 下的「聊天」「工作」,可以用来识别产品入口,却不能单凭界面名称推导这次代理请求的计费归属。判断转发走向要看实际请求发到哪里,额度是否扣减则需要另行测量。
实际使用了两层适配
最终跑通的请求链路如下。两层适配都在本机,服务仅监听 127.0.0.1。
Codex CLI 0.160.0
    ↓ Responses API
OpenCodex 2.77.0,自定义 openai-chat provider
    ↓ Chat Completions
修改后的 chat2api
    ↓ ChatGPT 网页会话协议
chatgpt.com/backend-api/f/conversation
Codex 需要 Responses API 的请求和流式事件,而 chat2api 暴露的是 Chat Completions 接口。OpenCodex 补上两者之间的转换,包括工具调用、工具结果和流结束事件。官方的网关兼容要求也把 Responses 流、历史续传和完整工具往返列为需要验证的内容;能返回一段聊天文本,只能证明其中一部分。
这里使用的是 OpenCodex 的自定义 provider。它自带的 ChatGPT 登录路线会请求 /backend-api/codex,与这次要验证的普通 Chat 上游不同,可以在 provider 注册源码中核对。工具兼容处理另见 custom-tool-compat.ts。
chat2api 又做了一层转换。它把外部工具定义写进提示词,要求网页模型以 XML 文本输出调用,然后将 XML 解析为 Chat Completions 的 tool_calls。这属于提示词模拟的工具协议,不能当成 ChatGPT 网页提供了原生的第三方函数调用接口。实验使用的 chat2api 基础提交固定在 dbf6bf39686348449c25de3b6131ca733f448deb。
一次工具往返中,ChatGPT 先输出调用文本,两层适配把它还原成 Codex 能识别的工具事件。Codex 在本地执行,再把结果按相反方向送回 ChatGPT。只有模型看到了真实执行结果,才算完成这个循环。
实验使用了独立的 CODEX_HOME 和 OPENCODEX_HOME,没有修改日常使用的全局 Codex 配置。上游模型填的是 auto,网页请求的 thinking_effort 是 standard;这两个值也不能证明它保留了桌面模型选择器中某个具体型号和「极高」档位。
认证也要单独准备。Edge 中已经登录 ChatGPT,不代表本地服务会自动继承登录态;这次由本人将账号凭据填入本地配置页。Codex 连接回环服务用的本地访问密钥,与 chat2api 请求网页上游所需的账号凭据,是两层不同的认证。
文本能返回之后,还有几处兼容问题
验证先用了模拟 Chat Completions 上游,确认 Responses 流和本地工具能够接起来;随后在已登录的 Edge 中确认普通 Chat 网页能回复。模拟服务成功和网页手动回复成功,都还没有证明自动转发链路可用。换成真实 chat2api 后,失败才落到了具体的接口和处理分支上。
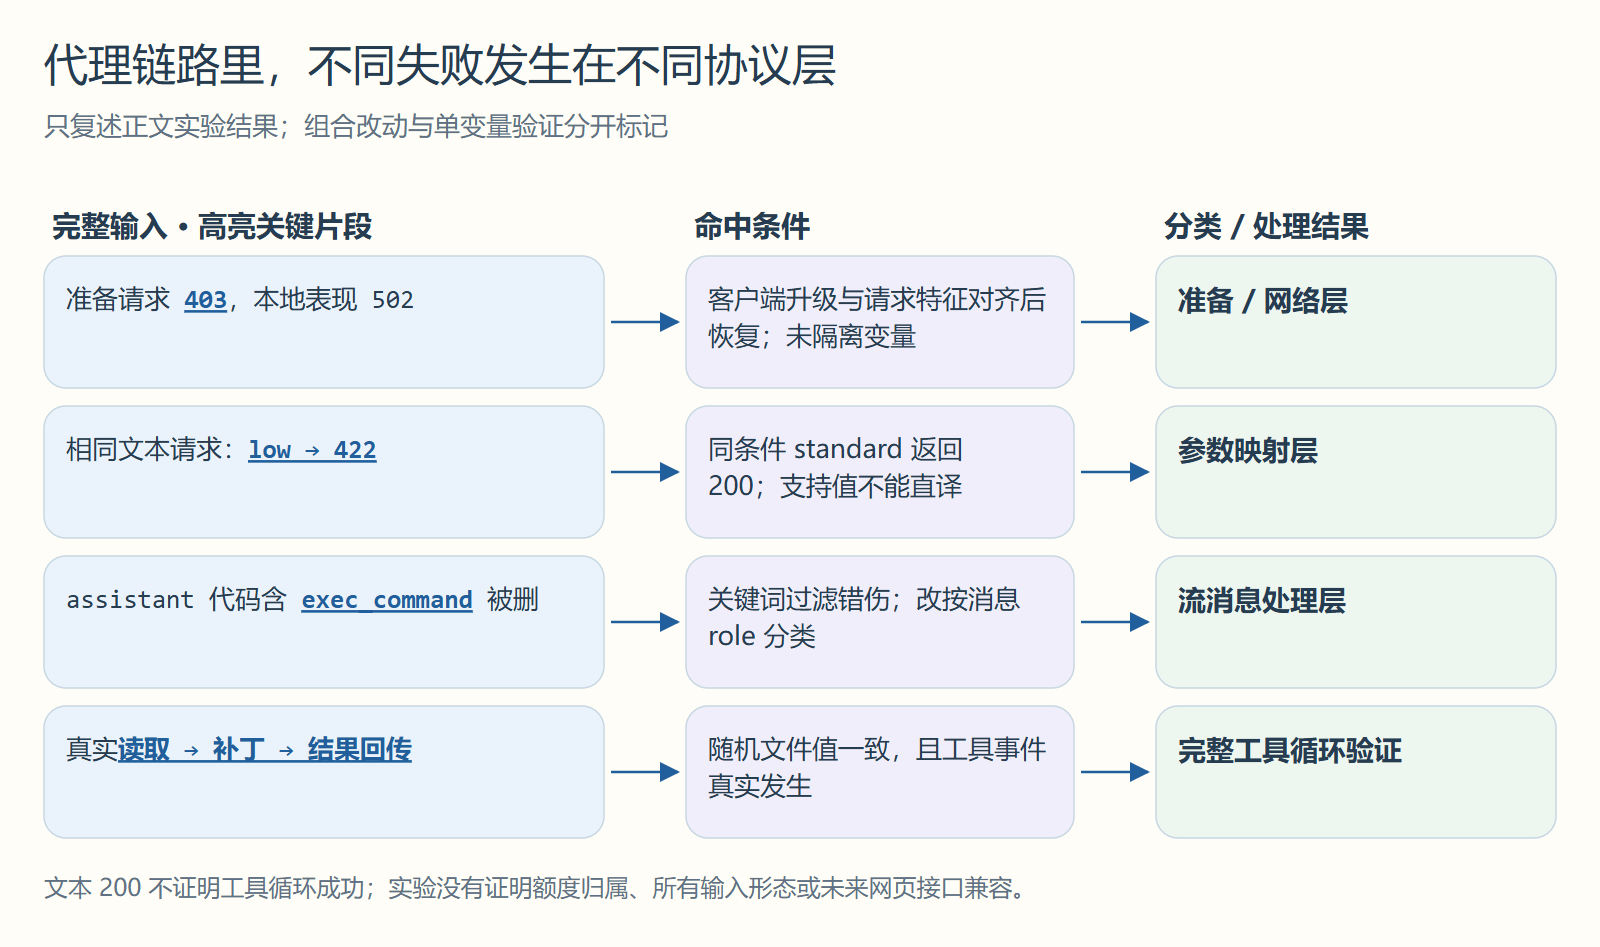
403 出现在网页会话的准备请求
最初的失败点是 /backend-api/sentinel/chat-requirements/prepare,上游返回了 Cloudflare 的 403 页面,本地表现为 502。此时还没有进入正常的模型回复流。
源码中的网络客户端使用 tls-client v1.7.5 和 Chrome 124 的 TLS profile,HTTP 请求头里的 User-Agent、sec-ch-ua 却写着 Chrome 148。后来把依赖更新到 v1.16.0,并将 profile 与这两项请求头统一到 Chrome 146,真实文本请求才返回 200。
这个结果对应的是客户端升级和请求特征对齐后的组合。没有单独隔离每个变量,所以不能把 403 唯一归因于版本不一致,也不能承诺相同修改在其他账号、网络或未来的网页接口上都有效。
reasoning 参数映射后,网页返回 422
进入模型请求后,又遇到了 422 Invalid conversation body。控制变量测试给出了更明确的结果。
| 请求条件 | 网页 thinking_effort | 结果 |
|---|---|---|
| 完整文本请求,移除工具定义 | low |
422 |
| 同一完整文本请求 | standard |
200 |
| 最小文本请求 | low |
422 |
当时 Codex 的 reasoning_effort 是 low,chat2api 的 normalizeThinkingEffort 将它直接映射为网页的 low。把隔离配置中的 model_reasoning_effort 改为 medium 后,它会被映射为 standard,请求得以继续。
这次失败说明,两个接口都叫「推理档位」,不代表枚举值和支持条件可以直接对应。medium → standard 是当前适配代码的映射,不是对所有模型通用的配置建议。
网页模型把外部工具当成了自己的工具
请求返回 200 后,模型仍然没有调用本地执行器。它尝试在自己的工具环境里寻找 exec、apply_patch,随后回复这些工具不可用。
适配层提供的是文本协议,工具实际存在于 Codex。模型需要知道,它应该输出调用文本,等待外部程序执行,而不是在 ChatGPT 自己的工具菜单里查找同名工具。为此做了三项配套调整。
- 工具提示词明确说明外部执行器的职责,要求把 XML 作为普通回复文本输出。
- 注入的工具提示词从
system消息改为排在历史前面的user消息。 - 对没有
conversation_id的多条纯文本历史,将角色标签和内容合并为一个网页user回合,让工具约定、任务和此前结果一并进入输入。
这组修改后,模型开始输出外部工具调用。实验没有逐项隔离它们,不能据此认定只改消息角色就足够,也不能推导网页接口普遍不支持多消息历史。
历史合并还改变了语义:文本里的 system 标签已经不是接口层的系统角色。这种处理只用于当前无会话 ID 的纯文本路径,遇到非文本内容会保留原结构。图片输入、现有网页会话续接和其他复杂工具场景没有在这次实验里验证。
流过滤器误删了工具代码
工具调用终于出现后,第一次传给 Codex 的 JavaScript 又被截断。源码里有这样一个过滤条件,下面只摘出相关分支。
// app/service/completions.go,原 shouldSkipInternalToolOutput 的部分逻辑。
if strings.Contains(payload, "exec_command") {
    return true
}
它原本用于过滤网页原生工具的执行信息,却会删掉任何包含 exec_command 的流片段。而 Codex 的 Code Mode 工具调用正好包含 await tools.exec_command(...):模型先输出一段 JavaScript,本地执行器运行这段代码,再调用真正的命令工具。
修复后的过滤器解析消息结构,根据 message.author.role == "tool" 判断网页原生工具结果,并兼容 v.message 包装。assistant 回复中的代码和普通追加文本不再因为某个关键词被丢弃。
这处问题可以用本地回归测试稳定复现,不需要请求 ChatGPT。测试既检查完整 assistant 消息,也检查只含 exec_command 的追加片段,并确认网页原生 tool 消息仍会被过滤。
用随机文件检查整个工具循环
最终测试没有只让模型回答一个固定字符串。启动任务前,验证器生成随机值并写入 fixture.txt,删除可能残留的输出文件;提示词只要求 Codex 读取文件,并用补丁工具把读到的值写进新文件。
随机值不在任务提示词里,所以模型需要读取本地文件才能得到它。清理旧输出则防止上一次成功的文件让新一轮测试误判。
验收同时检查 Codex 进程、工具事件、文件内容和回传请求:命令工具实际执行,补丁工具实际执行,新文件与输入值一致,后续模型请求包含工具结果,最终进程正常退出。
最近一次成功记录中,普通 Chat 上游的三次 /backend-api/f/conversation 请求都返回 200,两次后续请求携带了工具结果。这次的模型请求与本地执行之间没有人工复制步骤。
{
  "exitCode": 0,
  "fullChainPassed": true,
  "fileMatches": true,
  "toolExecution": true,
  "patchExecution": true,
  "toolResultsReturned": true
}
成功之后的一次复测仍出现了 HTTP 200、回复为空、输出文件未生成的情况。源码里有一条分支:检测到工具协议,但没有解析出有效调用或参数校验失败时,直接发送结束事件,缓冲的回复文本被丢弃。那次失败没有保留足够的原始文本,无法进一步确认具体是哪项格式错误。
修改后,这条分支会先返回被拒绝的原始回复,再结束流,方便识别协议错误;它没有增加自动重试,也没有保证模型下次一定输出合法 XML。补上对应回归测试后再测,真实工具循环重新通过。这个波动需要和成功结果一起保留,不能把最近一次通过写成长期稳定。
补丁固定在这次验证的源码版本上
配套源码保留了 chat2api 的兼容补丁、三个 Go 回归测试,以及删去个人路径和完整工具内容的验证记录。补丁包含依赖更新和请求路径、状态码诊断,诊断仅在 CHAT2API_VALIDATION_TRACE=1 时开启;源码展示不会启动服务或调用 ChatGPT。
这些文件用于复核和继续实验。它们不包含登录凭据、OpenCodex 安装环境、Codex 模型目录或完整服务启动器,因此不能当成下载后就能接管桌面 App 的安装包。
如果交给 Coding Agent 迁移,可以使用这个入口。
读取 https://shengsheng.fun/files/codex-chatgpt-web-proxy-validation/kits/chat-web-bridge-compat/ 下的 README.md、AGENT_PROMPT.md 和 FILES.json。
按 FILES.json 逐文件读取,核对 chat2api 基础提交,在独立 checkout 中检查并应用 copy/chat2api-compat.patch,运行 Go 回归测试。
需要真实上游验证时,另行配置本地服务;凭据由我手动填入本地配置页,不写进仓库或日志。应用补丁与运行测试的命令见工具包 README,要求先切到指定基础提交。它们验证的是源码兼容处理;真实上游还需要账号登录态和两层适配服务,必须再做文件读写与结果回传测试。
离日常替换还差桌面接入和稳定性验证
不装 CC Switch 时,可以启动本地 Responses 适配服务,再把 Codex 的自定义 provider 指向它。官方的网关连接配置提供了 model_provider、base_url 和 wire_api = "responses" 的配置方式;自定义模型别名还需要匹配的模型目录。这次为了让客户端采用相应工具格式,单独准备了实验目录,目录元数据只影响客户端行为,上游模型实际支持哪些能力还需要实测。
桌面 App 是否读取同一配置、切换后已有对话如何处理、长期任务和上下文压缩能否继续工作,都需要单独验证。这次只运行了隔离的 Codex CLI,当前桌面对话没有通过这条代理切换上游。修改系统代理,也不能让已经运行的助手自行改变自己的计费来源。
普通 Chat 的网页登录态能够让本地服务请求普通 Chat 上游,但它不是公开、稳定的 API 契约。凭据过期、网页协议更新和工具 XML 输出波动,都会影响这条路线。实验中凭据只由本人填入本地页面,服务监听回环地址,测试结束后停止临时服务。
如果只需要在网页中使用本地工具,WebCodex 的接法更贴近那个入口;如果希望继续用 Codex 本地任务环境,就需要这类模型协议适配。对后一个目标,我会先保持隔离配置,用真实文件任务连续复测,再决定是否接入日常桌面工作流。能读写一次文件,已经证明方向可行;要承担长时间编码任务,还需要更多实测。