刷新后为什么会自动滚到下面:浏览器滚动恢复和无限流
这次遇到的现象很具体:知乎首页如果已经往下滚过,刷新以后页面会停在靠下的位置,底部哨兵又被触发,于是第二页内容跟着加载出来。页面在顶部刷新时不会这样。
一种可能的机制是浏览器原生滚动恢复:浏览器会记住当前页面的滚动位置,并在刷新、后退、前进时尝试恢复。对文章页和普通列表页,刷新后回到旧位置通常正合适;放到无限流页面上,就可能造成「刷新以后自动滚到底部」的错觉。
这个解释与观察到的现象一致,但本文没有记录知乎页面完整的滚动调用链,不能据此排除站点自己的恢复逻辑。下面分析的是原生恢复与无限流如何互相影响,以及能怎样验证和限制它。
浏览器保存的不只是 URL
MDN 对 history.scrollRestoration 的说明列出了两种模式:默认值是 auto,浏览器会恢复用户之前滚到的位置;设成 manual 后,页面位置不再由浏览器自动恢复。
更底层一点看,HTML Standard 的会话历史恢复流程里,浏览器保存的状态包括可恢复滚动区域的 scroll position data,也可能包括表单字段这类 persisted user state。只要历史条目的 scroll restoration mode 是 auto,恢复流程就会尝试把滚动位置写回去。标准里还补了一句容易被忽略的话:浏览器「不恢复滚动位置」也不等于页面一定停在 (0, 0),应用如果想要某个位置,就应该自己设置。
刷新后停在原来的位置可以由浏览器完成,不意味着知乎或者插件一定调用了 scrollTo()。history.scrollRestoration = 'manual' 也不是「强制回顶部」的开关,它只是让浏览器别自动接管,页面仍然要明确设置自己想要的滚动位置。
Chrome Developers 在 2015 年介绍这个 API时,提到的痛点就是 History API 应用里的跳动:浏览器恢复滚动位置,但页面内容、转场、异步渲染又改变了布局,用户会看到位置突然跳走。知乎首页这次不是典型 SPA 路由切换,但现象相似:若恢复动作由浏览器完成,内容高度和加载节奏却由页面自己控制,两者就可能在时序上冲突。
为什么这事平时不显眼
如果所有页面刷新都会恢复滚动位置,为什么日常很少有人抱怨?
原因是多数静态页、文章页和普通列表页里,恢复滚动位置符合用户预期。读一篇长文读到一半,刷新以后仍然在中间,这通常是好事。问题只会在一些页面结构里被放大:
- 页面底部有无限流加载哨兵;
- 首屏内容高度依赖接口、图片、广告、实验位或登录态;
- 页面用虚拟列表、嵌套滚动容器或客户端渲染;
- 刷新后恢复到旧
scrollY时,当前内容还没长到旧高度,浏览器和页面逻辑会来回补偿。
网上其实早就有人讨论过。一个 2013 年的 Stack Overflow 问题问的就是 Chrome、Safari 刷新后记住滚动位置能不能关掉。评论里有人把「顶部插入新数据的大表格」作为反例,也有人直接提到使用无限滚动加载体验的页面会遇到这个意外问题。后来被接受度更高的答案,已经转向 history.scrollRestoration = 'manual'。
这个讨论很能说明问题:浏览器恢复滚动不是错误;错误感来自页面语义。对文章页来说,「回到刚才读的位置」很好。对无限流首页来说,「回到列表末尾」可能等于「立刻加载下一页」。
无限流把恢复位置变成了加载信号
无限流常见实现是监听滚动位置,或者用 IntersectionObserver 观察底部哨兵。只要哨兵进入视口,就拉下一页。
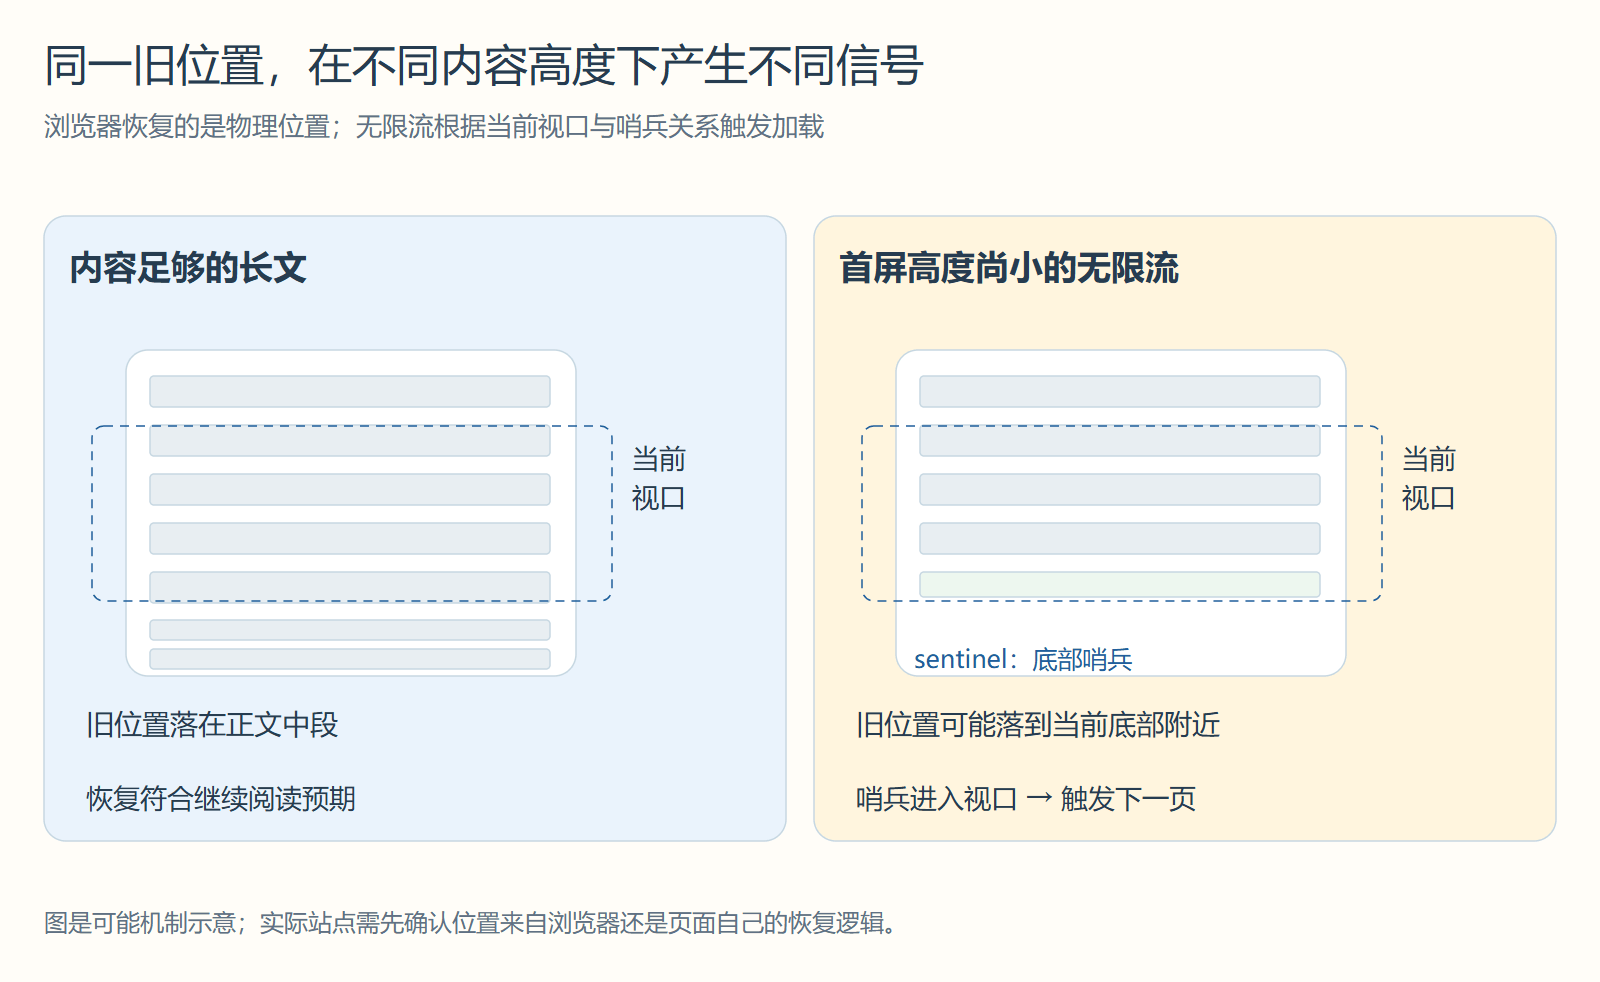
刷新后的恢复流程刚好会踩到这条线。浏览器记住的是一个像 scrollY = 5000 这样的物理位置,不知道这个位置在业务上代表什么。页面重新加载时,如果第一屏内容还没稳定,浏览器尝试恢复旧位置;一旦恢复后的视口接近底部,哨兵进入视口,列表就开始加载第二页。
如果这里的滚动由原生恢复触发,「刷新自动滚到了最后」可以拆成三步:
- 浏览器根据会话历史恢复旧滚动位置;
- 页面首屏内容高度还在变化,旧位置落在了当前内容底部附近;
- 无限流把「接近底部」解释成「用户想看下一页」。
浏览器不知道第二步和第三步的业务含义。它只是在做通用恢复。
主流 Router 都在处理同一类时序
前端框架和 Router 文档里,滚动恢复已经是一个专门问题,而不是一句 scrollTo(0, 0)。
Vue Router 的 scrollBehavior把滚动行为交给路由配置,后退 / 前进时会传入 savedPosition,也允许返回 Promise 来延迟滚动。文档里还有一条关键说明:只要配置了 scrollBehavior,Vue Router 会把 history.scrollRestoration 设成 manual,由 Router 自己计算和存储滚动位置;如果不想让 Router 计算,就不要配置,或者把它交回浏览器。
TanStack Router 的滚动恢复文档讲得更细:标准 HTML 页面天然有浏览器恢复,但 SPA 里常见三个麻烦,分别是 pushState 导航、异步渲染导致页面高度晚于导航出现、以及多个嵌套滚动容器。它的方案是监听滚动、按 key 缓存每个滚动区域的位置,并在导航成功后、DOM 绘制前恢复。
React Router 的 <ScrollRestoration />也是同一路线:它模拟浏览器的滚动恢复,并渲染一个内联脚本来避免滚动闪烁。这个「内联脚本」细节很重要,说明恢复位置不是越晚越好;越晚越容易被用户看到闪一下。
Next.js 的 <Link> 文档则把默认行为描述成接近浏览器前进 / 后退:能维持当前位置时维持,必要时滚到第一个可见 Page 元素;scroll={false} 或 router.push(..., { scroll: false }) 可以关闭它对导航滚动的管理。router.refresh() 的文档还特意说,刷新当前路由时会保留未受影响的浏览器状态,比如滚动位置。
这些资料合在一起看,结论比较稳定:滚动恢复本身是状态管理问题。页面越像「应用」,越需要自己接管;页面越像普通文档,越适合交给浏览器。
对浏览器插件来说,关键是时机
如果目标是改知乎首页这类第三方页面,浏览器插件能做的事情比站点自己少一些,但也不是只能在加载完以后硬滚回顶部。
更稳的入口是尽早把目标页面的恢复模式改成 manual。HTML Standard 在 History API 章节建议应用尽早设置,比如放在文档 <head> 里的第一个脚本,这样后续历史条目都能得到想要的 scroll restoration mode。插件没有办法真的把脚本塞进服务端 HTML 的第一个 <script>,但可以把一个很小的 content script 放到 document_start。
Chrome Extension 的 content scripts 文档里,run_at 默认是 document_idle;document_start 会在 DOM 构造前注入,更适合这种必须早于页面主体逻辑的设置。对已经存在的大型内容脚本,通常不要为了这一行逻辑把整包都提前到 document_start,而是拆一条非常小的早期脚本。
示意配置会像这样:
{
  "content_scripts": [
    {
      "matches": ["https://www.zhihu.com/*"],
      "js": ["content/early-scroll-restoration.js"],
      "run_at": "document_start"
    },
    {
      "matches": ["https://www.zhihu.com/*"],
      "js": ["content/index.js"],
      "run_at": "document_idle"
    }
  ]
}
早期脚本里只做范围很小的判断。比如只处理知乎首页的刷新,不碰问题页、回答页和后退 / 前进:
function getNavigationType() {
  const [entry] = performance.getEntriesByType('navigation') as PerformanceNavigationTiming[];
  return entry?.type;
}

function isZhihuHomeReload() {
  return location.hostname === 'www.zhihu.com'
    && location.pathname === '/'
    && getNavigationType() === 'reload';
}

if (isZhihuHomeReload() && 'scrollRestoration' in history) {
  history.scrollRestoration = 'manual';
  window.scrollTo(0, 0);
  requestAnimationFrame(() => window.scrollTo(0, 0));
}
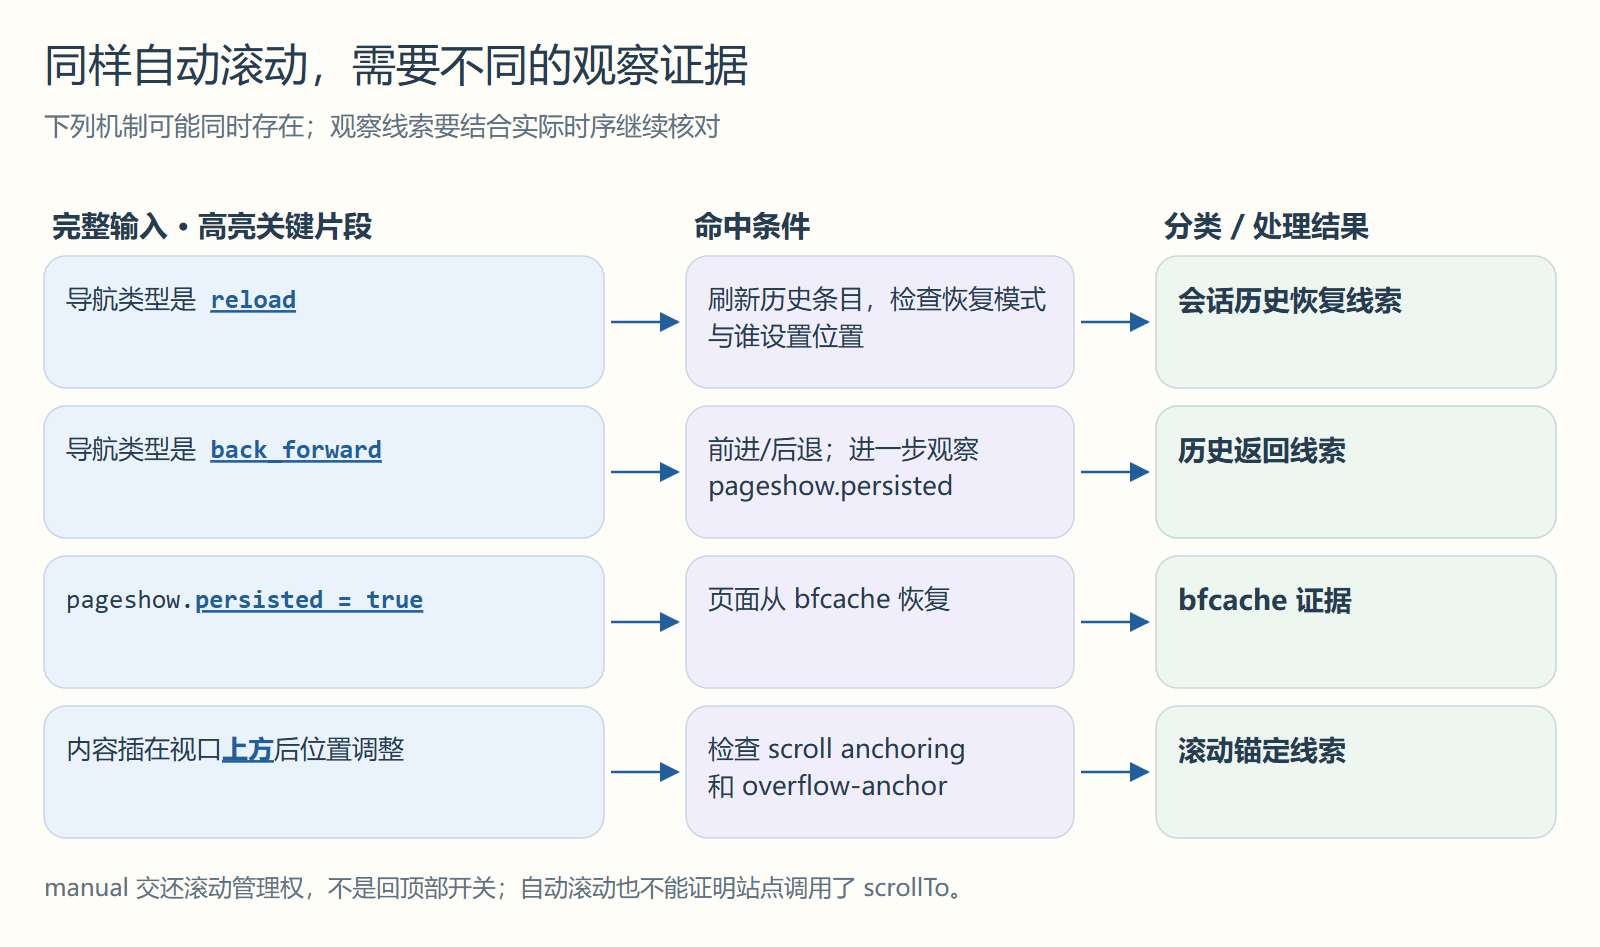
这里用 PerformanceNavigationTiming.type 区分刷新,是因为 MDN 对这个字段的定义里,reload、back_forward 和普通 navigate 是不同类型。这样插件可以只处理「用户刷新首页」这一种情况,不把读文章时后退回原位置的体验一起破坏掉。
后面两次 scrollTo(0, 0) 只是兜底。真正重要的是前面那句 history.scrollRestoration = 'manual' 要足够早,否则页面加载后再滚回去,很容易出现闪动,也可能已经触发过无限流。
这段是刷新场景的示意,不能单凭 type === 'reload' 就保证后退体验不变。scrollRestoration 作用于历史条目,页面进入 bfcache 后,原来的 manual 和脚本状态可能继续保留,早期脚本也不一定重跑。完整实现还要处理模式恢复,并实测「刷新首页 → 打开另一页 → 后退」和 bfcache 返回,不能只验证刷新后回顶部。
不要把相邻机制当成同一个问题
网上讨论这类问题时,几个概念经常混在一起。
第一个是 bfcache。后退 / 前进缓存会把页面快照留在内存里,回来时可能连 DOM、JS 状态和滚动位置一起恢复。它和这次「刷新后保留滚动位置」相邻,但不是同一个开关。判断 bfcache 常看 pageshow 的 persisted,而刷新触发的更多是会话历史里的滚动恢复。
第二个是 overflow-anchor。这个 CSS 属性控制的是 scroll anchoring,也就是页面上方插入内容时,浏览器为了减少位移而调整滚动位置。MDN 对 overflow-anchor 的说明也落在「内容变化时减少位置跳动」这条线上。它解决的是内容插入引起的锚定,不是刷新后从会话历史恢复旧 scrollY。把它全局关掉,可能会让另一些内容跳动更明显。
第三个是「禁用缓存」。HTTP cache、bfcache、session history scroll restoration 是不同层的机制。为了阻止刷新后恢复滚动去禁用页面缓存,代价太大,也不一定打到正确位置。
更合适的修法怎么选
如果页面是自己写的普通应用,最好的方案通常是让 Router 接管:在路由层决定哪些页面回顶部,哪些页面恢复旧位置,哪些页面等数据和动画完成后再恢复。Vue Router、React Router、TanStack Router 和 Next.js 的资料都说明了同一点:滚动恢复需要和导航、缓存 key、异步渲染时机放在一起考虑。
如果页面是无限流或虚拟列表,单独记 scrollY 往往不够。更稳的是同时保存列表数据、分页 cursor、筛选条件和滚动位置。返回页面时先还原足够多的列表内容,让页面高度能承载旧位置,再恢复滚动。只保存位置,不保存数据,最容易在恢复时撞到底部哨兵。
如果是浏览器插件改第三方站点,范围要更保守。对知乎首页这种场景,我更倾向于:
- 只在
www.zhihu.com/首页生效; - 只处理
reload,不处理back_forward; - 用一条
document_start的早期脚本设置history.scrollRestoration = 'manual'; - 正常内容增强、样式增强、DOM 观察继续留在较晚阶段;
- 实测知乎页面脚本是否会覆盖
history.scrollRestoration,只有覆盖时再加很小的二次纠正。
旧式的 window.onload、setTimeout(scrollTo)、循环检查滚动位置也能在简单页面上凑效,但它们只能等加载事件或定时器触发后再改 scrollTop。在无限流首页里,浏览器可能已经恢复完旧位置,底部哨兵也可能已经进入视口;这时再滚回顶部,只是把闪动和误加载藏到后面。Stack Overflow 早期答案里就有这些写法,后来 history.scrollRestoration 出现以后,方向已经变成「提前声明谁负责滚动恢复」。
这次现象提供了一个排查方向:浏览器的通用恢复策略是否与无限流的加载条件冲突。先确认恢复来自浏览器还是站点,再决定这一次导航的滚动位置应该由谁负责,比加载后再把页面拉回顶部更有针对性。