从 Vercel 的 Agent 教程开始:普通开发者怎么做一个能落地的 AI Agent
Vercel 在 2026 年 6 月发了一篇教程:Build AI agents with AI Gateway and AI SDK。它把 Next.js、AI SDK、AI Gateway、Sandbox、Connect 和 Workflow SDK 放在同一条开发路线上。第一次做 Agent 时,很容易看懂每段代码,却不清楚为什么需要这么多部件,离开 Vercel 又该怎样搭。
这篇沿着一个客服售后任务往下拆:先让模型查询订单、生成回复草稿,再看工具权限、失败恢复和长任务为什么需要由程序接管。实践部分用本地 Node.js 服务和 AI SDK,不要求先部署到 Vercel;平台产品和 API 说明以写作时的文档为准,接入时仍应核对所安装版本。
很多人第一次写 Agent,写出来的其实只是一个问答接口:用户在页面上提问,后端调用 OpenAI、DeepSeek、Qwen 这类模型 API,再把回答返回页面。这是一个很好的第一步,但它离真正能完成任务的 Agent 还差几块能力:
- 工具调用:能查订单、读数据库、搜索文档、跑测试,而不是只凭模型已有知识回答。
- 结构化输出:能稳定返回任务类型、风险等级、工具参数这类对象,让程序继续走后面的分支。
- 运行循环和失败恢复:能根据工具结果判断下一步,工具失败时能重试、换方法,或者停下来追问用户。
- 状态和长任务:能保存任务进度,支持暂停、恢复和等待人工确认,而不是一次 HTTP 请求结束就什么都丢了。
- 安全边界:有沙箱、权限、预算、日志和审计,知道哪些动作可以自动做,哪些动作必须先让人确认。
这些能力补上以后,它才从「问答接口」开始接近一个能在边界内完成任务的 Agent。
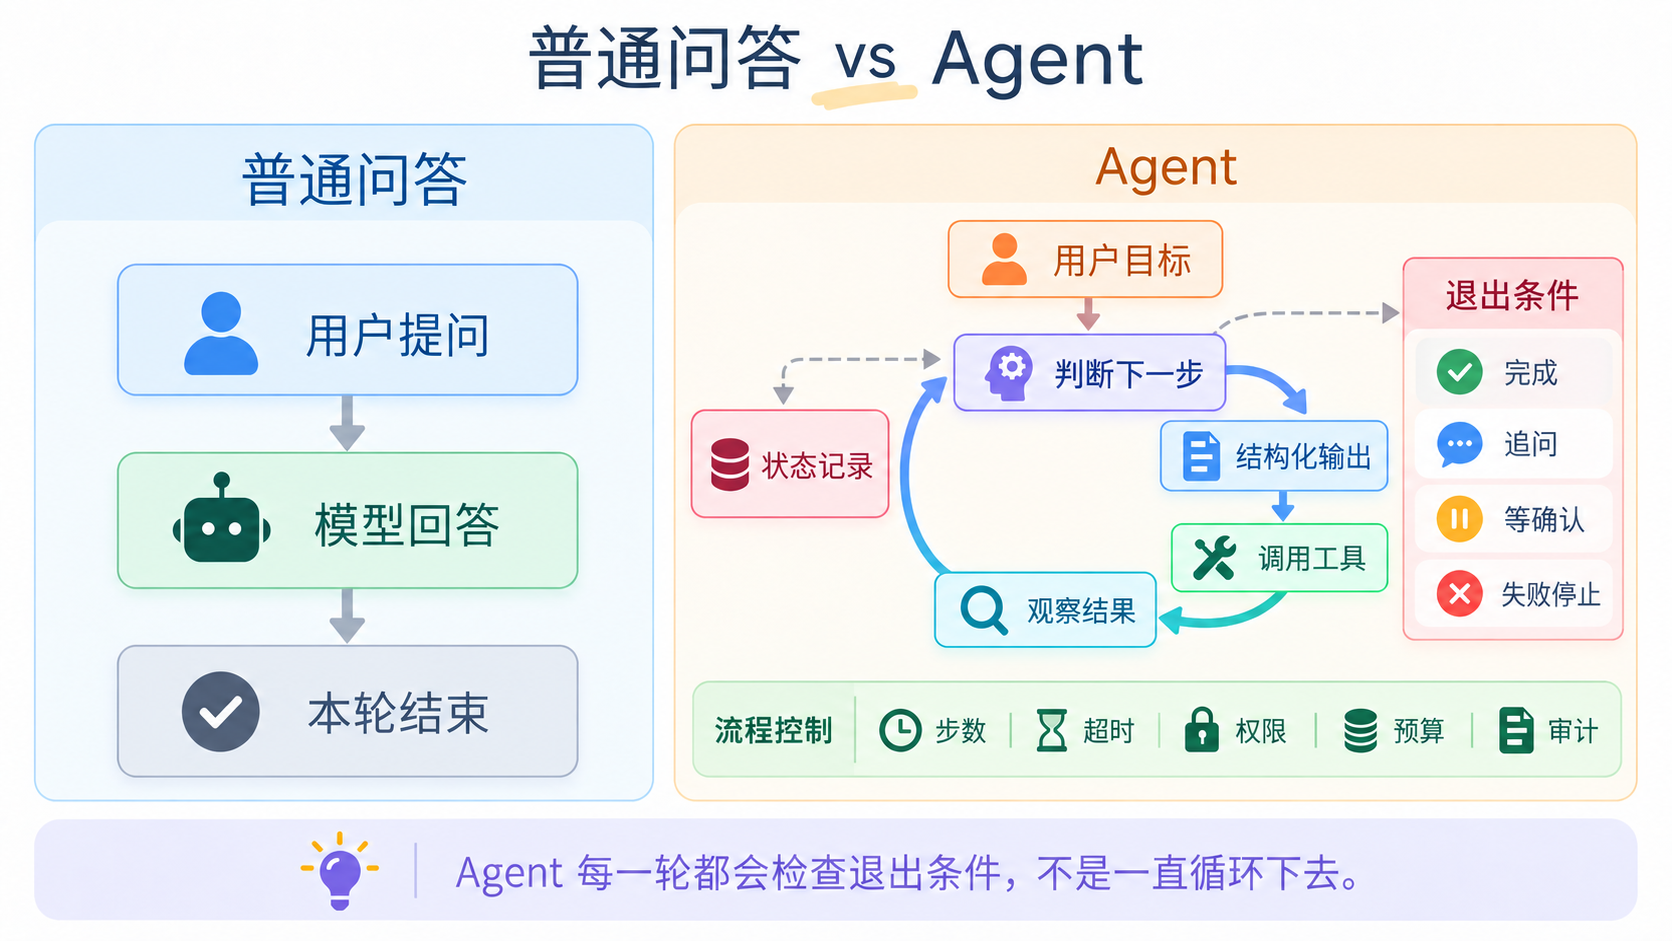
普通聊天接口只处理一次问答:用户输入进来,模型生成一段文本,程序把文本返回给用户。Agent 多了一层受控循环,但这个循环不是从用户目标开始一直转下去。一次 Agent run 里,模型会判断下一步,输出可被程序理解的工具名、参数和风险信息;程序调用工具、观察结果,再决定要不要进入下一轮。
每一轮结束时,运行时都会先看退出条件:目标已经完成,就返回结果;信息不够,就追问用户;需要高风险动作,就等待确认;工具连续失败、超时或超出预算,就停止并说明原因。只有仍然存在可以继续推进的下一步时,才会进入下一轮。
状态记录也不是普通步骤里的一格。它更像贯穿整个 run 的外部记录:用户目标、模型决定、工具参数、工具结果、失败原因、人工确认和最终结果都会被写进去。这样任务暂停、重试、恢复或事后审计时,程序知道前面发生过什么。
模型可以提出要调用哪个工具、用什么参数;真正执行工具、校验参数、记录状态、检查退出条件、限制权限和拦住危险动作的,仍然是程序。Agent 能推进任务,也可能做错事,模型和程序的职责必须分开。
这篇面向会写一点应用代码的读者:你知道 AI 可以生成文字、写代码和回答问题,知道 Web 应用通常通过接口访问后端服务,也能看懂基本的 HTTP route、环境变量和 JSON。
Agent 是什么
OpenAI Agents SDK 的文档给了一个很工程化的定义:Agent 是一个配置了 instructions、tools,以及可选 handoffs、guardrails、structured outputs 等运行时行为的大语言模型。这个定义把 Agent 从「会聊天的模型」拉回到「模型 + 指令 + 工具 + 运行时约束」。
这篇文章采用一个更接近日常开发的说法:从产品视角看,Agent 是一种能替用户推进任务的能力;从工程视角看,它通常是一个由大模型驱动、能根据目标决定下一步、并通过工具或运行时环境推进任务的程序。
它和前端、后端、客户端、Web App、移动 App、聊天框的分类不同。前端、后端、客户端说的是系统怎么实现;Web App、移动 App、终端命令说的是用户从哪里进入;Agent 说的是系统能不能围绕目标连续推进任务。
所以 Agent 最后露给用户的界面可以很不一样。它可以是聊天框,可以是客服后台里的一个按钮,可以是 Slack bot、浏览器插件、IDE 插件、后台 workflow,也可以只是一个终端命令。
以 Claude Code 为例,它可以直接跑在终端或支持的 IDE 里。用户表面看到的可能只是一个 claude 命令和一段文字交互,但背后要完成仓库读取、文件编辑、命令执行、权限确认、上下文管理、会话恢复、模型调用和工具编排。界面可以很薄,背后的工程系统却很重。
Agent 可以拆成四个部分:
- 目标:用户要它完成什么事,而不只是回答什么问题。
- 模型:理解目标、判断下一步、生成工具参数和解释结果。
- 工具:查询数据库、搜索文档、调用 API、修改文件、运行命令这类外部动作。
- 运行时:控制循环、权限、失败恢复、日志、成本、人工确认和长任务状态。
为什么需要 Agent
普通 AI 问答的边界很窄:用户问一句,模型回一段,这一轮就结束了。它适合解释概念、写一段文案、回答一个明确问题。真实工作里,很多任务会分成多步往前走,每一步都把新的结果交给下一步使用。客服售后任务里,先查到订单状态,才知道要不要看退款规则;写代码时,先跑完测试,才知道下一处代码该怎么改;做文档迁移时,先读完文件,才知道哪些字段要抽取。模型给出的答案在这里会继续作为下一步判断和动作的输入。
下面这些任务表面上都可以先问 AI 一句,但真正落地时都是多步依赖链:
- 代码修复任务:读 issue,查仓库里的历史实现,改几处文件,运行测试,再根据失败信息继续修。
- 客服售后任务:看用户问题,查订单、付款、物流和售后政策,判断下一步动作,再起草回复或创建工单。
- 文档迁移任务:读旧文档和新规范,抽取结构化字段,比较差异,生成迁移清单和待确认项。
- 数据分析任务:读一批表格或日志,写查询或脚本,跑出结果,发现异常后再换一个统计口径。
- 代码执行任务:生成一段脚本,放到隔离环境里运行,读取输出,再根据报错或结果修正。
这些任务适合 Agent 的原因很具体:目标清楚,但路径不固定;中间需要调用外部工具,单纯生成一段文字不够。传统程序当然也能写这种流程,但它要求开发者提前列出所有分支。Agent 的价值在于把一部分「下一步怎么走」交给模型判断,同时仍然用程序控制工具、权限、状态和验证。
传统程序更适合另一类工作:规则稳定、路径确定、输入输出边界清楚、成本和延迟需要严格控制。比如税费计算、库存扣减、账单结算、订单状态流转、权限校验、定时同步、埋点清洗、报表生成,只要规则能提前写清楚,就应该优先用普通程序。Agent 更适合放在「目标明确,但中间路径需要读材料、判断、调用工具、反复验证」的位置。
为什么 Agent 开发会这么火
Agent 开发变热,是因为几个更上游的条件同时成熟了。
第一,模型终于能比较稳定地使用结构化接口。早期大模型更像文本补全器:你让它写一段回答,它能写;你让它输出一段稳定 JSON、在合适时机选择工具、把工具结果纳入下一步判断,就容易出问题。现在函数调用、结构化输出、长上下文、多模态输入和更强的指令遵循能力一起出现,模型才有机会进入软件系统的控制流。
第二,软件世界已经 API 化。GitHub、Slack、Notion、Jira、数据库、日志平台、浏览器、CI、云服务都有 API、Webhook、CLI 或自动化入口。Agent 可以站在这些已有能力之上,像一个会判断时机的调度层:该查资料时查资料,该跑测试时跑测试,该等审批时暂停。
第三,工具接入开始标准化。过去每接一个系统,都要写一套只服务当前产品的连接器;现在有函数调用、Vercel AI SDK tools、OpenAI Agents SDK tools、LangGraph tools,以及 MCP 工具规范 这类协议。工具有名称、描述、参数 schema 和调用结果,模型可以在统一的描述面前选择下一步,程序则负责真正执行。
第四,Coding Agent 给开发者提供了最直接的样板。Cursor Agent 能读仓库和改文件,GitHub Copilot cloud agent 能接 issue 并开 PR,这些产品把「模型 + 工具 + 运行时」的价值展示得很具体。工程师一旦看到 AI 可以看 diff、跑测试、修错误,就会自然想把同样模式搬到客服、运营、数据、运维和内部工具里。
第五,企业里有大量「人肉粘合」工作。很多流程的难点落在跨系统串联:一边查订单,一边读政策,一边写工单,一边等审批;一边读日志,一边查发布记录,一边写复盘。Agent 热起来,是因为这些任务一直存在,只是以前很难为每一种分支都写一套传统流程。
第六,平台开始补齐生产化部件。Vercel 在同一篇教程里讲 AI Gateway、Sandbox、Connect、Workflow,OpenAI Agents SDK 也在一个开发框架里提供 tools、handoffs、guardrails、tracing。Agent 开发从「自己拼 prompt」变成「用 SDK、协议和运行时组装系统」,门槛自然会下降。
火爆背后也有风险。Agent 越能做事,越需要权限控制、日志、预算、评估和人工确认。开发者真正要学的是:怎么让模型在软件系统里可靠地做有限的事。
Agent 能干什么
Agent 能做的事,取决于你给它哪些工具和权限。模型本身只会生成内容;工具和运行时把内容变成动作。
最常见的能力可以按动作类型分:
- 查:搜索知识库、读取接口文档、查数据库、看日志、检索代码仓库。
- 写:生成回复、整理报告、写代码、补测试、起草邮件、生成 PR 描述。
- 改:修改多文件代码、调整配置、更新 issue、补文档、改工作流。
- 跑:执行测试、运行脚本、在沙箱里跑模型生成的代码、验证页面行为。
- 等:暂停等待人工确认、等外部任务完成、失败后重试、恢复长任务。
- 协作:把任务分给另一个 Agent,或者把当前任务交给人类继续处理。
这些动作经常出现在同一个任务里。比如售后任务通常先「查」订单、付款、物流和规则,再「写」摘要、判断依据和回复草稿,靠近真实副作用时还要「等」人工确认。一个 Agent 往往会按任务进展选择下一步动作,并把工具结果留给后续步骤使用。
这套链路靠分工成立:模型负责理解目标、选择下一步和解释工具结果;工具负责查真实数据或执行动作;运行时负责权限、日志、暂停、恢复和人工确认。
常见 Agent 都有哪些
现在大家说的 Agent,可能指很多产品形态。更稳的理解方式,是按使用场景分。
- 聊天和工作助理型 Agent
- 主要在聊天窗口里查资料、整理信息、写内容,也可以调用连接器或企业内部工具,例如企业知识库问答、会议纪要助手、邮件草稿助手、个人资料整理助手。
- 它离普通聊天机器人最近,但只要接了外部工具,就要处理资料来源、账号授权和上下文泄露问题。
- Coding Agent
- 处理完整代码任务:读项目、改文件、运行命令、修复测试、解释 diff,例如 Cursor Agent mode、GitHub Copilot cloud agent、Codex、Claude Code、Devin。
- 它面对的是「读项目、改文件、跑验证」这一串连续动作,仓库权限、命令执行、依赖安装、测试结果和代码 review 都要纳入边界。
- 客服、销售和运营 Agent
- 读取知识库、CRM、订单系统和工单系统,回答问题、总结需求、创建工单或给出下一步建议,例如售后退款助手、销售线索总结助手、工单分流助手、运营活动配置助手。
- 难点通常落在权限、审计、数据脱敏、人工交接和外部用户体验上。
- 研究和数据分析 Agent
- 通常先搜资料、读文件或查数据库,再用统计脚本验证数据,最后整理成报告。例如竞品调研助手、论文阅读助手、财务报表分析助手、日志异常归因助手。
- 这类 Agent 要标清来源、保留计算过程、区分事实和推断,避免把一次不可复现的模型输出当成结论。
- 浏览器和电脑操作 Agent
- 打开页面、点击按钮、填表、下载文件、检查 UI,或者操作远程桌面和业务后台,例如网页表单自动填写、后台配置检查、UI 回归验证、登录态页面资料整理。
- 界面状态变化大,操作也可能有副作用,所以必须限制权限、记录步骤,并给高风险动作留确认点。
- 开发框架里的 Agent
- 给工程师提供组装能力,把模型、工具、状态和工作流组合成自己的 Agent,例如 Vercel AI SDK、OpenAI Agents SDK、LangGraph、Cloudflare Agents、AutoGen。
- 框架只解决一部分工程问题,最终仍然要由业务代码决定权限、状态、评估、成本和人工介入方式。
这几类之间会重叠。一个 Coding Agent 也可能需要浏览器操作;一个客服 Agent 也可能需要工作流引擎;一个研究 Agent 也可能调用代码沙箱跑分析脚本。分类的价值只是帮助你判断:这个 Agent 的主要风险和工程重点在哪里。
一个客服售后 Agent 的例子
在这篇文章里,我们统一用一个客服售后场景来承接后面的工程细节。这个系统的前因后果可以展开成这样。
客户先在 App、网页或在线客服入口里提出问题,例如「我这笔订单还能退款吗」。这条消息进入客服工作台后,系统会把它和客户身份、订单列表、历史会话、售后记录放在一起展示。客服人员看到会话后,才是 Agent 的直接使用者:他可以点工作台里的「AI 助手」按钮,也可以在内部输入框里对系统发起一个任务:「帮我查一下 ORD-2026-0001 能不能退款,顺手给客户写一段回复」。
Agent 收到任务后,后端会把当前会话、客服账号、可用权限、客户身份、订单号、规则版本一起组成上下文。接下来,系统会查询订单、支付、物流、售后政策和历史工单,把工具结果交给模型整理成订单摘要、退款判断、风险提示和回复草稿。涉及真实退款时,系统停在草稿和人工确认阶段,不直接提交退款申请。
最后结果回到客服工作台。最简单的接入方式,是客服把 Agent 写好的回复复制到聊天框里,人工确认后发给客户;更深一点的集成,是客服点击「发送」或「一键回复」,系统带着会话 ID、草稿内容和审计记录直接把消息发回客户。如果还要提交退款申请,也应该在客服确认后再进入审批流。
下图按实际系统顺序展示:客户消息进入客服工作台,客服触发 Agent,中间的 Agent 流程对应下面这组执行步骤,客服确认后再回复客户或进入审批。
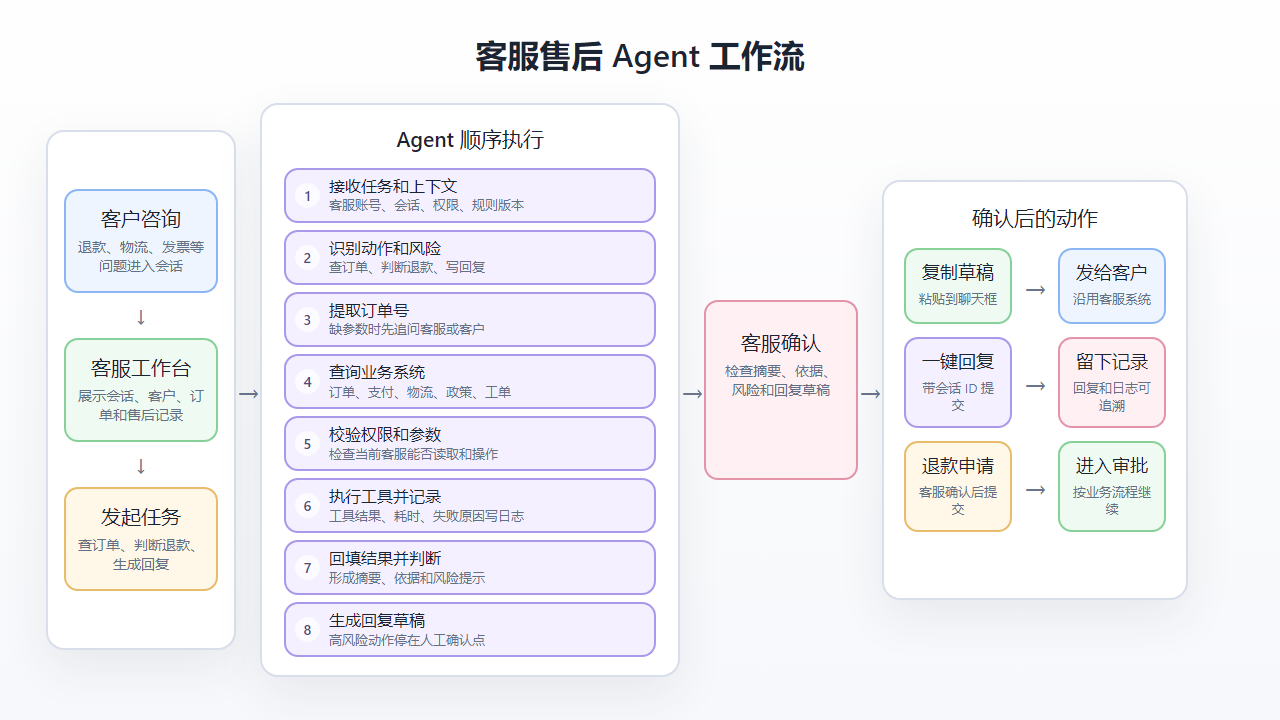
退款只是这个系统里的一种任务。同样的结构也适用于物流延迟、发票修改、会员权益、换货申请、投诉工单、企业 IT 支持、HR 自助办事和销售线索跟进:业务人员用自然语言提出目标,系统需要读取业务数据,结合规则判断下一步,再把结果交给人或后续流程。
这个场景适合用来解释 Agent,因为它刚好覆盖了 Agent 开发里最常见的几条边界:
- 目标清楚,但路径不固定。系统知道客服人员要处理一条售后问题,但要先看订单状态、付款时间、物流进度和退款规则,才能判断下一步。
- 必须调用真实工具。模型自己的知识里没有这张订单,也不知道公司当前退款规则,后端必须提供订单查询、规则读取和草稿生成这类工具。
- 输出分两类。订单摘要、判断依据和回复草稿是给客服看的;订单号、风险等级、工具参数和审批状态是给程序继续处理的。
- 风险等级不一样。查询订单是只读动作,生成回复是草稿动作,真正提交退款会改变业务状态,应该等待人工确认。
一个客服 Agent 可以这样执行:
- 接收目标和上下文:拿到客服人员发起的任务,也拿到当前客服账号、会话 ID、可用权限和公司退款规则版本。
- 识别任务和风险:这条任务里有三个动作,查订单、判断能否退款、写回复;其中「退款」有真实副作用,不能自动提交。
- 提取必要参数:从客户消息或客服任务里取出订单号
ORD-2026-0001;如果订单号缺失或格式不对,先追问,不调用后面的业务工具。 - 规划只读查询:先查订单状态、付款时间、物流状态、售后记录和退款政策,不做任何会改变订单状态的动作。
- 生成工具参数:模型给出
getOrderStatus({ orderId })这类调用意图,程序按 schema 校验参数,再检查当前客服有没有读取这个订单的权限。 - 执行工具并记录结果:后端代码访问订单系统、支付系统和知识库,把结果转成模型能读懂的结构化信息,同时写下工具调用日志。
- 把工具结果交回模型:模型根据订单状态、付款时间和政策条款判断「可以退」「不能退」或「需要主管确认」,并说明依据。
- 判断权限边界:如果只是回复草稿,可以继续生成;如果要真正退款,运行时要求人工确认,不能让模型直接调用提交接口。
- 生成客服可用的输出:给出订单摘要、判断依据、建议动作和一段回复草稿,把不确定项标出来。
- 等待人工确认:客服确认后,系统才调用
submitRefundRequest;客服不确认,就停在草稿和建议阶段,状态留在这次会话里。
后文讲角色、工具、结构化输出、权限和长任务时,都会回到这个客服售后场景。这样同一组目标、工具和风险能持续对应到不同工程层,读者可以沿着同一个业务背景理解每一层。
一个完整 Agent 通常有哪些角色
下图沿用这个客服售后场景,展示一条请求链路里 Agent 的各个工程角色的作用:任务目标进入 Agent 后端,后端通过 AI SDK、模型网关和模型提供方拿到模型能力;需要业务数据时,再调用工具、读写状态和审计记录。对应到工程实现时,可以按下面这些职责理解。
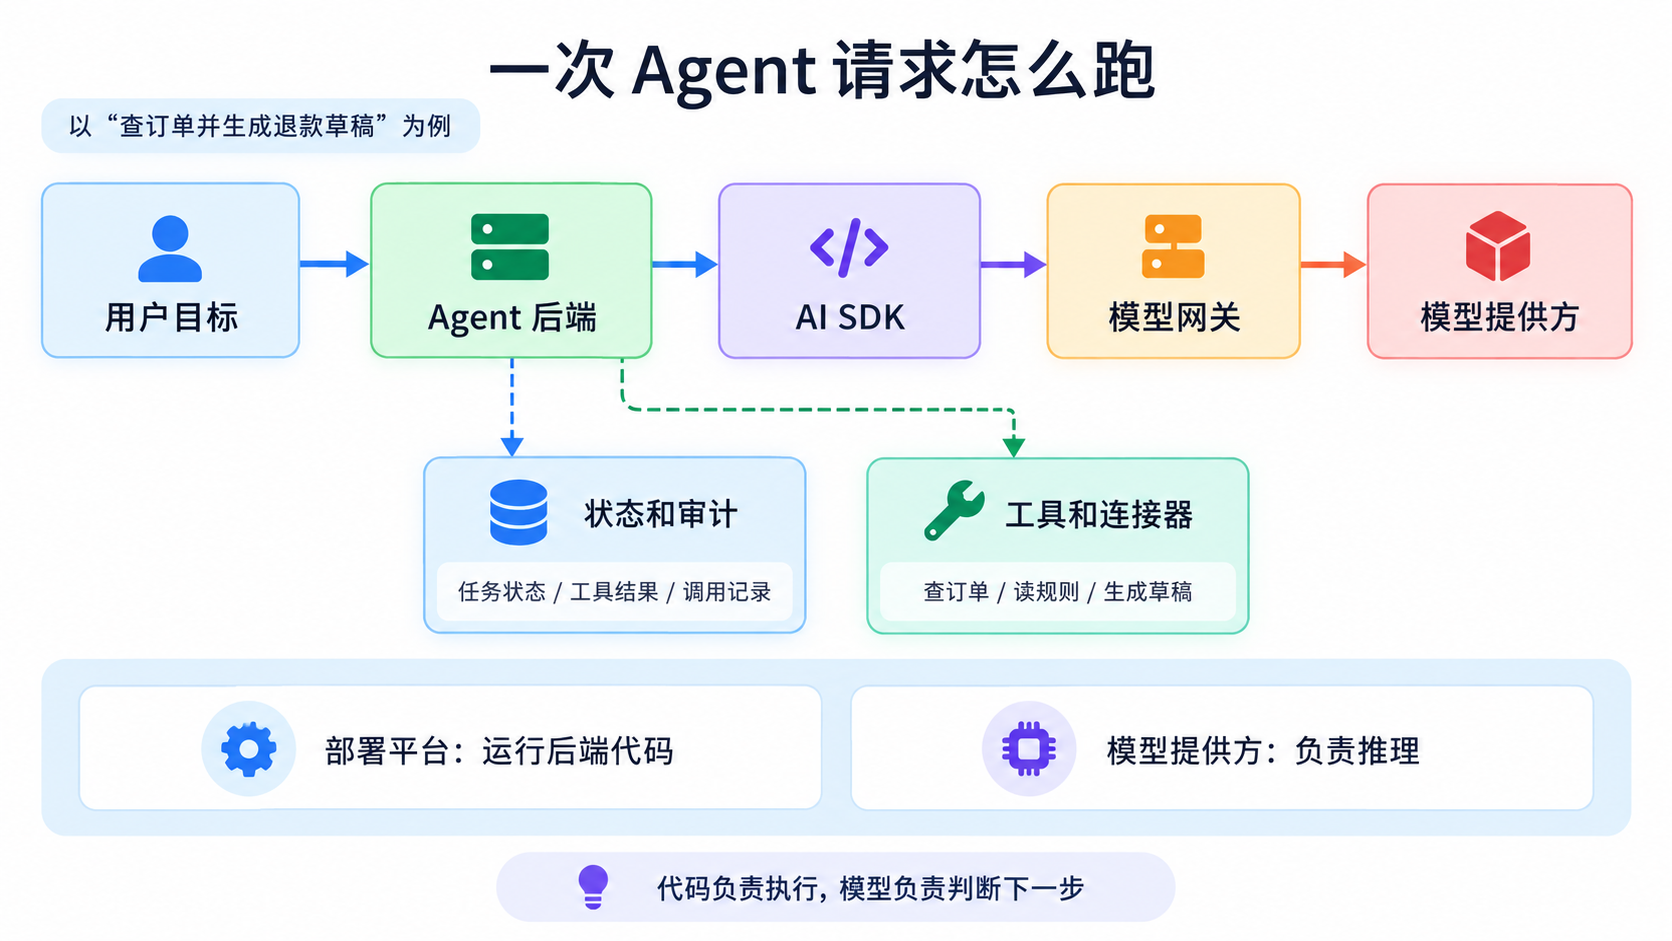
- 模型提供方:真正执行推理,返回文本、结构化对象、embedding、图片等结果。常见选择有 OpenAI、Anthropic、Google、xAI、阿里云、DeepSeek,也可以用 vLLM、Ollama、TGI 这类自部署模型。
- 模型调用 SDK:把代码里的请求变成模型 API 调用,并处理 streaming、tools、schema。常见选择有 Vercel AI SDK、OpenAI SDK、Anthropic SDK、LangChain、LlamaIndex,也可以自己写 adapter。
- 模型网关:管理 key、路由、fallback、限额、成本、日志和 provider 切换。常见选择有 Vercel AI Gateway、LiteLLM、OpenRouter、自建 OpenAI-compatible proxy。
- Agent 后端:保存上下文,决定什么时候调用模型、什么时候调用工具、什么时候停下来等人确认。它可以是 Express、Fastify、Nest、Hono、Python / Go 服务、Serverless Function 或 Kubernetes Job。
- 工具和连接器:让 Agent 读取数据库、查订单、发请求、读文件、调用第三方 SaaS。实现方式可以是本地函数、MCP Server、OAuth 应用、内部 API 或平台托管工具。
- 状态和记忆:保存会话、任务状态、工具结果、用户偏好、向量索引和审计记录。常见底座是 Postgres、Redis、S3 / OSS、向量数据库和日志系统。
- 隔离执行环境:执行不可信代码、跑命令、处理文件,同时限制权限和资源。常见选择有 Docker、gVisor、Firecracker、Kubernetes Job、托管 Sandbox 和独立 worker。
- 工作流和长任务:让 Agent 在分钟级、小时级任务里能暂停、重试、恢复和补偿。常见选择有 Temporal、Inngest、BullMQ、Cloud Tasks、Airflow 和平台 Workflow。
- 观测和治理:看每次调用花了多少钱、用了哪个模型、失败在哪、有没有越权。常见工具包括 Langfuse、Helicone、OpenTelemetry、自建成本台账、网关日志和审计日志。
Agent 的自主程度怎么控制
同一个客服售后场景里,读取订单可以自动化,生成回复应该先生成草稿,真正提交退款则要人工确认。Agent 的类型不同,自主程度也不同。同样是「让 AI 做事」,查资料、写草稿、退款、删除数据不能放在同一个权限等级里。判断自主程度时,可以先看四件事:结果能不能撤回,错误能不能及时发现,动作会不会影响外部用户、钱、权限和数据,程序能不能用规则校验模型的决定。
- 建议型:Agent 只读材料、整理判断,把建议交给人,不主动修改业务状态。它仍可能读到越权数据或把敏感信息带到输出中,适合在来源和访问范围受控时做资料整理、日志归因和知识库问答。
- 草稿型:Agent 生成邮件、工单、PR 描述或退款申请草稿,但不提交。草稿本身可编辑、可丢弃,风险主要在「人有没有看过」,适合外部沟通和正式动作之前的准备。
- 受控执行型:Agent 可以自动执行已授权的查询和低风险动作。查订单、搜索知识库仍需检查数据权限;跑测试会执行仓库代码,也可能访问文件和网络,不能仅凭命令名把它归为安全。是否可自动化,要看工具实际能力和隔离环境。
- 审批执行型:Agent 准备动作和参数,人类确认后才真正提交,比如发邮件、退款、发布配置。它已经靠近真实业务结果,模型可以把材料准备好,但提交按钮应该留给人或确定性工作流。
- 高风险动作:删除数据、扣款、改权限、上线生产环境,默认不应该交给模型直接决定。这类动作通常不可逆,错误代价高,还可能牵涉合规、财务或安全审计,Agent 最多准备方案、生成变更单和列出影响范围。
控制自主程度,需要在受控环境里提供一组明确工具,让模型在边界内决定下一步。
怎么给 Agent 提供工具
工具 指具体可调用的能力。它可以是一个普通函数,比如查询天气、查数据库、搜索文档、创建 GitHub issue、发 Slack 消息、运行测试命令。模型本身不会真的访问你的数据库,也不会天然知道怎么给 Slack 发消息;它只是根据工具描述和参数 schema,决定什么时候应该调用哪个工具。真正执行动作的,仍然是你写的代码。
实际开发里,工具接入通常从下面这些入口开始:
- 本地函数 / function calling:在后端代码里定义一个函数,配上名称、描述、输入 schema 和执行函数。Vercel AI SDK 的 tool use 就是这种形态,适合查询订单、查库存、生成草稿这类贴近当前应用的动作。
- MCP Server:把工具做成独立服务,让不同 Agent 或客户端复用。MCP 的 tools 规范 把工具看成模型可发现、可调用的动作,客户端可以列出工具,再按参数调用工具。它适合数据库查询、内部系统、文件检索、设计工具、浏览器自动化这类希望跨客户端复用的能力。
- 平台托管工具:有些模型平台直接提供搜索、文件检索、代码执行、浏览器操作、电脑操作或沙箱。OpenAI Agents SDK 的 tools 文档 就把托管工具、函数工具和 MCP 工具放在一起讲。托管工具的好处是少写运行时,代价是要接受平台的权限、计费和数据边界。
- 连接器 / OAuth 授权:接 Slack、GitHub、Google Drive、Notion、飞书、企业微信这类第三方系统时,工具往往还要绑定账号授权和权限范围。麻烦通常落在授权边界:谁能授权、授权多久、能访问哪些空间、日志能不能追溯。
- Skill / 脚本包:在 Codex、Claude Code、Cursor 这类开发 Agent 里,Skill 更像一包可复用的说明、脚本、模板和验收规则。它不一定是模型直接调用的 API,但能告诉 Agent 这个领域该怎么做、用哪些命令、改哪些文件、怎样检查结果。
- 工作流 / 队列:有些工具不是一次请求能完成的,比如生成报表、跑批处理、等待人工审批、长时间抓取网页。做法通常是把工作流系统包装成工具:Agent 启动任务、查询状态、在需要确认时暂停,下一次再从状态里恢复。
选择时不用追求一步到位。业务内的小动作先写本地函数;多个产品或多个 Agent 要复用同一批动作,再做 MCP;搜索、文件检索、代码执行这类通用能力先看平台托管工具;涉及第三方账号就把 OAuth、权限范围和审计日志一起设计;任务会跨分钟、跨小时甚至跨天时,再接工作流或队列。
一句「你要自主」解决不了工具权限、参数校验和失败恢复。受控执行环境里的职责可以这样分:
- 模型负责理解目标、选择下一步、生成参数和解释结果。
- 程序负责定义工具、校验参数、执行副作用、记录状态和拦住危险动作。
- 运行时负责循环、失败重试、长任务恢复、权限、日志和成本控制。
利用 Vercel AI SDK 动手实现一个 Agent
实践沿用 Vercel 那篇教程中的 AI SDK:模型调用、流式返回、结构化输出和工具调用都能在同一个包族里看到,适合用来理解前面的概念。我们用 ai 包写 Agent 逻辑,再放进本地 Node.js 服务里运行;部署、模型网关、沙箱、授权和工作流可以按需要接入 Vercel,也可以使用后文列出的替代方案。
文本、流式和结构化输出
Agent 的底座是一次模型调用。底层供应商可以不同,业务代码里最常遇到的输出形态通常是三类:
- 生成文本:用在人要直接阅读的地方,比如回答问题、解释工具结果、起草邮件、写报告、生成 PR 描述。它的输出适合给人看,不适合直接拿去做程序分支。
- 流式输出:用在用户正在等的地方,比如聊天页、长报告生成、代码解释和排障建议。流式返回能让界面先显示进度,也方便在用户取消、网络中断或工具调用耗时时做更好的交互。
- 结构化输出:用在程序要继续处理模型结果的地方,比如任务分类、风险等级、工具参数、工单字段、数据库写入前的校验对象。结果一旦要进入
if、队列、数据库或另一个 API,就应该优先用 schema 约束,而不是事后从自然语言里用正则抠字段。
很多 Agent 的不稳定,源头常常在接口边界:模型回答得出来,开发者却把一段自然语言当成稳定数据用了。
Vercel AI SDK 的三类包
上面提到的文本、流式和结构化输出,最后都要落到代码接口上。如果每家模型厂商都用自己的写法,业务代码很容易被 OpenAI、Anthropic、Gemini、DeepSeek 这些接口差异拖住。Vercel 开发的 AI SDK 是一组 TypeScript 包,用来把模型调用、流式返回、结构化输出、工具调用和前端聊天状态变成一套相对统一的接口。
这组包大致分三类。
- 核心包
ai:提供generateText、streamText、generateObject、Output、tool这些入口。Agent 后端逻辑、队列 worker、CLI、API route 里最常用的是它,因为真正的模型调用、工具调用和结构化输出都发生在服务端。 - Provider 包
@ai-sdk/openai、@ai-sdk/anthropic、@ai-sdk/google、@ai-sdk/deepseek等:负责把统一接口接到不同模型供应商。直接用某家模型厂商的 API key 时,一般需要安装对应 provider 包,例如@ai-sdk/openai或@ai-sdk/deepseek。 - UI 包
@ai-sdk/react、@ai-sdk/vue、@ai-sdk/svelte、@ai-sdk/angular等:负责前端框架里的聊天消息、流式展示和工具调用状态。它们适合写聊天页、客服工作台和生成式 UI;密钥、真实模型调用和工具执行仍然应该留在后端。
ai和@ai-sdk/*这组名字容易让人误会。它们不像jwt、cookie这种平台无关的技术名,也不像body-parser这种和具体 Web 框架解耦的中间件名;它们属于 Vercel 主导的 AI SDK 项目,只是用一组很通用的 npm 包名发布。按传统品牌识别习惯,叫@vercel/ai、@vercel/ai-sdk-openai会更不容易误解。但这不等于它只能在 Vercel 平台上用。官方 README 把 AI SDK 定位成 provider-agnostic 的 TypeScript toolkit,支持 Next.js、React、Svelte、Vue、Angular 和 Node.js 等运行环境。更准确的理解是:这是 Vercel 维护的一套通用 AI 应用抽象;你可以部署在 Vercel,也可以在自己的 Node.js 服务、serverless 平台或其他后端运行时里使用它。
对业务代码来说,这套命名带来的好处是主流程长期面对
generateText、streamText、tool这组通用 API,而不是把 OpenAI、Anthropic 或 Google 这类供应商写进每一层业务逻辑。它的代价是品牌归属不够直观,读者第一次看到ai和@ai-sdk/*时,很容易把「通用 API」误读成「中立标准库」。
这篇实践的代码先走一条能在本地跑起来的链路:本地 Node.js 后端、ai、@ai-sdk/openai-compatible、zod,再接一个本机 OpenAI-compatible 模型服务。Node.js 只是后端运行环境,这里不展开;本节重点看后面三个包:
ai负责模型调用、流式返回、结构化输出、工具定义和工具循环。@ai-sdk/openai-compatible负责把 AI SDK 接到兼容 OpenAI API 的模型服务,比如 LM Studio、Ollama 的 OpenAI-compatible endpoint,或者团队自建的 OpenAI-compatible proxy。zod负责描述结构化输出和工具参数,让模型给出的对象能被程序校验。
为什么还要
zodTypeScript 只能在写代码和编译时帮我们检查类型,代码运行起来以后,类型信息已经被擦掉了。模型返回的 JSON、HTTP 请求体、工具调用参数,都是运行时才出现的外部输入;程序不能只因为 TypeScript 里写了
RefundRequest,就相信模型一定会返回合法字段。
zod做的是运行时校验:模型说要调用getOrder,AI SDK 会拿zodschema 检查参数里有没有orderId、类型是不是字符串、枚举值是不是合法。结构化输出也是同样道理,模型返回对象以后先过 schema,程序再进入下一步。它还有一个好处:同一份 schema 可以推导出 TypeScript 类型,避免「运行时校验规则」和「代码里的类型」写两份后慢慢漂移。
完整项目还需要 Hono、静态页面服务等外壳依赖;模型调用和结果处理则由 ai 包提供。
Vercel AI Gateway 是什么
AI Gateway 是 Vercel 托管的模型入口层,用来统一管理 provider key、模型路由、日志、预算和 fallback。本地代码也可以调用它,但通常要先在 Vercel 平台创建
AI_GATEWAY_API_KEY。这对第一次跟着教程跑 demo 的读者来说,门槛会高一截。所以这篇文章第一遍先不用 Gateway,而是用本机 OpenAI-compatible 服务跑通核心机制。等模型调用、工具调用和工具循环都理解以后,再把模型入口换成 AI Gateway、OpenRouter、LiteLLM 或某个模型厂商的 provider 包。
模型部分需要的依赖是:
pnpm i ai @ai-sdk/openai-compatible zod前端 UI 包只处理浏览器里的消息状态、流式展示和交互状态;后端工具、密钥和模型调用仍然放在服务端。
ai 包里提供了这些入口:
- 文本生成:
generateText适合后台任务、摘要、邮件草稿和工具执行后的说明。 - 流式文本:
streamText适合聊天页、长报告、代码解释和需要边生成边展示的交互。 - 结构化输出:
generateObject、streamObject、Output适合分类、抽取、路由和写库前校验,让模型按 schema 交出对象。 - 工具调用:
tool、dynamicTool、jsonSchema、zodSchema用来把搜索、数据库、业务接口和本地函数交给模型按参数调用。 - MCP / 外部工具:
createMCPClient用来接入 MCP Server,例如文件系统、设计工具或 SaaS 连接器。 - 多模型和供应商:provider 包、
createProviderRegistry和 AI Gateway 让同一套业务代码可以切换不同模型和供应商。 - Embedding / 图片:
embed、embedMany、generateImage用在向量检索、相似度计算、生成配图或视觉素材这类场景。
更完整的清单可以看 AI SDK Core Reference,工具调用可以单独看 Tools and Tool Calling。
从模型调用到结构化结果
以下示例使用 ai 包的核心入口,写成服务端 TypeScript 普通函数。Express、Hono、Next.js Route Handler、RPC、队列 worker 或 CLI 都可以在外层调用它,核心逻辑不必绑定某个 HTTP 框架。
先准备一个本地模型入口。下面的写法默认 LM Studio 的 Local Server 地址是 http://localhost:1234/v1;如果你用 Ollama 的 OpenAI-compatible endpoint,通常把 LOCAL_LLM_BASE_URL 改成 http://localhost:11434/v1。
// model.ts
import { createOpenAICompatible } from '@ai-sdk/openai-compatible';

const localProvider = createOpenAICompatible({
  name: 'local',
  baseURL: process.env.LOCAL_LLM_BASE_URL ?? 'http://localhost:1234/v1',
  apiKey: process.env.LOCAL_LLM_API_KEY ?? 'local',
});

export function getLocalModel() {
  const modelId = process.env.LOCAL_LLM_MODEL;

  if (!modelId) {
    throw new Error('缺少 LOCAL_LLM_MODEL,请先在本地模型服务里加载一个模型。');
  }

  return localProvider.chatModel(modelId);
}
// answer-question.ts
import { generateText } from 'ai';
import { getLocalModel } from './model';
export async function answerQuestion(question: string) {
const result = await generateText({
model: getLocalModel(),
system: '你是一个简洁、可靠的技术助手。',
prompt: question,
});
return {
answer: result.text,
};
}这段代码只是一个模型接口。它的价值在于把几个关键工程习惯立住了:
- 模型 ID 放配置里,不写死在业务逻辑里。
- system prompt 和用户输入分开。
- 业务函数只关心输入和输出,不关心请求来自哪个框架。
- 后面要加工具、fallback、日志和权限时,有明确入口。
真正接到 Web 服务时,Express、Fastify、Nest、Hono、Next.js Route Handler 做的事情都差不多:从请求体读出
question,调用answerQuestion(question),再把{ answer }转成 JSON 返回。换成 RPC、队列或 CLI,也只是把入口参数换掉,模型调用函数不用跟着重写。
流式输出适合用户正在等结果的场景。聊天页面如果等模型全部生成完再返回,会显得卡;流式接口可以让用户边看边等。
// stream-assistant-reply.ts
import { streamText } from 'ai';
import { getLocalModel } from './model';

export function streamAssistantReply(message: string) {
  const result = streamText({
    model: getLocalModel(),
    system: '你是一个能解释代码和排查问题的开发助手。',
    prompt: message,
  });

  return result.textStream;
}
这里返回的是一段可迭代的文本流。HTTP streaming、SSE、WebSocket、终端输出的写法不一样,但核心都是消费这段流,再把每个增量片段发给用户。
结构化输出则是很多新手容易跳过、但做 Agent 很快会遇到的能力。只要模型结果要进入程序分支,就不要让它随便写一段自然语言。让模型按 schema 返回对象,程序才能继续判断。
// extract-task.ts
import { generateObject } from 'ai';
import { z } from 'zod';
import { getLocalModel } from './model';

const TaskSchema = z.object({
  title: z.string(),
  priority: z.enum(['low', 'normal', 'high']),
  dueDate: z.string().nullable(),
});

export async function extractTask(text: string) {
  const { object } = await generateObject({
    model: getLocalModel(),
    schema: TaskSchema,
    prompt: `从下面这段话里提取任务信息:\n\n${text}`,
  });

  return object;
}
第一次做 Agent,优先跑通这三类调用。等模型调用、流式返回和类型安全的结构化结果都稳定了,后面的工具循环才有可靠地基。
工具让 Agent 开始做事
要让 Agent 真正改变外部世界,就要把「可执行动作」包装成工具。
一个工具通常包含三部分:
- 描述:告诉模型这个工具能做什么,什么时候该用。
- 输入 schema:告诉模型参数长什么样,同时让程序可以校验。
- 执行函数:真正访问数据库、HTTP API、文件系统或其他服务。
工具最好按可独立授权和验收的业务动作拆分。一个 callInternalApi 或 doCustomerAction 如果承载了许多不相关操作,模型很难选,程序也很难为它设权限。但拆得过细同样会增加调用和规划成本;目标是职责清楚,不是工具越小越多越好。例如:
getOrderStatus只查订单状态。listRefundRules只返回可用退款规则。draftRefundReply只生成客服回复草稿。submitRefundRequest真正提交退款申请,并且要求人工确认。
这样拆的好处是,程序可以给每个工具单独设置权限、超时、重试、审计和风险等级。模型也更容易在正确时机选中正确工具。
下面先实现贯穿示例里的只读工具:用户只问订单状态时,模型可以调用 getOrderStatus。
// order-agent.ts
import { generateText, tool } from 'ai';
import { z } from 'zod';
import { getLocalModel } from './model';

const tools = {
  getOrderStatus: tool({
    description: '根据订单号查询订单状态。只在用户明确询问订单状态时调用。',
    inputSchema: z.object({
      orderId: z.string().describe('订单号,例如 ORD-2026-0001'),
    }),
    execute: async ({ orderId }) => {
      const response = await fetch(`https://api.example.com/orders/${orderId}`);

      if (!response.ok) {
        return { ok: false, reason: `订单查询失败,HTTP ${response.status}` };
      }

      const order = await response.json();
      return {
        ok: true,
        orderId,
        status: order.status,
        updatedAt: order.updatedAt,
      };
    },
  }),
};

export async function answerOrderQuestion(message: string) {
  const result = await generateText({
    model: getLocalModel(),
    system: '你是订单助手。只有在需要订单数据时才调用工具。',
    tools,
    prompt: message,
  });

  return {
    answer: result.text,
  };
}
这个例子里,模型只知道有一个叫 getOrderStatus 的工具,工具需要 orderId,执行由后端代码完成。工具一旦有副作用,错误就可能改变真实业务状态,不能只按回答质量来评估。
定义工具时,尤其要检查这三处:
- 描述是否具体:
queryData、doAction、callApi这类名字对模型帮助很小。工具描述应该写清楚它解决什么任务、什么时候使用、什么时候不要使用。 - 参数 schema 是否足够严格:一个工具如果接受
any或一大段自由 JSON,模型就会把不确定性全部塞进参数里,后端很难判断。能枚举就枚举,能拆字段就拆字段,能写describe()就把示例写进去。 - 危险动作是否有确认环节:比如发邮件、删数据、扣款、发布生产配置、创建真实订单,都应该先有人类确认,或拆成「预览」和「提交」两步。模型可以建议动作,最终提交权应该留给人或确定性工作流。
Agent 循环需要退出条件
模型调用工具后,程序通常会把工具结果再交回模型,让模型继续判断。这个循环很自然,也必须有明确的退出条件。
一次 Agent 执行至少要有这些停止条件:
- 模型已经给出最终答案。
- 工具调用次数达到上限。
- 总耗时达到上限。
- 花费达到预算上限。
- 工具返回不可恢复错误。
- 命中需要人工确认的动作。
把这些限制写进运行时,比写进 prompt 更可靠。prompt 可以提醒模型「不要调用太多工具」,但真正的上限应该由程序控制。
type AgentRunOptions = {
  maxToolCalls: number;
  maxDurationMs: number;
};

async function runAgent(input: string, options: AgentRunOptions) {
  const startedAt = Date.now();
  let toolCalls = 0;

  while (true) {
    if (Date.now() - startedAt > options.maxDurationMs) {
      throw new Error('Agent run timed out');
    }

    if (toolCalls > options.maxToolCalls) {
      throw new Error('Too many tool calls');
    }

    // 这里省略一次模型调用、工具选择和工具结果回填。
    // 真实项目里可以交给 AI SDK / Agents SDK / LangGraph 这类运行时处理。
    toolCalls += 1;
  }
}
真实项目里可以把这个循环交给框架处理。AI SDK、OpenAI Agents SDK、LangGraph、Cloudflare Agents、Workflow SDK 都会提供不同层级的运行时支持。但无论框架怎么封装,你都要知道底下发生了什么:模型通过「判断 -> 调工具 -> 看结果 -> 再判断」逐步推进任务。
这个认识会影响很多工程决策。Agent 任务比普通模型调用更容易遇到供应商故障、限流和成本波动,因为一次用户请求可能触发多次模型调用和多次工具调用。这也是很多 Agent 教程会专门讲 fallback 的原因:Agent 每多走一步,就多一次失败机会。
fallback 和模型路由是生产能力
开发 demo 时,一个模型挂了,大不了刷新重试。生产 Agent 不一样。用户可能已经等了几十秒,Agent 也可能已经完成了几个工具步骤,最后一次模型调用失败会让整个任务显得不可靠。
Vercel AI Gateway 的价值之一,是把多模型路由、fallback、日志、费用和认证集中起来。它的 AI Gateway 文档 里也把统一凭据、请求日志、预算控制、provider fallback 和 model fallback 放在同一类运营能力里。
在应用代码里,fallback 最好集中成一层模型策略,用配置管理模型选择。
type ModelPolicy = {
  primary: string;
  fallbacks: string[];
};

const productionChatPolicy: ModelPolicy = {
  primary: process.env.CHAT_MODEL ?? 'openai/gpt-6-astra',
  fallbacks: [
    process.env.CHAT_FALLBACK_1 ?? 'anthropic/claude-fable-5.1',
    process.env.CHAT_FALLBACK_2 ?? 'google/gemini-3.8-flash',
  ],
};
如果用 Vercel Gateway,fallback 可以交给 gateway provider options;如果用 LiteLLM,也可以用它的 Router 或 Proxy Server 做 retry、fallback、budget 和日志。LiteLLM 的官方文档把它定位成统一调用 100+ LLM 的接口,并提供自托管 LLM Gateway、virtual keys、cost tracking 和 admin UI,这更适合想把网关掌握在自己基础设施里的团队。
选不选 gateway,可以按这几个问题判断:
- 是否要同时接多个模型供应商。
- 是否需要统一 key、日志、成本、限流和预算。
- 是否需要 provider outage 时自动 fallback。
- 是否希望业务代码尽量不感知供应商差异。
- 团队是否愿意维护自建代理、数据库、监控和升级。
只有一个 demo、一个模型、一个开发者时,直接调供应商 API 也可以。到了团队和生产流量,再补统一网关会更省心。
结构化输出是 Agent 的中间状态
很多 Agent 做不好,问题出在每一步都用自然语言传递状态。
比如用户说:「帮我看一下这个仓库为什么构建失败,能修就修,修不了就给我建议。」如果中间状态全是自然语言,程序很难知道 Agent 现在处于哪个阶段:是在收集信息、定位原因、生成补丁、运行测试,还是需要用户确认。
更稳的做法是让关键节点输出结构化状态。
import { z } from 'zod';

const DiagnosisSchema = z.object({
  status: z.enum(['need_more_context', 'root_cause_found', 'cannot_reproduce']),
  confidence: z.number().min(0).max(1),
  suspectedFiles: z.array(z.string()),
  nextAction: z.enum(['read_file', 'run_command', 'propose_patch', 'ask_user']),
  explanation: z.string(),
});
这个 schema 面向程序控制流程,不直接展示给用户。它让程序能做几件事:
nextAction是run_command时,检查命令是否在允许列表里。confidence太低时,可以触发人工复核,但高分本身不能授权改文件。suspectedFiles超出工作区时,直接拒绝。ask_user出现时,把问题抛给人,而不是让 Agent 继续猜。
结构化输出尤其适合这些场景:
- 从邮件、需求、日志里提取任务。
- 判断工具调用下一步。
- 生成执行计划。
- 输出风险等级。
- 把 Agent 结果交给另一个系统继续处理。
自然语言适合沟通,结构化对象适合控制流程。Agent 开发要把这两种输出分开。
schema 能保证字段形状,不能证明内容真实。confidence 和模型填写的风险等级都只是建议;资源归属、动作权限和审批状态必须由可信业务数据与确定性策略检查。工具返回的网页、文档和日志也应当作资料,不应因为混进一句命令就获得新的执行权限。
执行模型生成的代码要隔离
能力更强的 Agent 很快会遇到一个诱惑:让模型写一段代码,然后直接运行。
这在数据处理、代码修复、测试生成、脚本编写里都很常见。问题是,模型生成的代码不可信。它可能死循环,可能读敏感文件,可能访问不该访问的网络,可能删文件,也可能只是单纯写错了。
Vercel 原文用 Vercel Sandbox 处理这件事。它给 Agent 一个隔离环境运行代码,原文还提醒一次性执行时要关闭持久化,避免不需要的文件系统快照继续计费。
如果不用 Vercel,也要有同样的安全边界。按复杂度从低到高,可以有几种做法:
- 不执行代码,只生成补丁:适合文档、简单脚本、人工 review 后再跑的任务,代价是自动化程度低。
- 本地 Docker 容器:适合内部开发、低风险 demo、离线数据处理,隔离强度和资源限制要自己配。
- gVisor / Firecracker / Kata Containers:适合多租户、外部输入、不可信代码,基础设施会明显复杂一些。
- Vercel Sandbox / OpenAI-hosted sandbox / Cloud sandbox:适合希望少维护隔离层的团队,平台绑定、价格和权限要提前评估。
- 自建临时工作区 + allowlist 命令:适合 Coding Agent 和内部仓库修复,文件范围和可执行命令必须限制得很严。
最小安全原则是:模型可以生成代码,但不能直接在生产环境里执行它。
临时目录和命令 allowlist 不是独立沙箱。允许 node script.mjs 或 pnpm test,仍然可能执行任意项目代码;这些代码能碰到什么文件、网络和凭据,要由容器或其他隔离层限制。不要把宿主机密钥、Docker socket 或不必要的可写目录交进去。
一个自建版本可以先做得很朴素:
- 每次任务创建临时目录。
- 只挂载必要输入文件。
- 容器禁用或限制网络。
- 设置 CPU、内存、磁盘和超时。
- 命令使用 allowlist,比如只允许
node script.mjs、python main.py、pnpm test。 - stdout、stderr、exit code 全部记录下来。
- 任务结束后销毁工作区。
这种方案比平台沙箱麻烦,但思路完全相同:prompt 只能提醒模型不要做危险事,隔离环境才是最后的安全边界。
第三方 API 要用短期授权
一个 Agent 如果只能查公开资料,权限问题还不明显。只要它开始帮用户做事,比如发 Slack 消息、建 GitHub PR、查数据仓库、更新 Notion、提交 Jira issue,权限就变成主问题。
最粗糙的做法是把长期 API key 放进环境变量,让 Agent 的工具函数随便用。这能跑,但风险很大:
- key 长期有效,泄露后影响大。
- key 往往代表整个应用或团队,不容易按用户隔离。
- 很难给不同工具分不同 scope。
- 撤销、审计和审批都麻烦。
Vercel 原文用 Vercel Connect 处理第三方 API 授权。它的思路是运行时申请短期 token,并区分「代表应用」和「代表用户」两类身份。即使团队不用 Vercel Connect,这条原则也很通用:Agent 调外部服务时,权限应该短期、可撤销、可审计、可按 scope 限制。
长期服务凭据放在后端环境变量里本身不是错误,问题是权限过宽或被模型直接接触。凭据应留在服务端工具执行层,模型只提交业务参数;短期 token 和 refresh token 同样不能放进 prompt、普通工具结果或日志。撤销与用户退出后的行为也要验证。
自建时可以按这套结构设计:
用户授权第三方服务
    ↓
应用保存 refresh token 或托管连接信息
    ↓
Agent 工具请求短期 access token
    ↓
工具用短期 token 调第三方 API
    ↓
日志记录调用人、工具、scope、资源 ID 和结果
权限模型里还要区分几种动作:
- 只读:查资料、读 issue、搜索消息。
- 可撤销写入:发草稿、加评论、创建待确认任务。
- 不可逆或高风险写入:删除数据、扣款、发布、邀请外部用户、改权限。
只读工具可以自动化程度高一点。可撤销写入可以用审批或预览。不可逆动作默认要有人类确认,最好还要有二次校验和审计日志。
Agent 的权限设计越早把 scope、subject、approval 和 audit log 放进去,后面越容易扩展。
长任务要能恢复
短聊天接口可以靠一次 HTTP 请求完成。真实 Agent 经常不行。
比如这些任务都可能超过单个请求的生命周期:
- 读十几个接口文档,整理迁移方案。
- 搜索代码、修改文件、运行测试、根据失败继续修。
- 订机票、等用户确认、再执行下一步。
- 调多个外部 API,任何一个失败都要重试。
- 后台研究任务跑半小时,中间用户刷新页面。
如果所有状态都在内存里,进程重启、函数超时、用户断开连接都会让任务丢掉。Vercel 原文把这部分交给 Workflow SDK 和 WorkflowAgent:工具调用变成可持久化步骤,失败后从 checkpoint 继续,需要人工审批时可以暂停。
不使用 Vercel 时,也要解决同一个问题。常见方案有三类。
第一类是用 Agent 框架自己的持久化能力。LangGraph 的官方概览把它定位成用于长时间、带状态 Agent 的低层编排框架,强调 durable execution、human-in-the-loop、streaming 和 persistence。它适合把 Agent 写成图:哪些步骤确定执行,哪些步骤交给模型,哪些地方允许人工介入。
第二类是用平台原生的有状态运行时。Cloudflare Agents 的官方文档把 Agent 建在 Durable Objects 上,每个 Agent 实例像一个有身份的微型服务,可以保存状态、处理 WebSocket、调度任务,并在客户端断开后继续让用户回到同一个实例。它适合边缘网络、实时连接和每个用户 / 会话一个有状态 Agent 的场景。
第三类是用通用工作流引擎托住 Agent。Temporal 的文档把 durable execution 解释成应用在崩溃、网络失败或长时间等待后能恢复到原来的进度。把 Agent 的 LLM 调用和工具调用拆成 workflow activity,可以得到重试、幂等、信号、人工等待和可观测性。代价是架构更重,适合已经有工作流复杂度的团队。
哪一种更好,要看任务形态。
- 一次聊天里只调用一两个只读工具,用普通 HTTP route + in-memory loop 就能起步。
- 复杂状态机里同时有确定步骤和模型步骤,LangGraph 更自然。
- 每个用户 / 会话需要一个长期在线状态体,可以看 Cloudflare Agents / Durable Objects。
- 多天流程、审批、重试和强审计,更适合 Temporal、Vercel Workflow 或类似工作流引擎。
- 简单后台任务如果失败重跑也能接受,Queue + 数据库状态通常就够用。
长任务的核心是把每一步的输入、输出、副作用和恢复点记录下来。没有这层记录,Agent 看起来能跑很久,实际很脆。
持久化不等于副作用只执行一次。如果退款已经成功,进程却在写入 checkpoint 前中断,恢复后可能再次调用退款工具。幂等键、已提交结果查询和必要的补偿,要由业务接口与工作流共同实现;不能只因为框架支持重试就假定不会重复扣款。
把最小项目跑起来
前面已经看过 generateText、streamText、generateObject、tool、退出条件、fallback 和长任务恢复这些能力。现在把它们放进一个能在本地打开的最小项目里。
下面这个项目沿用客服售后场景,但不引入 Next.js。它用 Hono 搭一个 Node.js HTTP 服务,首页是一段很薄的 Web UI,浏览器把客服输入发到 /api/agent,后端再用 Vercel AI SDK 调模型和本地工具。这样读者能同时看到 Web UI、HTTP 接口、模型调用和工具调用循环。
完整源码放在文章配套资源里:/files/agent-development-from-vercel-ai-gateway-guide/kits/vercel-ai-sdk-minimal-agent/。源码索引看 FILES.json,运行说明看 README.md。
本地运行需要四样东西:
- Node.js 22+。
- pnpm。
- 一个本地 OpenAI-compatible 模型服务。
- 一个支持 tool calling 的本地模型。
本地模型服务可以用 LM Studio,也可以用 Ollama 的 OpenAI-compatible endpoint。LM Studio 的 Local Server 常见地址是 http://localhost:1234/v1;Ollama 的 OpenAI-compatible endpoint 常见地址是 http://localhost:11434/v1。模型 ID 以本机实际加载的模型为准。
这里的「本地」指浏览器访问 localhost,本地 Hono 服务读取 .env,再把模型请求发给本机模型服务。它不需要先注册 Vercel,也不需要部署。代价是本机要能跑得动模型,并且模型要支持工具调用;如果模型不支持 tool calling,这个 demo 的 HTTP 服务仍然能启动,但 Agent 可能不会按预期调用工具。
真正要上线给别人使用时,再考虑 Vercel Functions、Docker、VPS 或其他部署方式;真正要统一管理多模型、key、日志和 fallback 时,再考虑 Vercel AI Gateway、LiteLLM 或 OpenRouter 这类网关。
pnpm install
cp .env.example .env
Windows PowerShell 里复制环境变量文件可以写成:
Copy-Item .env.example .env然后编辑 .env:
LOCAL_LLM_BASE_URL=http://localhost:1234/v1
LOCAL_LLM_API_KEY=local
LOCAL_LLM_MODEL=你的本地模型 ID
PORT=3333
启动服务:
pnpm dev打开 http://localhost:3333,输入这类问题:
客户说 ORD-2026-0001 的耳机已经签收,想退款。请判断是否符合规则,并写一段给客户的回复。这个项目的请求链路很短:
- 浏览器页面调用
fetch('/api/agent')。 - Hono route 校验
message,再调用runSupportAgent(message)。 runSupportAgent调generateText,把客服任务、系统指令和工具列表交给模型。- 模型需要订单或退款规则时,AI SDK 按工具 schema 生成调用参数,后端执行
getOrder、listRefundPolicy或createReplyChecklist。 stopWhen: isStepCount(5)允许模型在一次请求里多走几步:调用工具、读取结果、继续判断,直到给出最终回复或达到步数上限。- 后端把最终回答和工具调用过程返回给页面,客服能看到回复草稿,也能看到 Agent 用过哪些工具。
这个 demo 没有安装 @ai-sdk/react 这类 UI 包,因为它的前端只需要一个原生页面和一次 fetch。如果项目已经是 React、Vue、Svelte 或 Angular,再把页面层换成对应 UI 包;后端的 runSupportAgent(message)、工具定义和密钥边界不需要跟着改。
Vercel 在这条链路里的位置
跑通本地 demo 以后,再回头看 Vercel 这套产品会更清楚:本地项目需要的是一个 HTTP 入口、一个模型入口和一段 Agent 逻辑;Vercel 提供的是其中一些工程位置的托管版本,不是 Agent 唯一能运行的地方。
AI Gateway 是模型入口层。应用把模型 ID、prompt、工具调用请求发给 Gateway,Gateway 处理凭据、路由、日志、预算和 fallback,再把请求转给 OpenAI、Anthropic、Google、阿里云、DeepSeek 或其他模型提供方。真正生成 token 的仍然是模型提供方;Gateway 解决的是入口统一、凭据托管和观测治理。Agent 可以直连模型厂商,也可以从本地代码调用 AI Gateway,还可以换成 OpenRouter、LiteLLM 或自建 OpenAI-compatible proxy。
Vercel Functions 是线上 HTTP 入口:接收请求,读取环境变量,访问数据库和内部 API,再调用 AI SDK。它的定位接近普通 API route / serverless function;本地 Node.js、Next.js dev server、Express / Hono 服务也能做同样的事。上线到别处时,这个入口可以放进 AWS Lambda、Cloudflare Workers、Docker、Kubernetes 或普通 VPS。
客服售后这种任务通常不止一轮模型请求。查订单、查支付、读退款政策这些动作,可以在 AI SDK 里分别定义成 tools;需要第三方账号或 MCP 工具时,可以用 Vercel Connect 处理 OAuth 授权、用户同意和短期凭据;任务要等待人工确认、跨部署恢复或失败重试时,可以交给 Vercel Workflows;如果 Agent 要执行模型生成的脚本、跑测试或处理文件,就放进 Vercel Sandbox 这类隔离环境。
下图展示 Vercel 这套工具在客服售后 Agent 里的主链路:
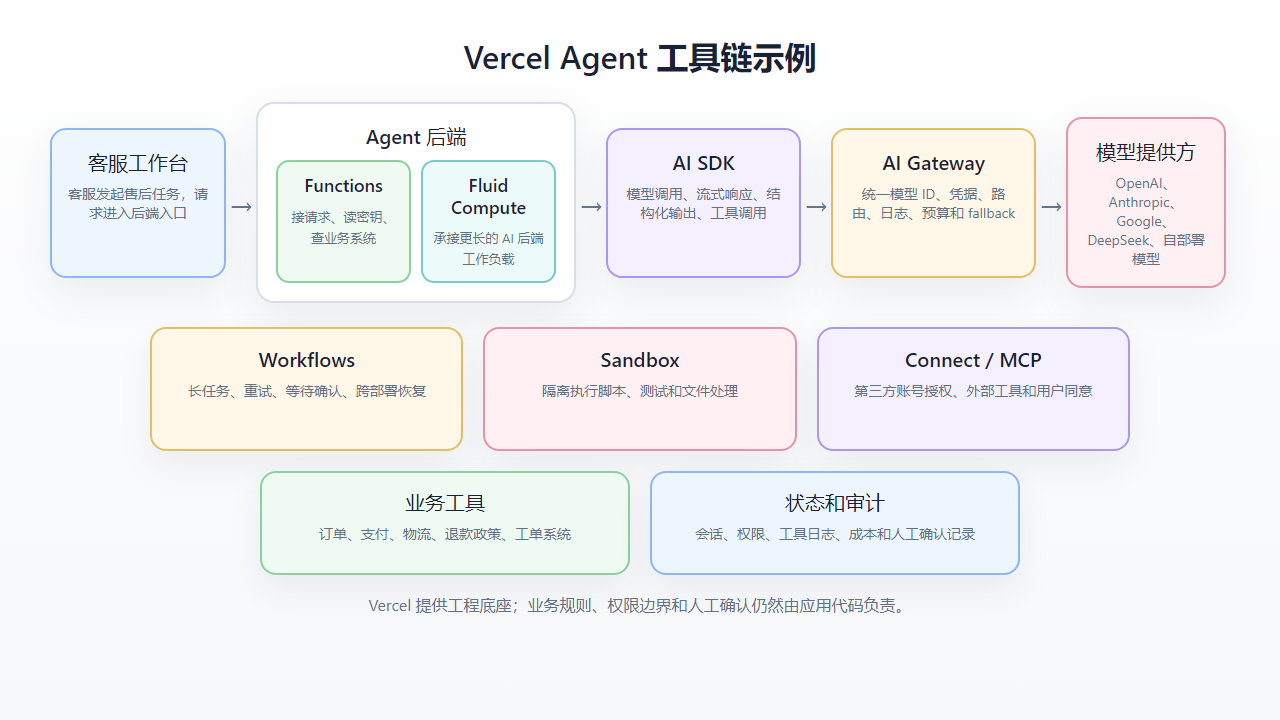
从这条链路可以看出,Vercel 提供的是一组工程位置:AI SDK 写调用和工具,AI Gateway 管模型入口,Functions / Fluid Compute 跑后端,Workflows 管长任务,Sandbox 管隔离执行,Connect / MCP 管外部工具授权。业务上真正要查什么订单、什么动作需要人工确认、什么日志必须落库,仍然要由你的应用代码决定。
模型 token 怎么付费,取决于你接入模型的方式:
- 直接调模型提供方:你自己去 OpenAI、Anthropic、阿里云、DeepSeek 等平台申请 API key,放在后端环境变量里,费用也由对应模型提供方收取。这个方案适合只接一两家模型、暂时不需要统一网关的项目。
- 用 Vercel AI Gateway 的系统凭据:你在 Vercel 创建
AI_GATEWAY_API_KEY,或者应用部署在 Vercel 上时用 OIDC token;Gateway 再用它自己的系统凭据调用上游提供方。Vercel 文档说这条路按上游 provider list price 计价,不加 markup,并且提供 Free Tier / free credits;free credits 会从第一次 Gateway 请求开始计算,本地请求和线上请求都属于 Gateway 请求。 - BYOK,也就是 Bring Your Own Key:你把自己的 provider key 配到 Vercel team,或按请求传给 Gateway。成功走 BYOK 时,通常按你和模型提供方的合同 / 账户计费;Vercel 不额外加 token markup。需要注意:如果 BYOK 失败并 fallback 到系统凭据,会消耗 Vercel Gateway credits。
BYOK 这条路尤其要写进团队的成本说明:provider 侧会产生费用,Gateway fallback 也可能产生费用,预算和告警要同时覆盖这两边。
从 demo 到生产要补哪些东西
最小项目已经跑通了 Web UI、HTTP 接口、模型调用、工具调用和工具步骤展示。接入真实客服系统时,还要用工程护栏约束这些能力;给 prompt 加几句「请谨慎」并不足够。
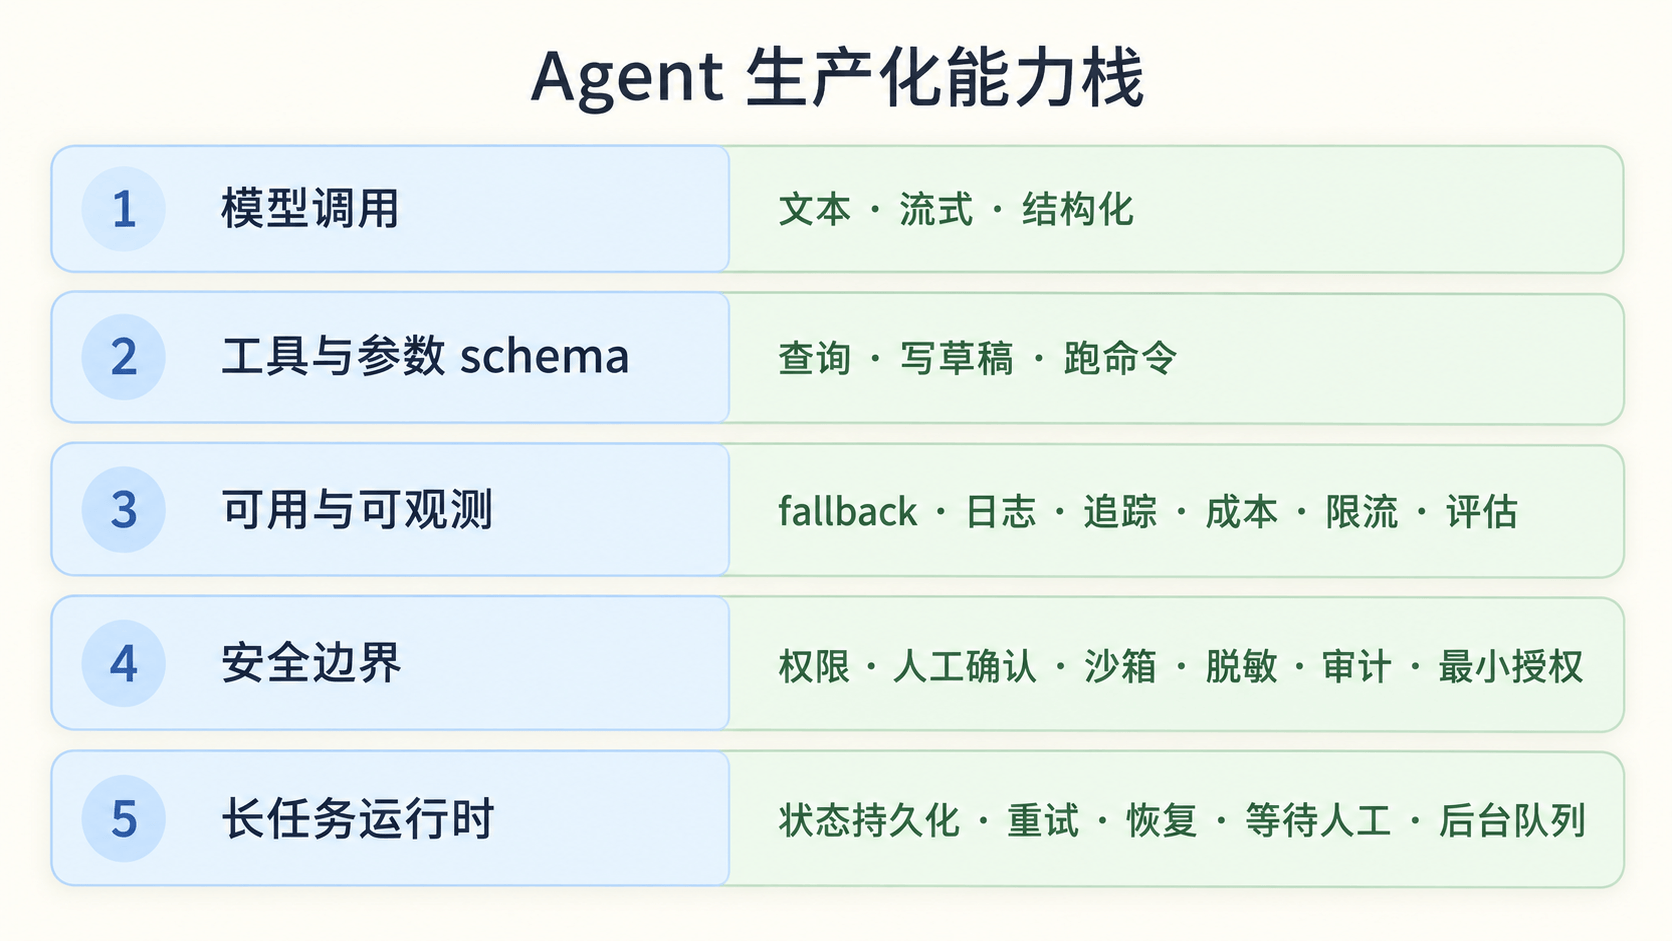
生产化的本质,是把几类不确定性圈起来:
- 模型不确定:它可能理解错、输出格式错、选择错工具。
- 工具不确定:外部 API 会超时、限流、返回脏数据,工具本身也可能有 bug。
- 权限不确定:同一个用户在不同组织、项目和资源上的权限不同。
- 任务不确定:长任务会中断,用户会刷新页面,进程会重启,后台任务会失败。
- 成本不确定:一次 Agent run 可能包含多次模型调用、工具调用和沙箱运行。
prompt 可以减少一部分不确定性,但不能替代工程控制。下面这些能力,就是把不确定性变成可观察、可限制、可恢复的系统行为。
日志和追踪
每次 Agent run 至少记录这些信息:
- run id。
- 用户或会话 id。
- 模型、provider、fallback 命中情况。
- prompt 版本。
- 工具调用名称、参数摘要、执行结果、耗时。
- token 和费用。
- 最终状态:成功、失败、等待人工、超时、取消。
不要把敏感参数、完整用户数据和 token 明文写进日志。工具参数可以做摘要或脱敏。追踪的目标是复盘行为,不是复制一份用户隐私。
工具权限
每个工具都要标出风险等级:
read:不修改业务状态;通过数据权限、隐私和成本检查后,才可以自动调用。draft:生成草稿,不产生外部副作用。write_requires_approval:写操作,需要人工确认。dangerous:高风险动作,只允许在后台受控流程里执行,默认不给普通 Agent。
工具权限最好写成代码配置,并在文档里同步解释。
type ToolRisk = 'read' | 'draft' | 'write_requires_approval' | 'dangerous';

type ToolPolicy = {
  risk: ToolRisk;
  allowedRoles: string[];
  timeoutMs: number;
};

const toolPolicies: Record<string, ToolPolicy> = {
  getOrderStatus: {
    risk: 'read',
    allowedRoles: ['support', 'admin'],
    timeoutMs: 5_000,
  },
  draftRefundRequest: {
    risk: 'draft',
    allowedRoles: ['support', 'admin'],
    timeoutMs: 5_000,
  },
};
测试和评估
Agent 的测试至少要覆盖几类样例:
- 正常请求:能调用正确工具。
- 缺少参数:会追问,不会乱猜。
- 高风险请求:只生成草稿或要求确认。
- 工具失败:能解释失败,不会假装成功。
- 恶意输入:不会泄露 system prompt,不会越权调用工具。
- 成本边界:不会无限循环调用工具。
最初可以用一组固定输入做回归测试。等流量变大,再引入离线评估、真实会话抽样、人工标注和自动 grader。
成本控制
Agent 的成本来自模型调用、工具调用、外部 API、沙箱运行、存储和日志。生产系统要设置几层预算:
- 单次 run 最大 token。
- 单次 run 最大工具次数。
- 单用户每日预算。
- 单项目 / 单团队预算。
- provider fallback 的成本上限。
- 沙箱运行时长和快照存储上限。
Vercel Gateway、LiteLLM 这类网关能集中处理一部分成本和预算。自建时,就要在数据库里记录 run 级别成本,并在调用前检查余额或限额。
人工介入
有些任务更适合保留人工确认。更好的体验是让 Agent 准备好材料,再交给人确认:
- 发邮件前生成邮件草稿。
- 建 PR 前生成 diff 和说明。
- 退款前生成申请单。
- 发布前生成 release checklist。
- 删除数据前列出受影响对象和回滚方案。
人类确认属于 Agent 产品的一部分。高风险动作越多,审批状态、超时恢复和审计日志越重要。
不用 Vercel 时怎么搭
不用 Vercel 时,可以按工程职责寻找对应能力:
- AI SDK 解决模型调用、stream、工具和结构化输出。可替代方案包括 OpenAI SDK、Anthropic SDK、LangChain、LlamaIndex,或者自写 provider adapter。
- AI Gateway 解决多模型路由、fallback、日志、成本和统一凭据。可替代方案包括 LiteLLM、OpenRouter 和自建 OpenAI-compatible proxy。
- Sandbox 解决不可信代码隔离执行。可替代方案包括 Docker、gVisor、Firecracker、Kubernetes Job 和 OpenAI-hosted sandbox。
- Chat SDK 解决 Slack / Teams / Discord 等平台接入。可替代方案包括 Botkit、Bolt for Slack、Microsoft Bot Framework 和各平台 SDK。
- Connect 解决第三方 API 授权和短期 token。可替代方案包括自建 OAuth 2.0、WorkOS、Auth0 和自建 connector 服务。
- Workflow SDK 解决长任务持久化、重试和人工等待。可替代方案包括 Temporal、LangGraph checkpointer、Cloudflare Workflows、BullMQ + 数据库状态。
如果团队想完全自建,一个可落地的架构可以是:
Web / Slack / API
    ↓
Agent API Server
    ↓
Agent Runtime
    ├─ Model Gateway(LiteLLM 或自建 proxy)
    ├─ Tool Registry(工具定义、权限、schema)
    ├─ State Store(Postgres / Redis)
    ├─ Job Queue(BullMQ / SQS / Cloud Tasks)
    ├─ Sandbox Runner(Docker / gVisor / Firecracker)
    └─ Observability(logs / traces / evals / cost)
最小版本可以更简单:
- 一个 API Server。
- 一个模型供应商。
- 几个只读工具。
- Postgres 记录会话和 run。
- 队列跑长任务。
- Docker 跑不可信代码。
- 后台页面看日志、工具调用和成本。
先做小,等边界清楚后再扩展平台能力。Agent 系统真正难的是边界,不是目录结构。
平台怎么选
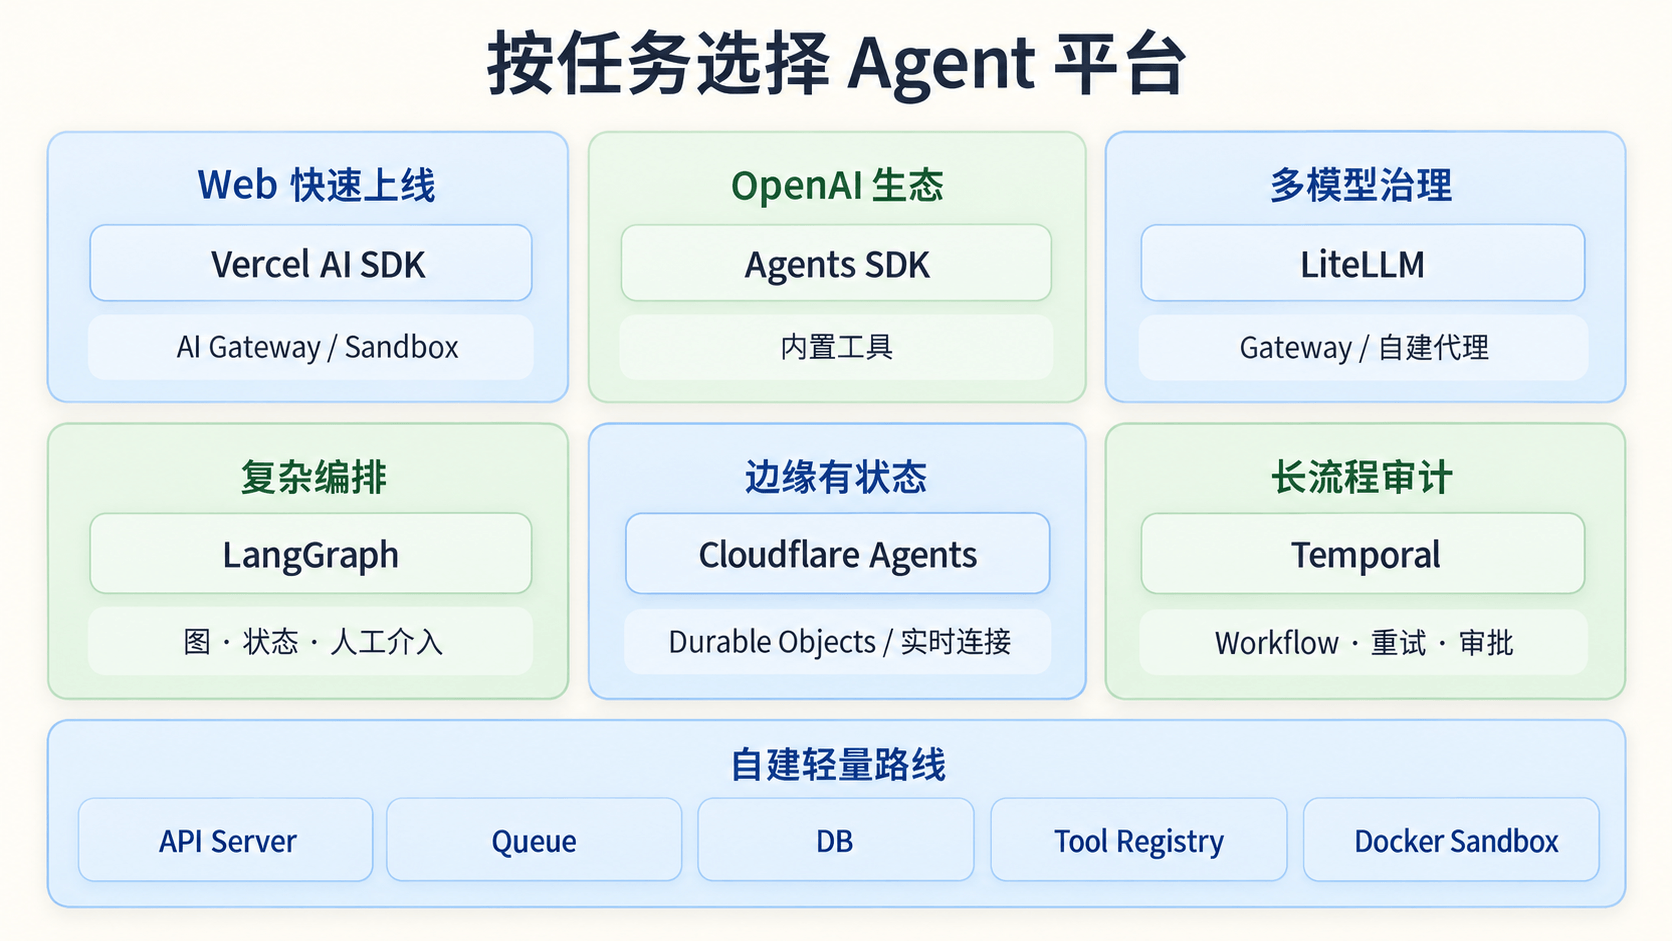
如果你要尽快把 Web 产品里的 Agent 做出来,Vercel 的路线很顺。Next.js、AI SDK、AI Gateway、Sandbox、Workflow 放在一起,开发体验好,前端团队上手成本低。代价是平台能力和价格要跟 Vercel 绑定一部分,尤其是 Sandbox、Connect、Workflow 这些运行时能力。
如果你主要用 OpenAI,并且想在 TypeScript 或 Python 里用 code-first 的方式组织 Agent,可以看 OpenAI Agents SDK。官方文档把它定位成在代码里构建 Agent,支持工具、其他 Agent、跨步骤上下文,以及 tracing、guardrails、handoffs 等能力。它适合应用服务器自己掌握工具实现、状态存储和审批逻辑的场景。
复杂状态机里同时存在确定步骤和模型判断时,LangGraph 更合适。它的强项是把 Agent 编排成图,把确定性逻辑和 LLM 步骤混在同一个可持久化流程里。
如果你已经在 Cloudflare 上,或者想让每个用户 / 会话有自己的有状态 Agent,Cloudflare Agents 很有吸引力。它依赖 Durable Objects,适合 WebSocket、边缘部署、状态同步和长连接体验。
如果你最关心自建模型网关、统一 key、预算和 provider 路由,LiteLLM 是很现实的选择。它可以作为库用,也可以跑成自托管 proxy。它不替你写完整 Agent,但能把多供应商调用这一层统一掉。
如果你的企业里已经有 Temporal,或者任务天然是多天、多步骤、审批、重试和审计,Temporal 可以做 Agent 背后的流程脊梁。Agent 也可以只是 workflow 里的一个 activity,由工作流系统负责整体控制。
所以,你可以用 Vercel 的平台跟着做,也可以把同样的思路搬到 OpenAI Agents SDK、LangGraph、Cloudflare Agents、LiteLLM + Temporal,甚至自己搭一套轻量运行时里。
如果项目有国内合规、数据留境、采购流程或云厂商绑定要求,也可以优先看国产平台。它们和 Vercel 的定位可能不同,但都在解决「模型、工具、知识库、工作流、权限、发布」这些 Agent 落地问题:
- 阿里云百炼 Model Studio:提供智能体和工作流两类应用构建方式,能接知识库、外部工具、记忆和 MCP 服务。适合企业知识问答、任务助理、固定流程自动化和阿里云体系内集成。
- 百度千帆·大模型服务及 Agent 开发平台:围绕 Agent 引擎、工具及 MCP、模型服务和企业级服务搭能力底座。适合已经在百度智能云、搜索、知识库或企业 AI 服务上投入较多的团队。
- 火山方舟 Managed Agents / Agent Plan:控制台可以配置模型、系统提示词、Skills、Tools、MCP 和 Multi Agents,也有 AgentKit 这类更工程化的基础设施。适合要把工具执行、MCP、代码类任务和多 Agent 协作接到业务里的团队。
- 腾讯云智能体开发平台 ADP:提供 LLM + RAG、Workflow、Multi-agent、知识库、插件广场、连接器与工具。适合企业知识库、业务流程、腾讯云生态和低代码智能体应用。
- 华为云 AI 原生应用引擎 / AgentArts:强调 Agent 编排、工作流、数据连接、知识库、MCP 和企业云资源协同。适合政企、工业、云上数据治理要求较强的场景。
- 智谱 AI 智能体开发平台:提供画布式节点、Agent 节点、LLM 节点、知识库、联网搜索、代码节点、工具节点和插件中心。适合 GLM 体系、低代码智能体、知识问答和需要批量调试的业务应用。
- Kimi API 开放平台:提供文本生成、多轮对话、文件解析、联网搜索等能力,兼容 OpenAI API 格式。适合长文档、文件解析、知识工作和希望低成本迁移 OpenAI 风格接口的团队。
- MiniMax 开放平台:覆盖文本、多轮对话、语音、视频、图片、音乐、音色管理等能力。它更偏多模态能力平台,适合语音客服、内容生成、视频 Agent 和需要音视频能力的产品。
如果只能先学一条路线,我建议从「普通 HTTP route + AI SDK / OpenAI SDK + 两三个工具 + 数据库记录 run」开始。这个组合最容易看清 Agent 的核心机制:模型怎么选择工具,工具结果怎么回到模型,权限和人工确认怎么插进去。等你真的遇到长任务、复杂图编排或多模型治理,再引入 LangGraph、Temporal、LiteLLM 或 Vercel Gateway 这类基础设施,会比一开始就堆全家桶稳很多。
一个简单选型口径是:
- 个人 demo / 小产品:AI SDK 或 OpenAI SDK 直接起步。
- Next.js 产品快速上线:Vercel AI SDK + AI Gateway,按需加 Sandbox 和 Workflow。
- 多模型、多团队统一治理:LiteLLM 或 Vercel AI Gateway。
- 复杂 Agent 编排:LangGraph。
- 边缘、有状态、实时连接:Cloudflare Agents。
- 长流程和强审计:Temporal 或 Vercel Workflow。
- 强 OpenAI 生态和内置工具:OpenAI Agents SDK / Agents API。
先问你的任务最怕什么:模型供应商失败、工具越权、长任务丢状态、代码执行不安全、成本不可控,还是用户体验不实时。最怕的问题不同,平台选择就会不同。
新手最容易低估的几个边界
- 工具命名:工具清楚比工具数量更重要。一个 Agent 有二十个描述含糊的工具,会比只有五个清楚工具更不稳定。优先做好最常用、最安全、最容易验收的工具。
- 上下文:把所有文档、日志、历史消息都塞给模型,不等于让它更懂。Agent 的上下文应该像工程输入一样被整理:当前目标、可用工具、必要历史、关键约束和最近结果。旧结果要总结,长材料要检索,敏感数据要脱敏。
- 副作用:只读工具和写工具应该分开。写工具里,草稿、可撤销动作和不可逆动作也要分开。不要让「创建草稿」和「正式提交」共用同一个模糊工具。
- 模型切换:多模型 fallback 能提高可用性,但不同模型的工具调用风格、结构化输出稳定性、上下文长度和成本都不一样。fallback 会带来行为差异,要用测试样例验证。
- prompt 版本:Agent 行为高度依赖 system prompt 和工具描述。生产系统要给 prompt 版本号,并记录每次 run 用的是哪个版本。否则线上问题很难复盘。
- 评估:Agent 要有固定测试集,覆盖正常、缺参数、拒绝、工具失败、权限、越权、长任务和成本边界,不能只看一两次 demo 成功。
- 安全:prompt injection、工具越权、数据泄露、代码执行和供应链风险都是真问题。只要 Agent 能访问外部系统,就要从第一版开始设计最小权限和审计。
第一次实现,可以先让客服助手可靠完成「查订单并生成草稿」,暂不提供退款提交工具。这个范围足够验证工具选择、真实数据权限、失败提示和回复质量。等它确实需要执行写操作或跨请求等待时,再加审批和持久化;选择平台,也从这些已经出现的需求出发。